Durable harness 保什么、保不住什么:以 Pi Durable 为中心的对照
多数 coding agent 默认有人盯着终端:进程挂了,人看一眼现场,再点继续。Earendil 随 Pi 1.0 放出的 Pi Durable 把场景换成另一类:Slack 值班 bot、过夜调查、支持工作区里多人同时追问。这时没人坐在终端前,会话必须自己跨过崩溃、滚动部署和客户端掉线,还得能跑在任意有 JavaScript 运行时的地方。实现上它是一套约 15,000 行(不含测试)的实验性 harness 库,把存储、任务检查点、工具重放策略、会话分叉、应用文档和多客户端观察放在同一条原子提交线上。[1]
站内谈过 环境可辨识、Claude Code harness、Strands 生产运行时 和 Exactly-once 落点。读完那些文以后,下一个问题往往是:进度丢了靠检查点,双写靠契约,那 Pi Durable 和 Temporal、Durable Objects、LangGraph checkpointer 各自守哪一层?
Earendil:Pi Durable 与 Pi 1.0 同日发布,面向可在任意 JS 运行时上恢复的 agent 会话。[1]
Harness 在这里指什么
Pi 把 harness 写得很硬:存储,加上并行跑一场或多场大模型对话所需的机械装置,以及模型要调的工具和工具所在的执行环境。[1]
一场对话会留下按时间排列的对话记录(Pi 文档里叫 transcript)。Agent 则是模型、设置与可用工具的组合,工具再通过执行环境去碰文件或 shell。Harness 跑的每一步,无论是模型请求、工具调用还是你自己写的状态机,都被当成一个任务(task)来调度。这样一来,崩溃恢复就有了明确的单位:不是「大概记得模型说过什么」,而是「哪个任务停在哪个检查点」。[1]
职责也因此和终端里的 Pi coding agent 分开。两边共享 pi-ai 与「最小、可塑」的原则,但 coding agent 服务的是一个人、一台机器、一个终端;Durable 服务的是任意表面、可能很长的会话,以及多人对同一 agent 同时下手。[1] 想像一个支持工作区:主通道在查部署失败,旁边有人开线程问能不能回滚。若两场对话都活在进程内存里,容器一滚就全没了。Durable 要保住的,正是这类跨进程的会话状态。
npm 上的 @earendil-works/pi-durable(撰写时 1.3.0)把契约说成一句话:会话、模型轮次、工具调用与应用状态先提交到存储,再展示给客户端。进程中途死掉时,重新打开同一存储就能从断点接上。包标明 Experimental,API 还会变。[2] 源码大约 15,000 行,刻意保持可读,是为了让 agent 自己也能改 harness;扩展时存储后端那约 3,000 行常常可以跳过。[1]
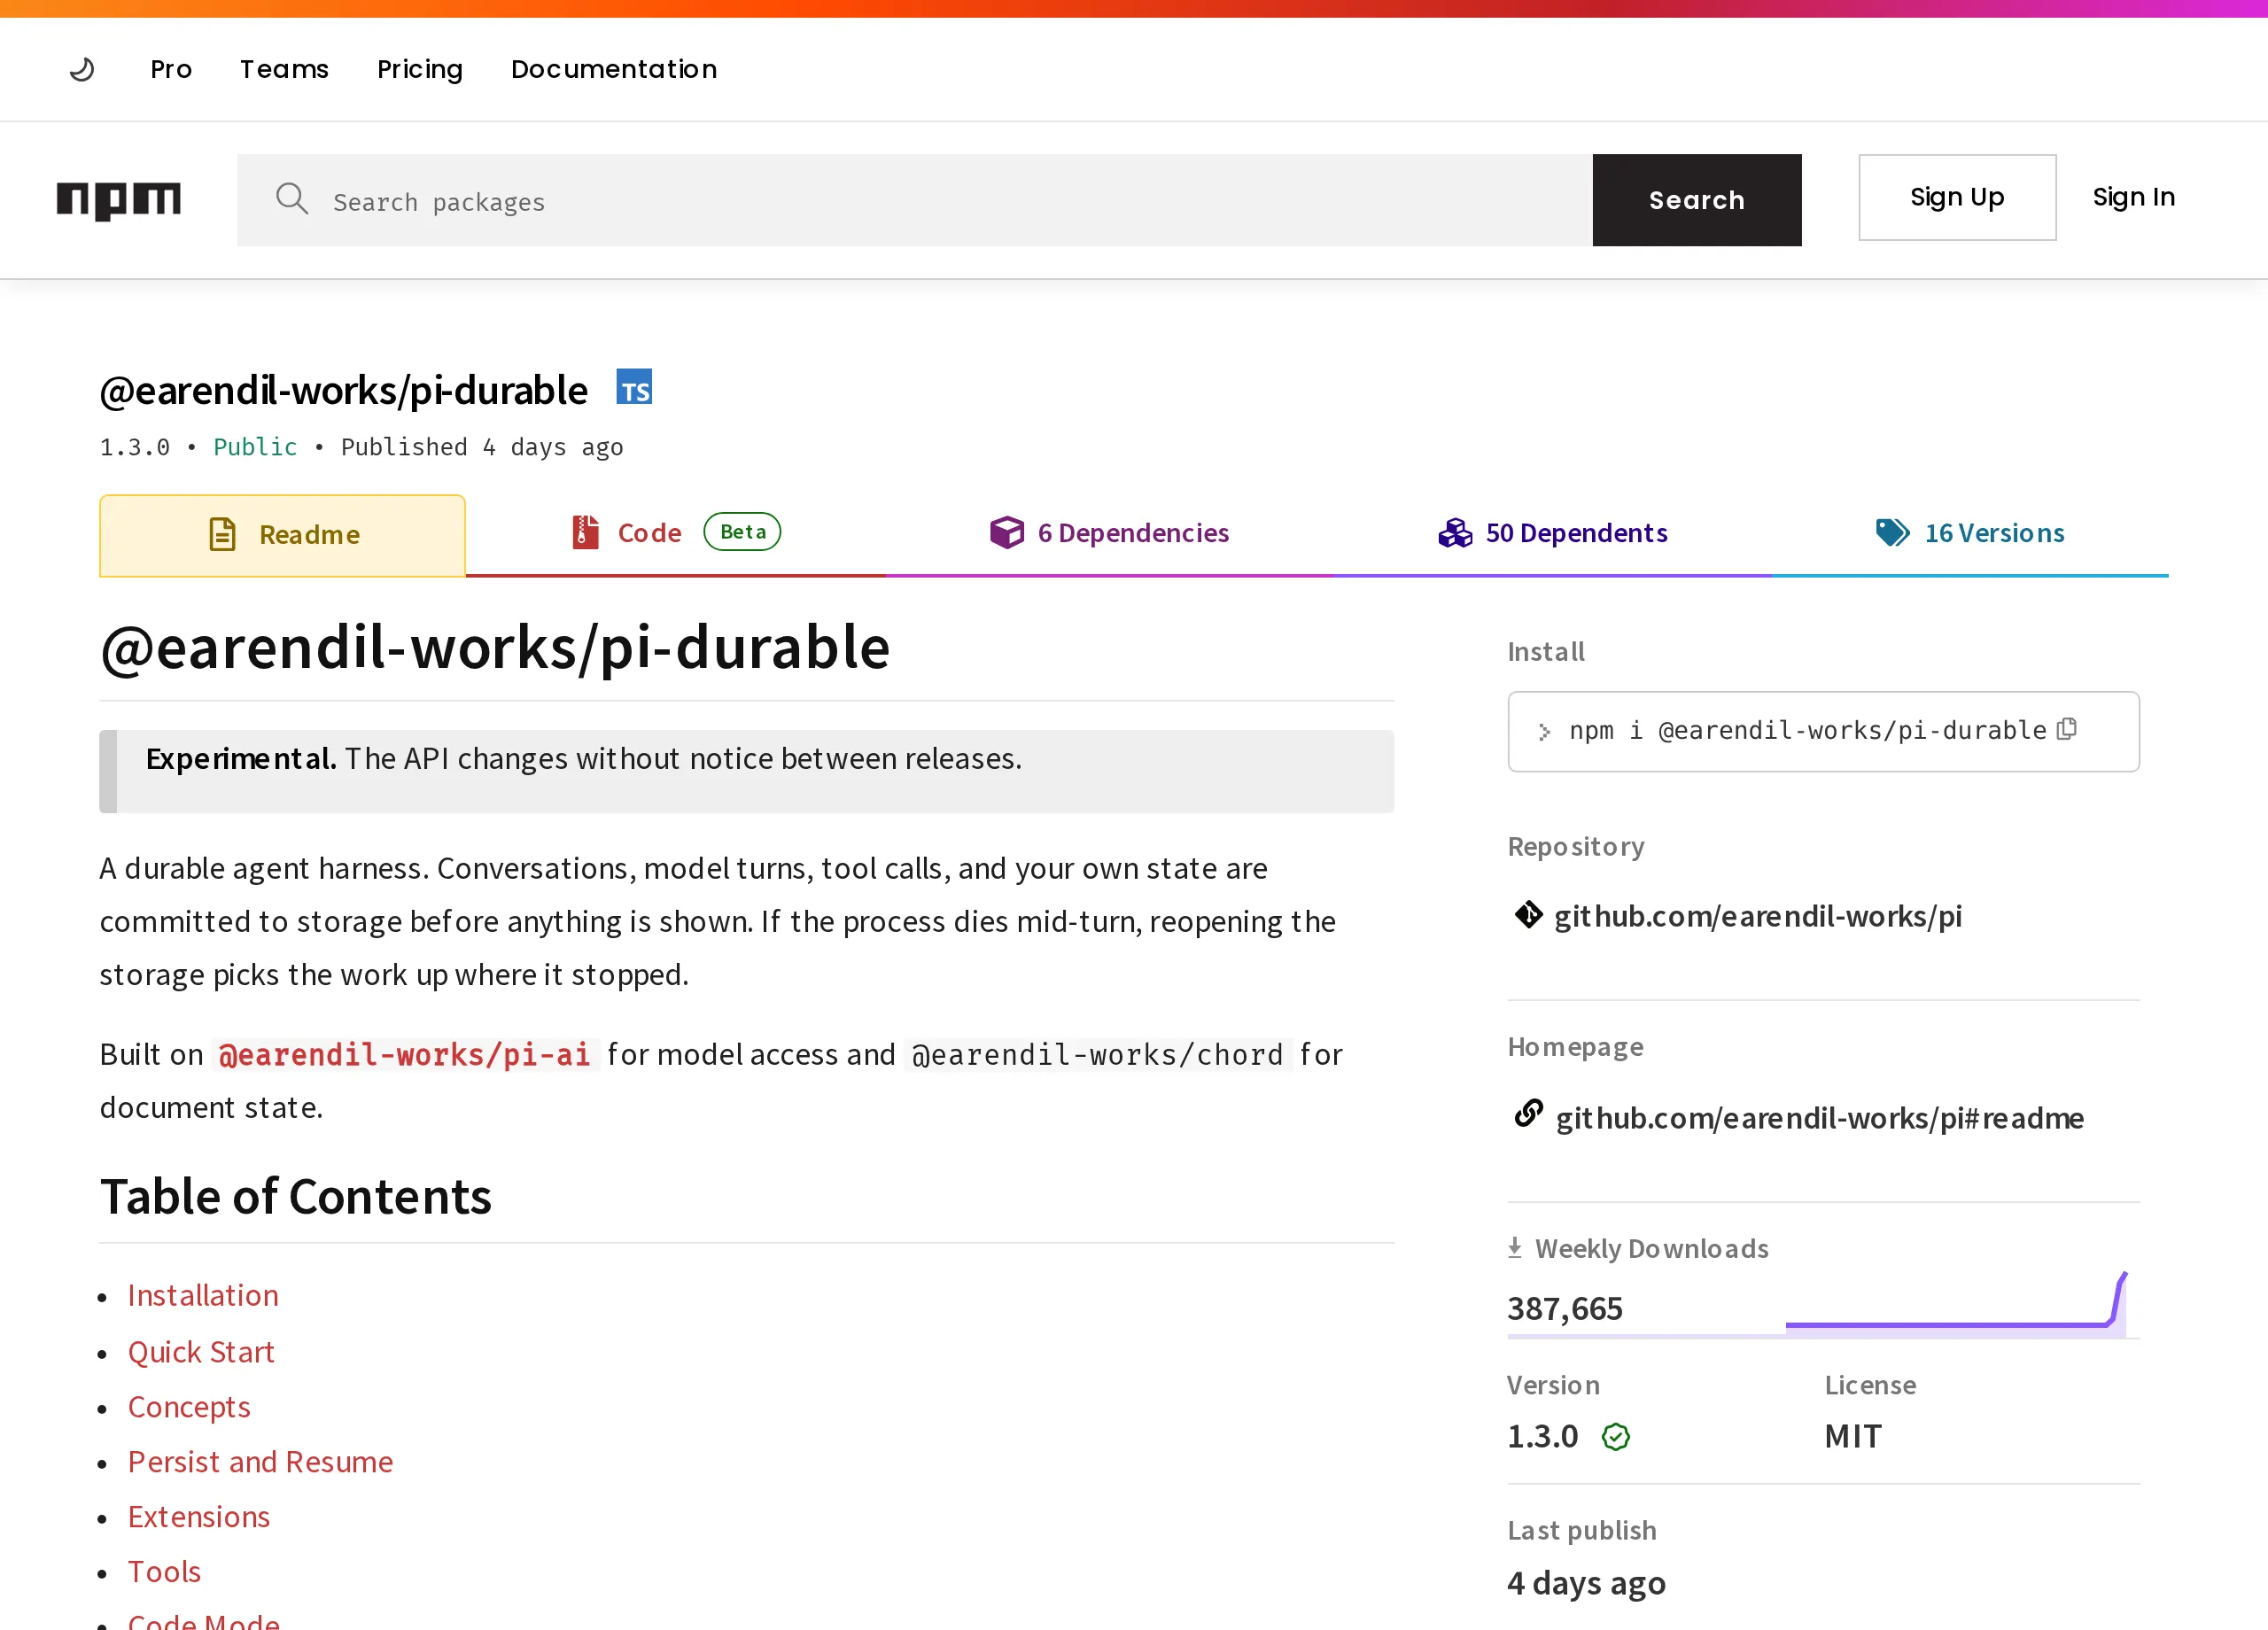
npm:实验性的 durable conversation / task / document 运行时。[2]
检查点、replay、requestId:三条不同的保证
机制上最容易混的是三件事。它们听起来都像「恰好一次」,实际保的东西完全不同。
先说任务检查点。每一步进入下一阶段前先落盘。新进程打开存储并调用 resume() 之后,未完成的任务会从最后检查点继续。被截断的模型请求会重发,对话记录里留下标记为 aborted 的半截回答;已经排进收件箱(inbox)的消息也还在。[1][2] 后果是:过夜跑迁移的 agent 在凌晨 OOM 之后,早上不必从第一行 diff 重来,但你仍要接受那次被截断的模型回答会出现在历史上。
再说工具重放策略。工具的意图在真正执行前就已经提交。崩溃之后,只有声明了 replay: "safe" 的工具会自动再跑;否则模型收到 interrupted,并带上已经提交的部分输出,由它决定下一步。[1][2] 搜索问题列表可以标 safe,因为再搜一遍通常无害。退款或部署通常不声明 safe:若进程死在「扣款请求已发出、回执还没写回」的窗口里,自动重放会变成第二次扣款。MindStudio 的解读把设计意图写得很清楚:durable 默认保守,只有显式声明才重放。[3]
第三条是 requestId 的提交恰好一次。客户端崩溃后用同一个 requestId 再 submit,拿到的是原来的那次提交,不会再把同一句话投进会话两次。[1][2] HN 上有人质疑「光有 ID 哪来 exactly-once」;维护者的回应是,requestId 就是幂等键,保证的是承认(admission)恰好一次。[4] 这和站内 Exactly-once 落点 的分层一致:提交层恰好一次,并不等于外部副作用端到端恰好一次。退款工具就算提交没有双投,仍要在支付侧挂幂等键,或把写做成可安全重放的任务阶段。
扩展还可以用 defineTask 自己写状态机:分阶段、在等待态上挂子任务,并用 failFast 让一张卡拒付时中止其余付款、走 abort 退款。官方结账示例把结构化并发、所有权树和阶段检查点写进同一套 API,而不另起一套工作流 DSL。[1][2] 需要跨崩溃记住「人已经批过了」时,把决定写进任务的 memo(先写者赢),重启后就不会反复弹审批。[1]
忙会话的收件箱也值得单独看。默认的 follow-up 会在本轮答完后开下一轮;whenBusy: "steer" 插在当前工具轮次之后,用来改正在跑的方向;reject 则直接拒绝。支持工作区里若三个人同时 @agent,没有 durable 收件箱就只能自己发明队列,而且那条队列不会跟着进程复活。[1][2]

崩溃恢复时:标了 safe 的工具可重跑;未声明的只上报 interrupted。requestId 管提交,不管外部副作用。[1][2]
子代理也不是内置魔法。几十行工具代码就能创建一场由当前工具任务拥有的对话;标了 replay: "safe" 时,重跑会找回同一个子会话和同一 requestId 的提交。[1] 所有权树决定中止范围:按 Esc 会自下而上清掉当前工作拥有的任务与子会话,而标了 background: true 的任务可以活过本轮,适合「两分钟后查天气」这类闹钟活。[1][2]
存储、分叉、文档状态、可塑性
内置后端有 Memory(不持久)、SQLite、JSONL,以及 Cloudflare Durable Object 上的 SQLite 适配。SQLite 与 JSONL 的核心不绑 Node API,因此也能跑在 Bun 或 Durable Object 上;自定义后端则应先过规范符合性套件。[2] 同一时刻只有一个进程拥有一块存储。SQLite 默认 WAL 加上 synchronous = NORMAL,扛得住进程崩溃,却不保证主机掉电时最新那次提交一定保住,官方 README 与 MindStudio 都写明了这一点。[2][3] JSONL 可以打开 fsync,但会把整段历史留在内存里,所以长跑更推荐 SQLite。若要接 Postgres 或 KV,先跑 conformance,再对外说「我们已经 durable」。[2]
内存里只保留工作集:活跃的对话记录、仍在跑的任务,以及尚未处理完的提交(pending submissions)。活跃对话记录会被模型窗口自然限幅,因为压缩(compaction)会在溢出前做摘要。于是几万条消息的会话仍可能塞进有限内存,前提是你接受摘要损失,并且把旧消息留在存储里供搜索。[1] 支持工作区里「上周谁拍板用 Postgres」这类问题,就靠存储里的旧记录,而不是靠窗口里 verbatim 的全文。
一个 harness 上可以并发跑多场对话。fork 在某一条记录处分叉,子会话能看到父会话到该点的历史,却不必整份拷贝。[1] 对支持场景,通道是一场对话,线程是在某条回复上的分叉:两边同时跑,互不阻塞。HN 上有人问为什么不再用「每条记录挂 parent」的树;维护者说那是 coding agent 时期更笨的表示。现在一场对话是按时间序的不可变列表,父子关系挂在「另一场对话的某条记录」上,语义等价,实现更平。[4]
应用状态用类型化的文档(document)存放,并与对话记录在同一次提交里修改;分叉时可选择沿用分叉点快照、沿用当前值,或从初始值重来。界面订阅的是已提交状态,晚加入的客户端从当前视图开始,不重放整段历史事件流。[1][2] 若工单状态写在另一个库、对话记录写在 harness 里,崩溃后很容易出现「模型以为单已关、数据库仍开着」。文档把这条撕裂面收窄到同一次 commit。
注册表还可以热替换同名扩展:正在跑的调用仍用旧代码,下一调用用新代码;会话只存扩展名,不存代码,重启后装什么就解析什么。[1] 这样改 agent 行为不必停会话,但旧调用与新调用可能短暂并存,测试要覆盖那条边界。
压缩本身也是任务:上下文接近窗口时在后台做摘要,必要时才阻塞下一请求;旧消息仍留在存储里,可被搜索历史一类工具读到。reset 或 handoff 会开启新的上下文,却不删历史。[1][2] 持久化解决的是进程生死,解决不了上下文窗口。[3]
平台粘合:Cloudflare、Vercel、Rivet
Pi Durable 自己是库。闲时不占机器、闹钟叫醒、函数超时换实例,要靠平台。
Cloudflare 一侧,Earendil 后续文把一场 Pi 会话映射到一个 Durable Object:嵌入式 SQLite、可休眠的 WebSocket,以及把 Pi 的定时任务投影到对象闹钟上。对象醒来后恢复事件流,并从持久任务集重算闹钟。闹钟是至少一次投递,所以处理函数必须幂等,稳定的 schedule requestId 用来防止同一条「两分钟后查天气」被提交两次。[5] 结果是:支持 bot 可以在没人说话时休眠,到点再醒,而不必常驻一台虚拟机。
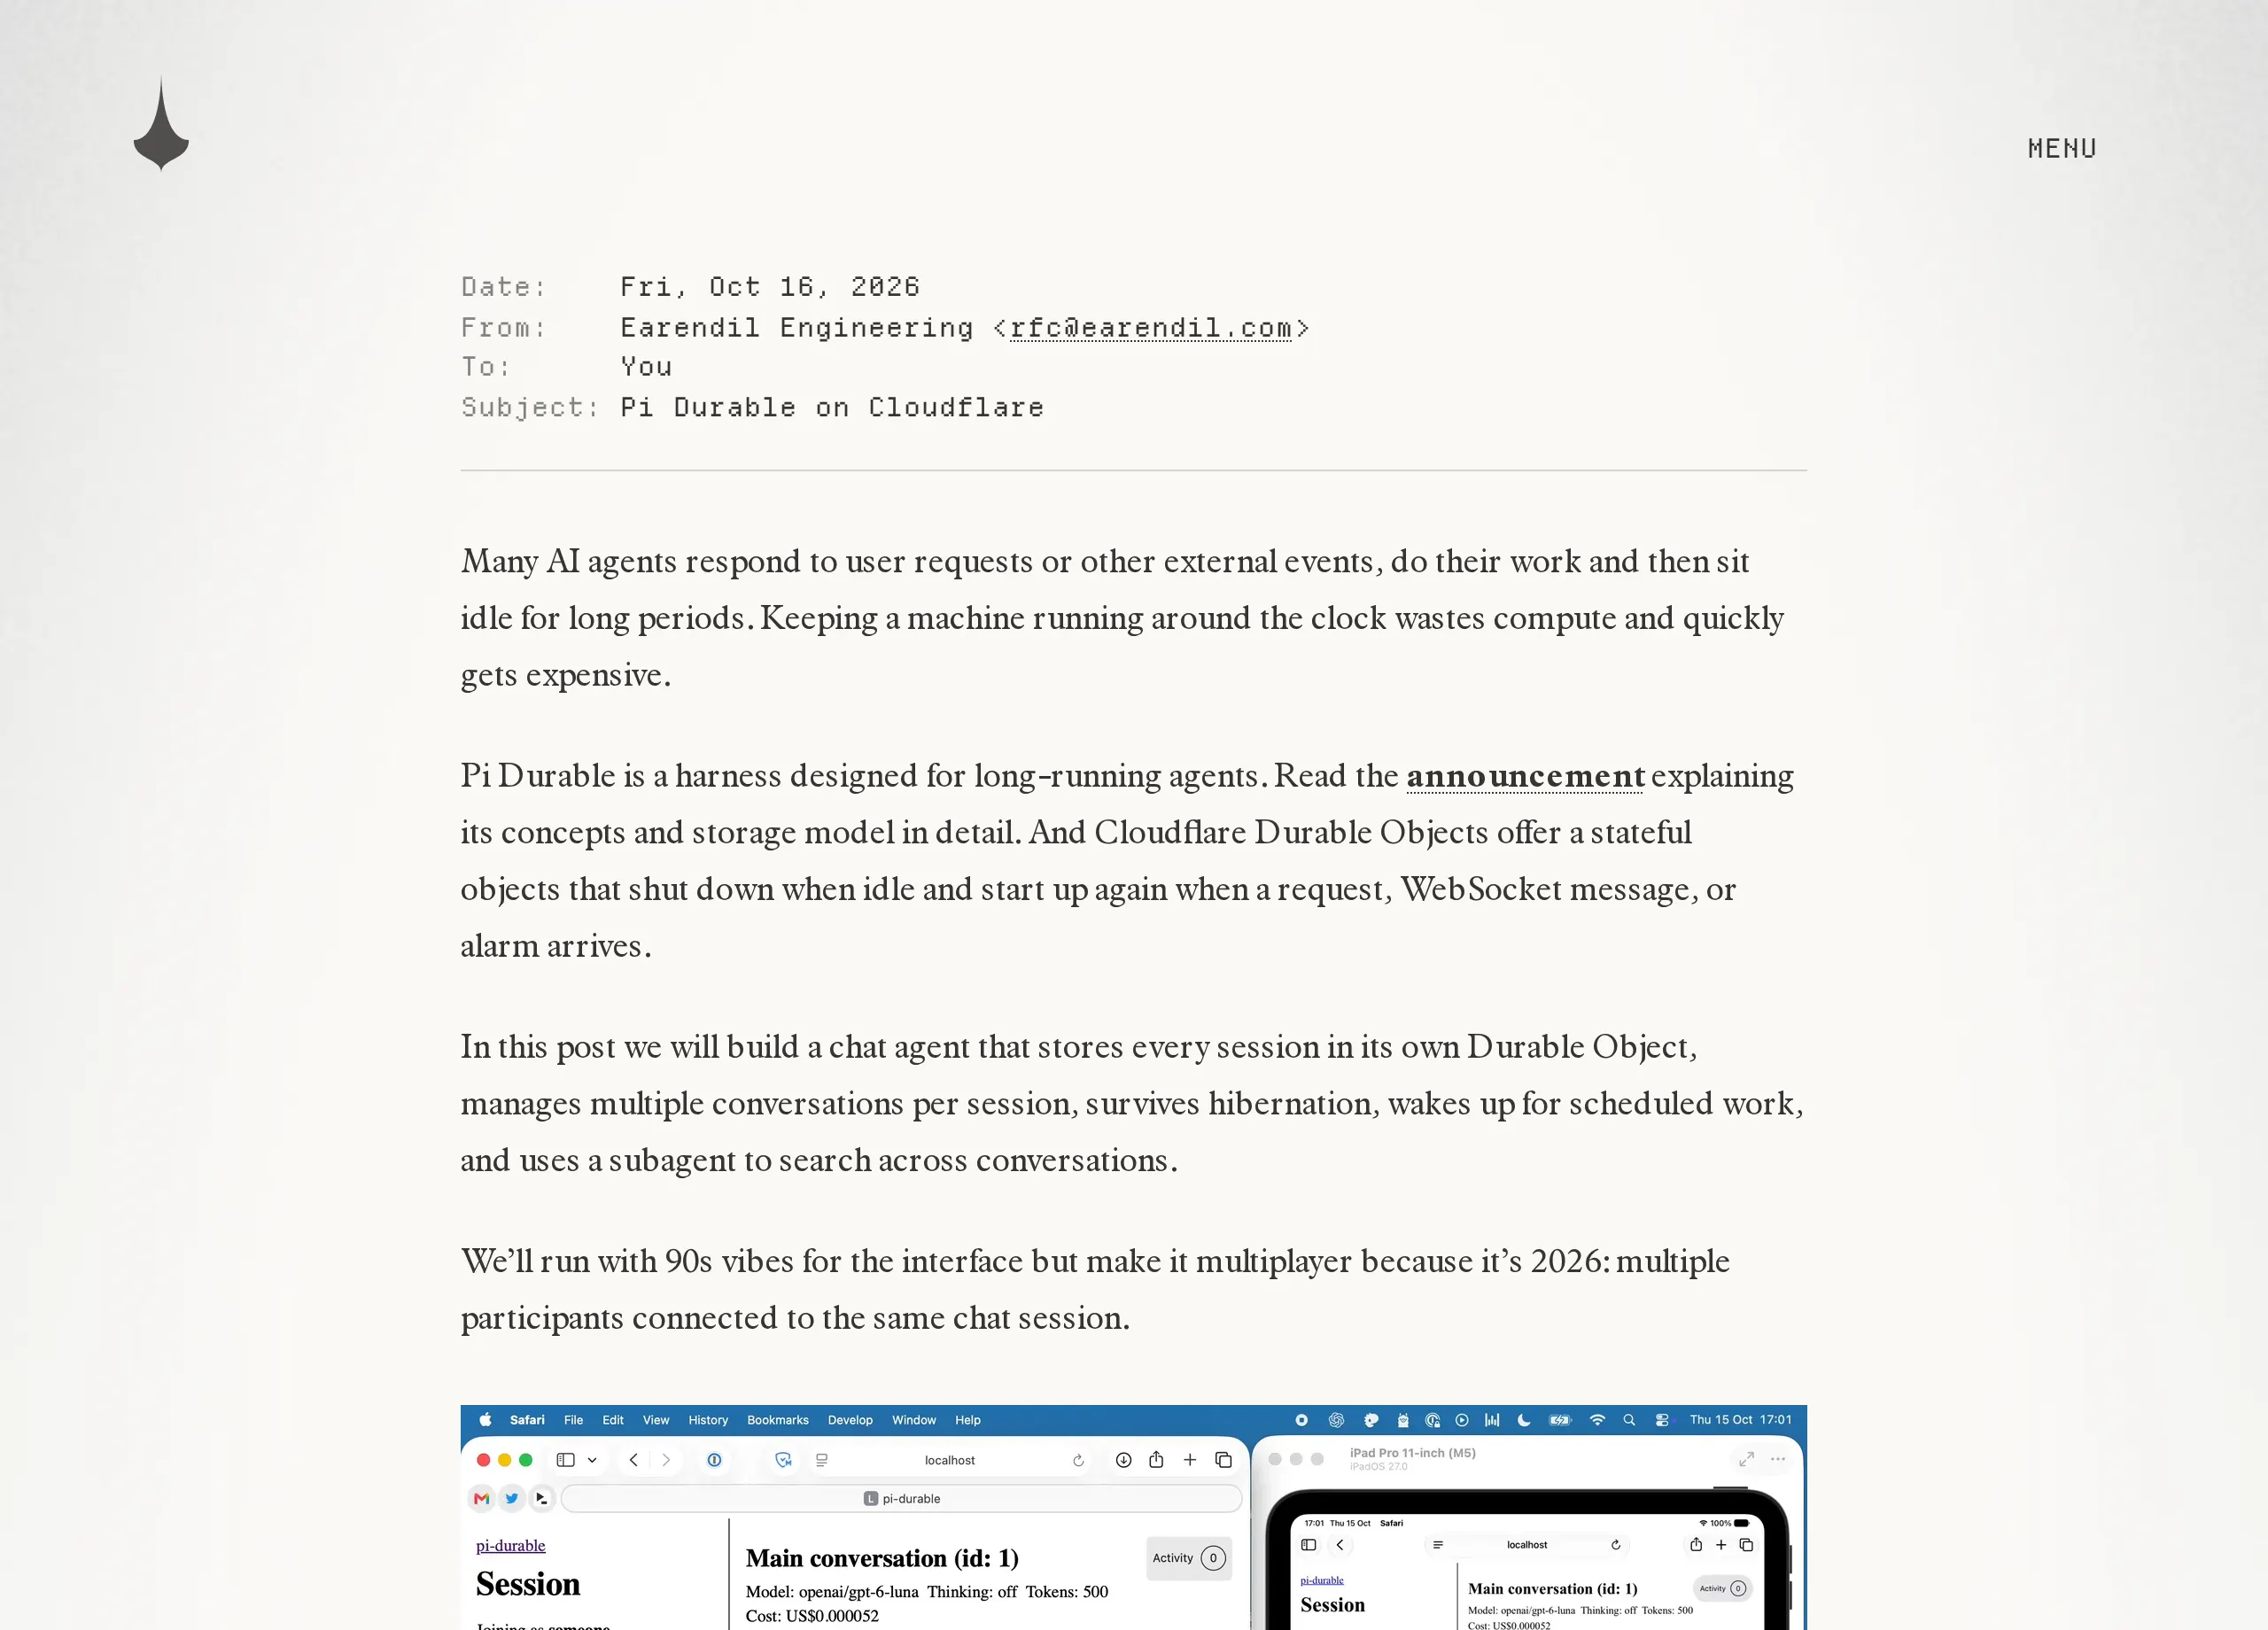
一会话对应一个 Durable Object:休眠、闹钟、多会话分叉、历史搜索子代理。[5]
Vercel 一侧,推荐的 durable-harness/pi-durable 把 Pi 1.0 的完整 Harness 接到 Workflow SDK 的 World 日志上;备选的 durable-harness/pi 只包住 agent 循环。崩溃或超时后,新函数读日志继续:模型调用会重跑,标了 safe 的工具会重跑,其它工具以 interrupted 或 possibly run 交回模型。配套还有 chat 路由、Queues 投递、默认 120 秒无提交可被接管的 recoverAfterMs,以及虚拟工作区或 Sandbox,避免工具写在函数本机磁盘上。[6][7] 若退款工具跑了九十秒还不写任何输出,默认接管阈值可能把它当成死进程抢走,于是你要为这类工具单独提高阈值。
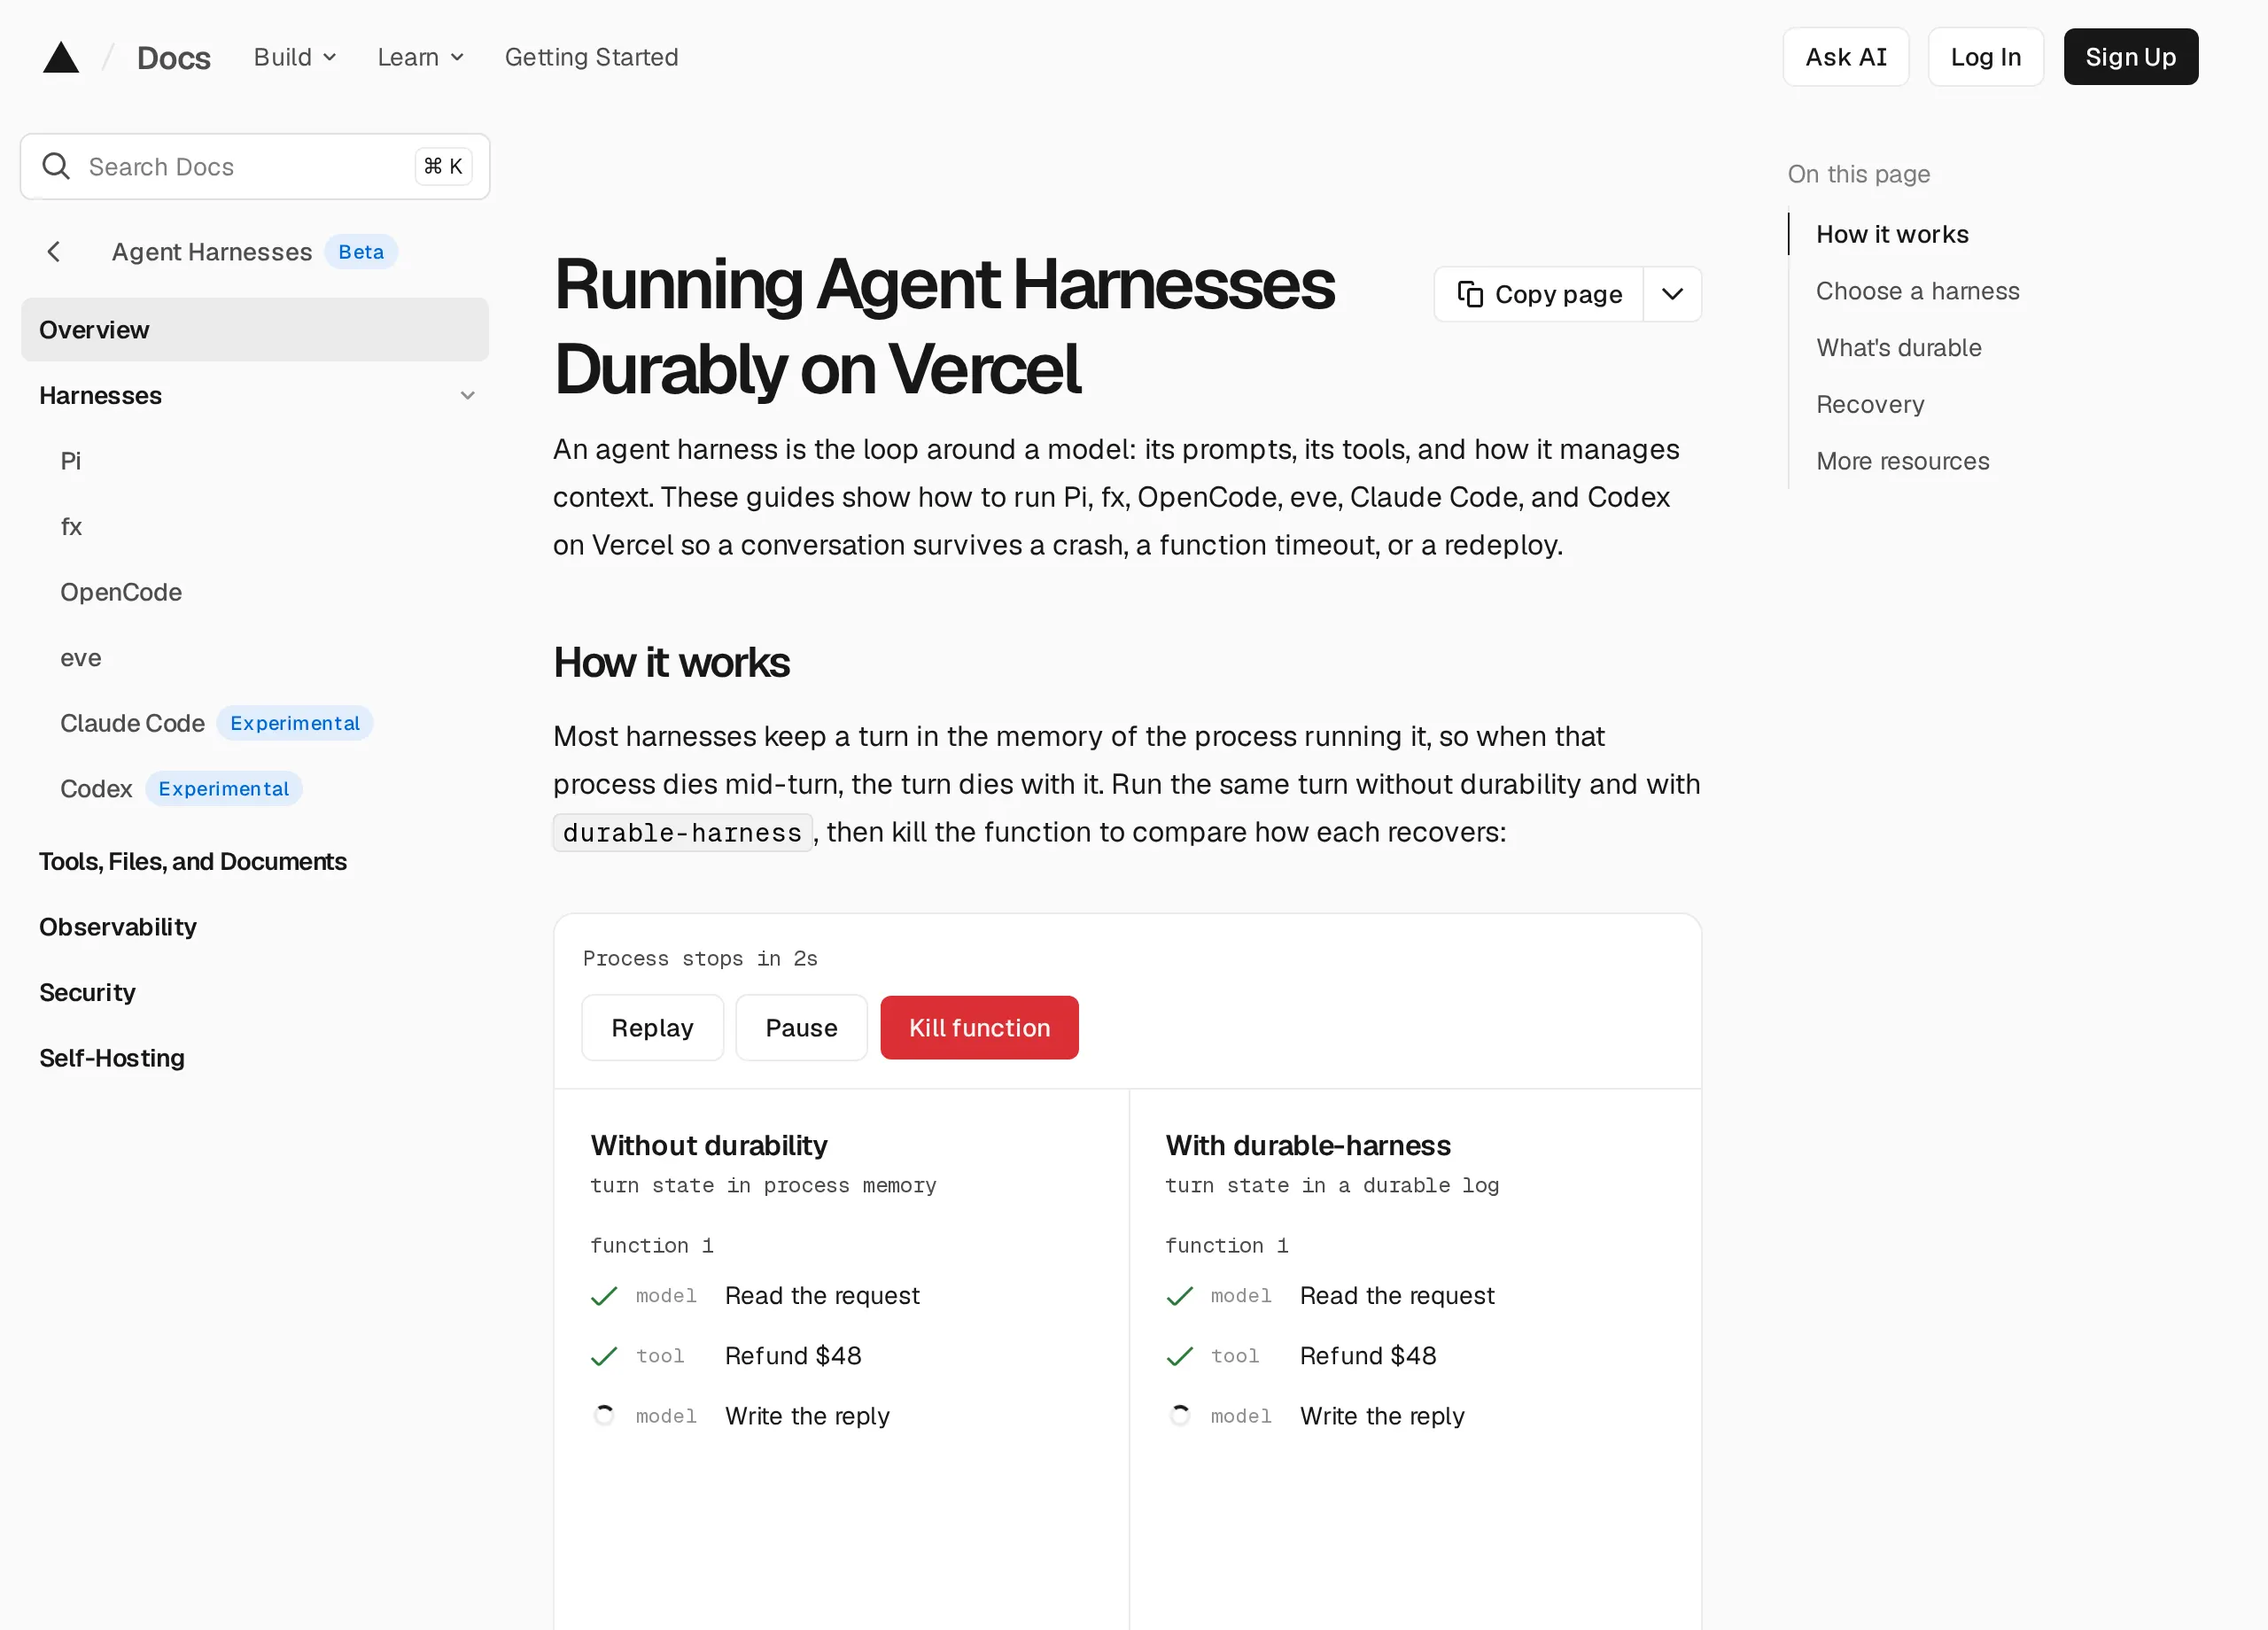
会话落在 durable log 上;Queues 在函数死后投递下一轮。[6]
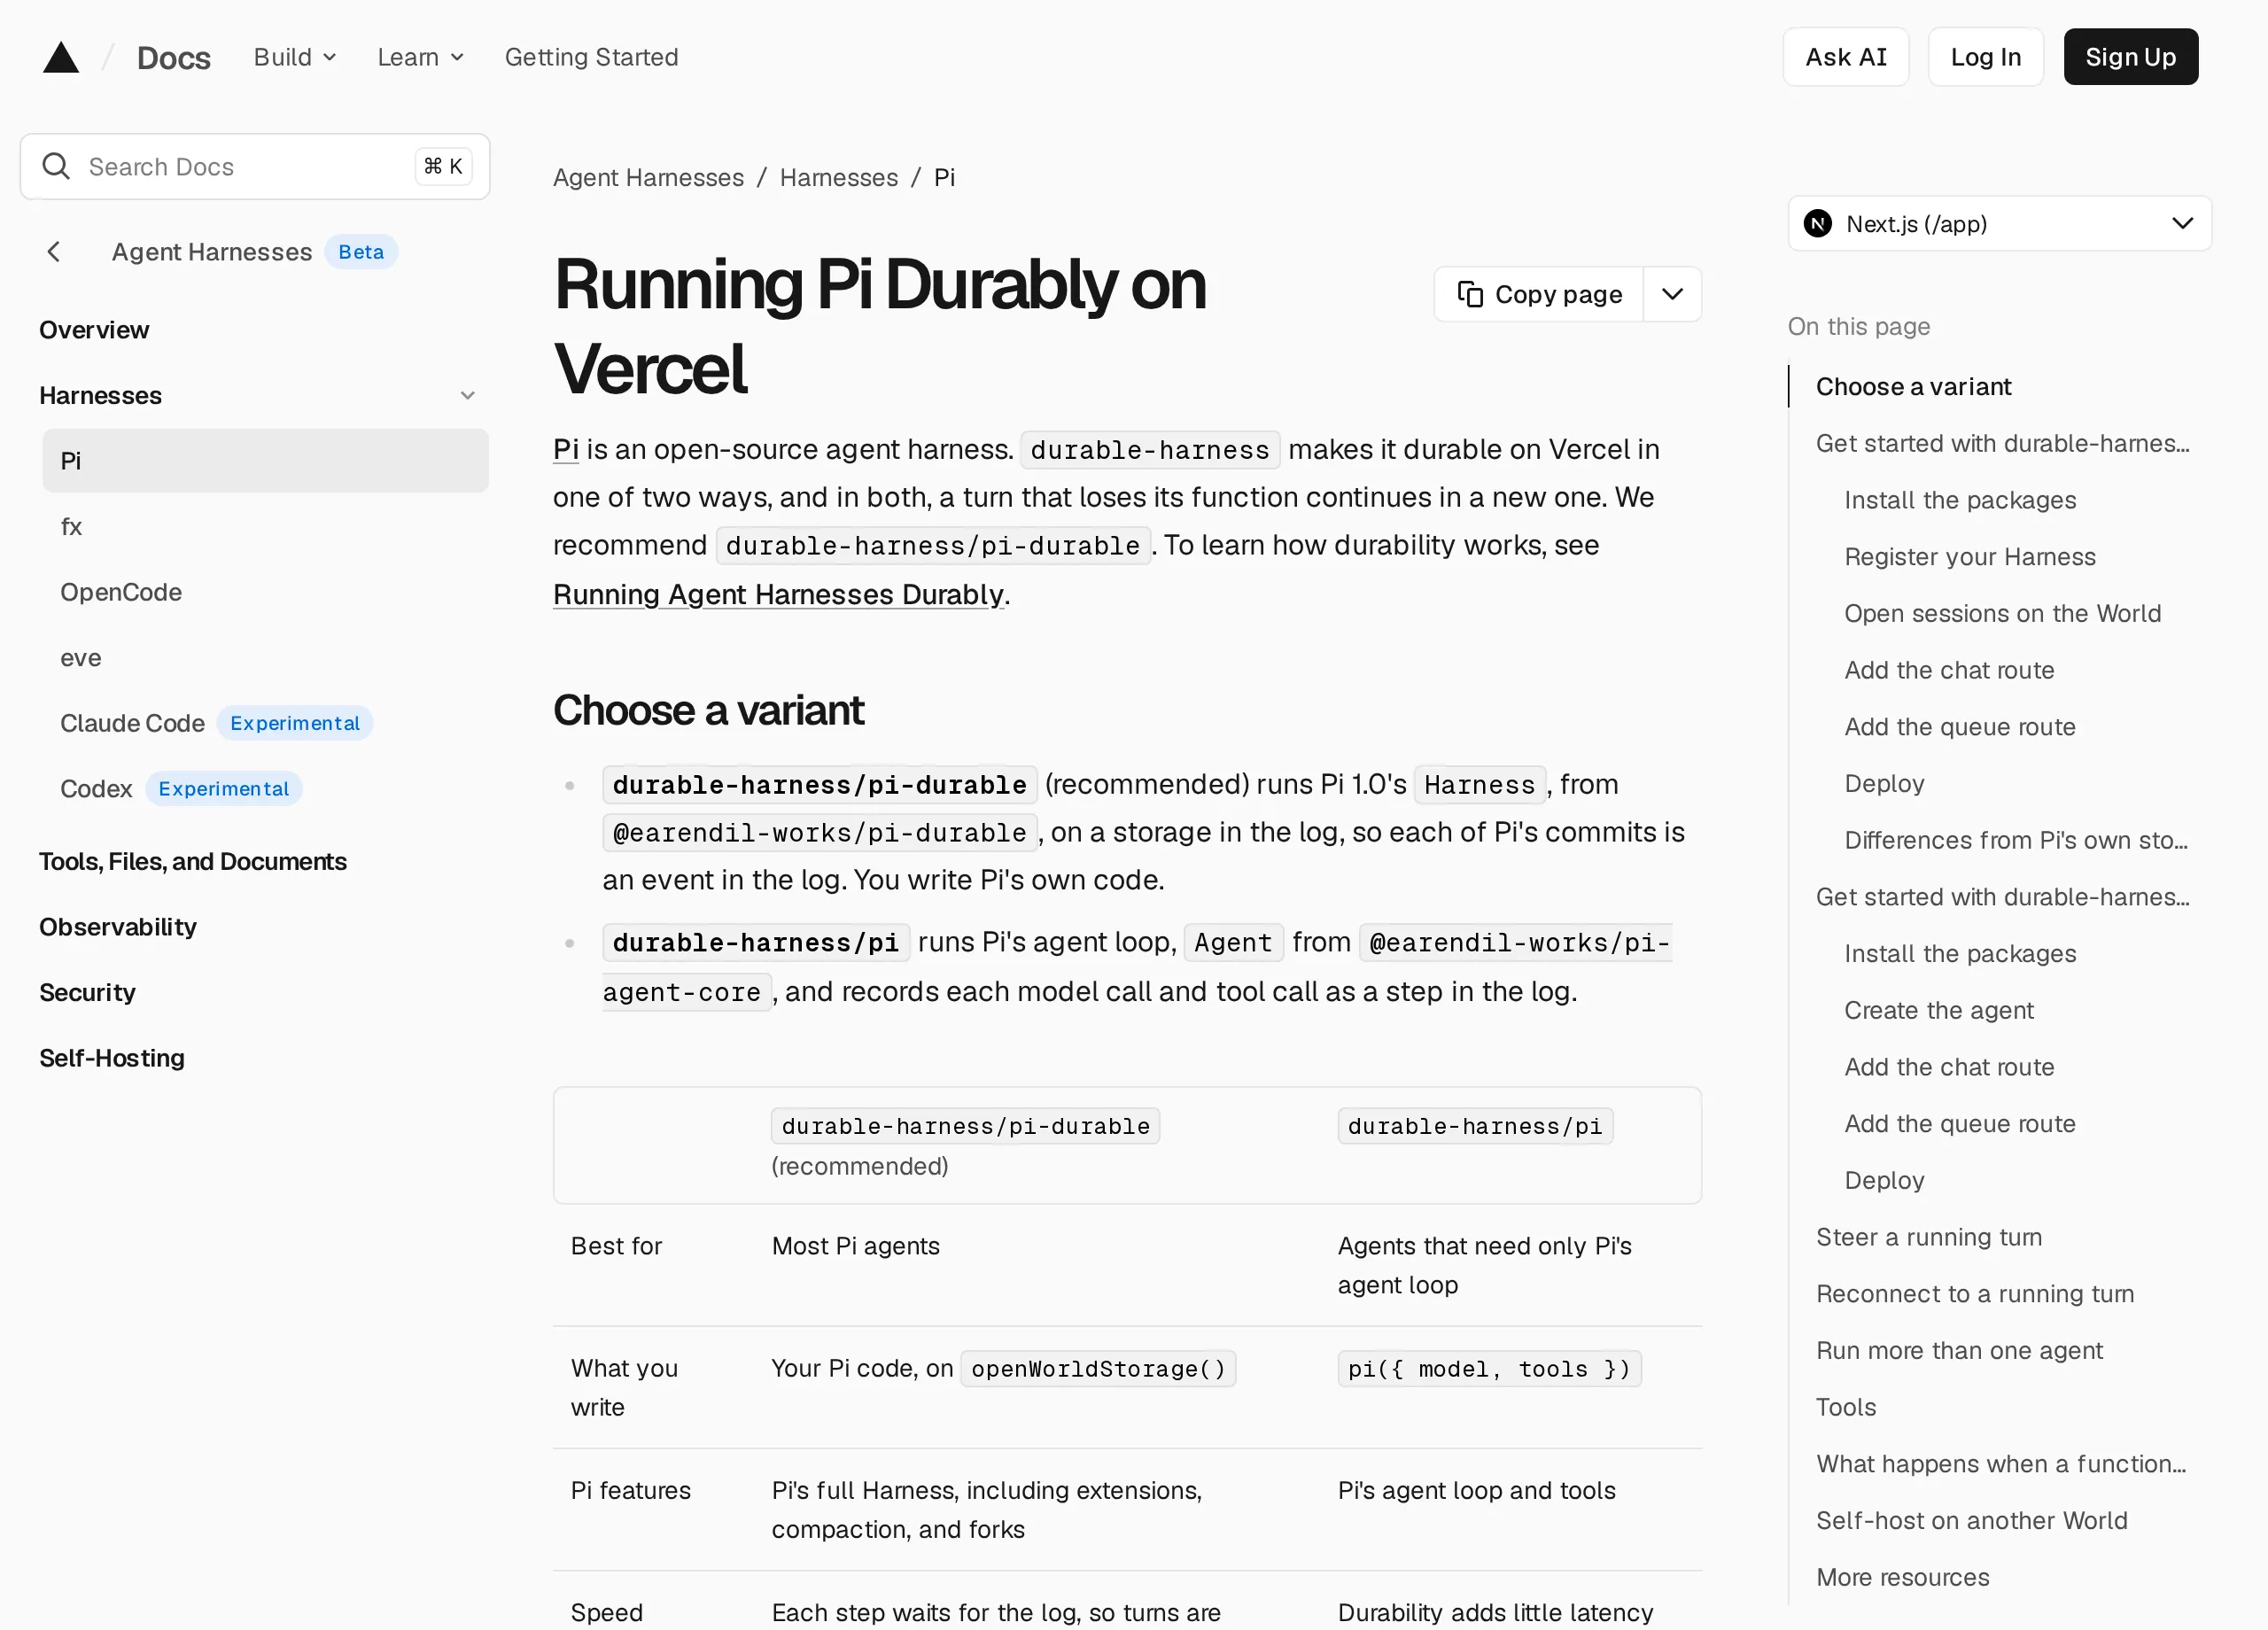
推荐变体跑完整 Harness,保留扩展、压缩与分叉。[7]
Rivet 一侧,agent 活在 Actor 的 SQLite 里,空闲可睡,崩溃或升级中途也能续跑,底层就是 Pi Durable。没有 sandbox 时,读写编辑落在 Actor 库内;要跑 shell 再挂 sandbox。升级时,运行中工作最多有默认十五分钟的收尾窗口。[8] 工具若无视中止信号,就会拖住睡眠与升级,值班时表现为「发版卡住、对象不肯睡」。
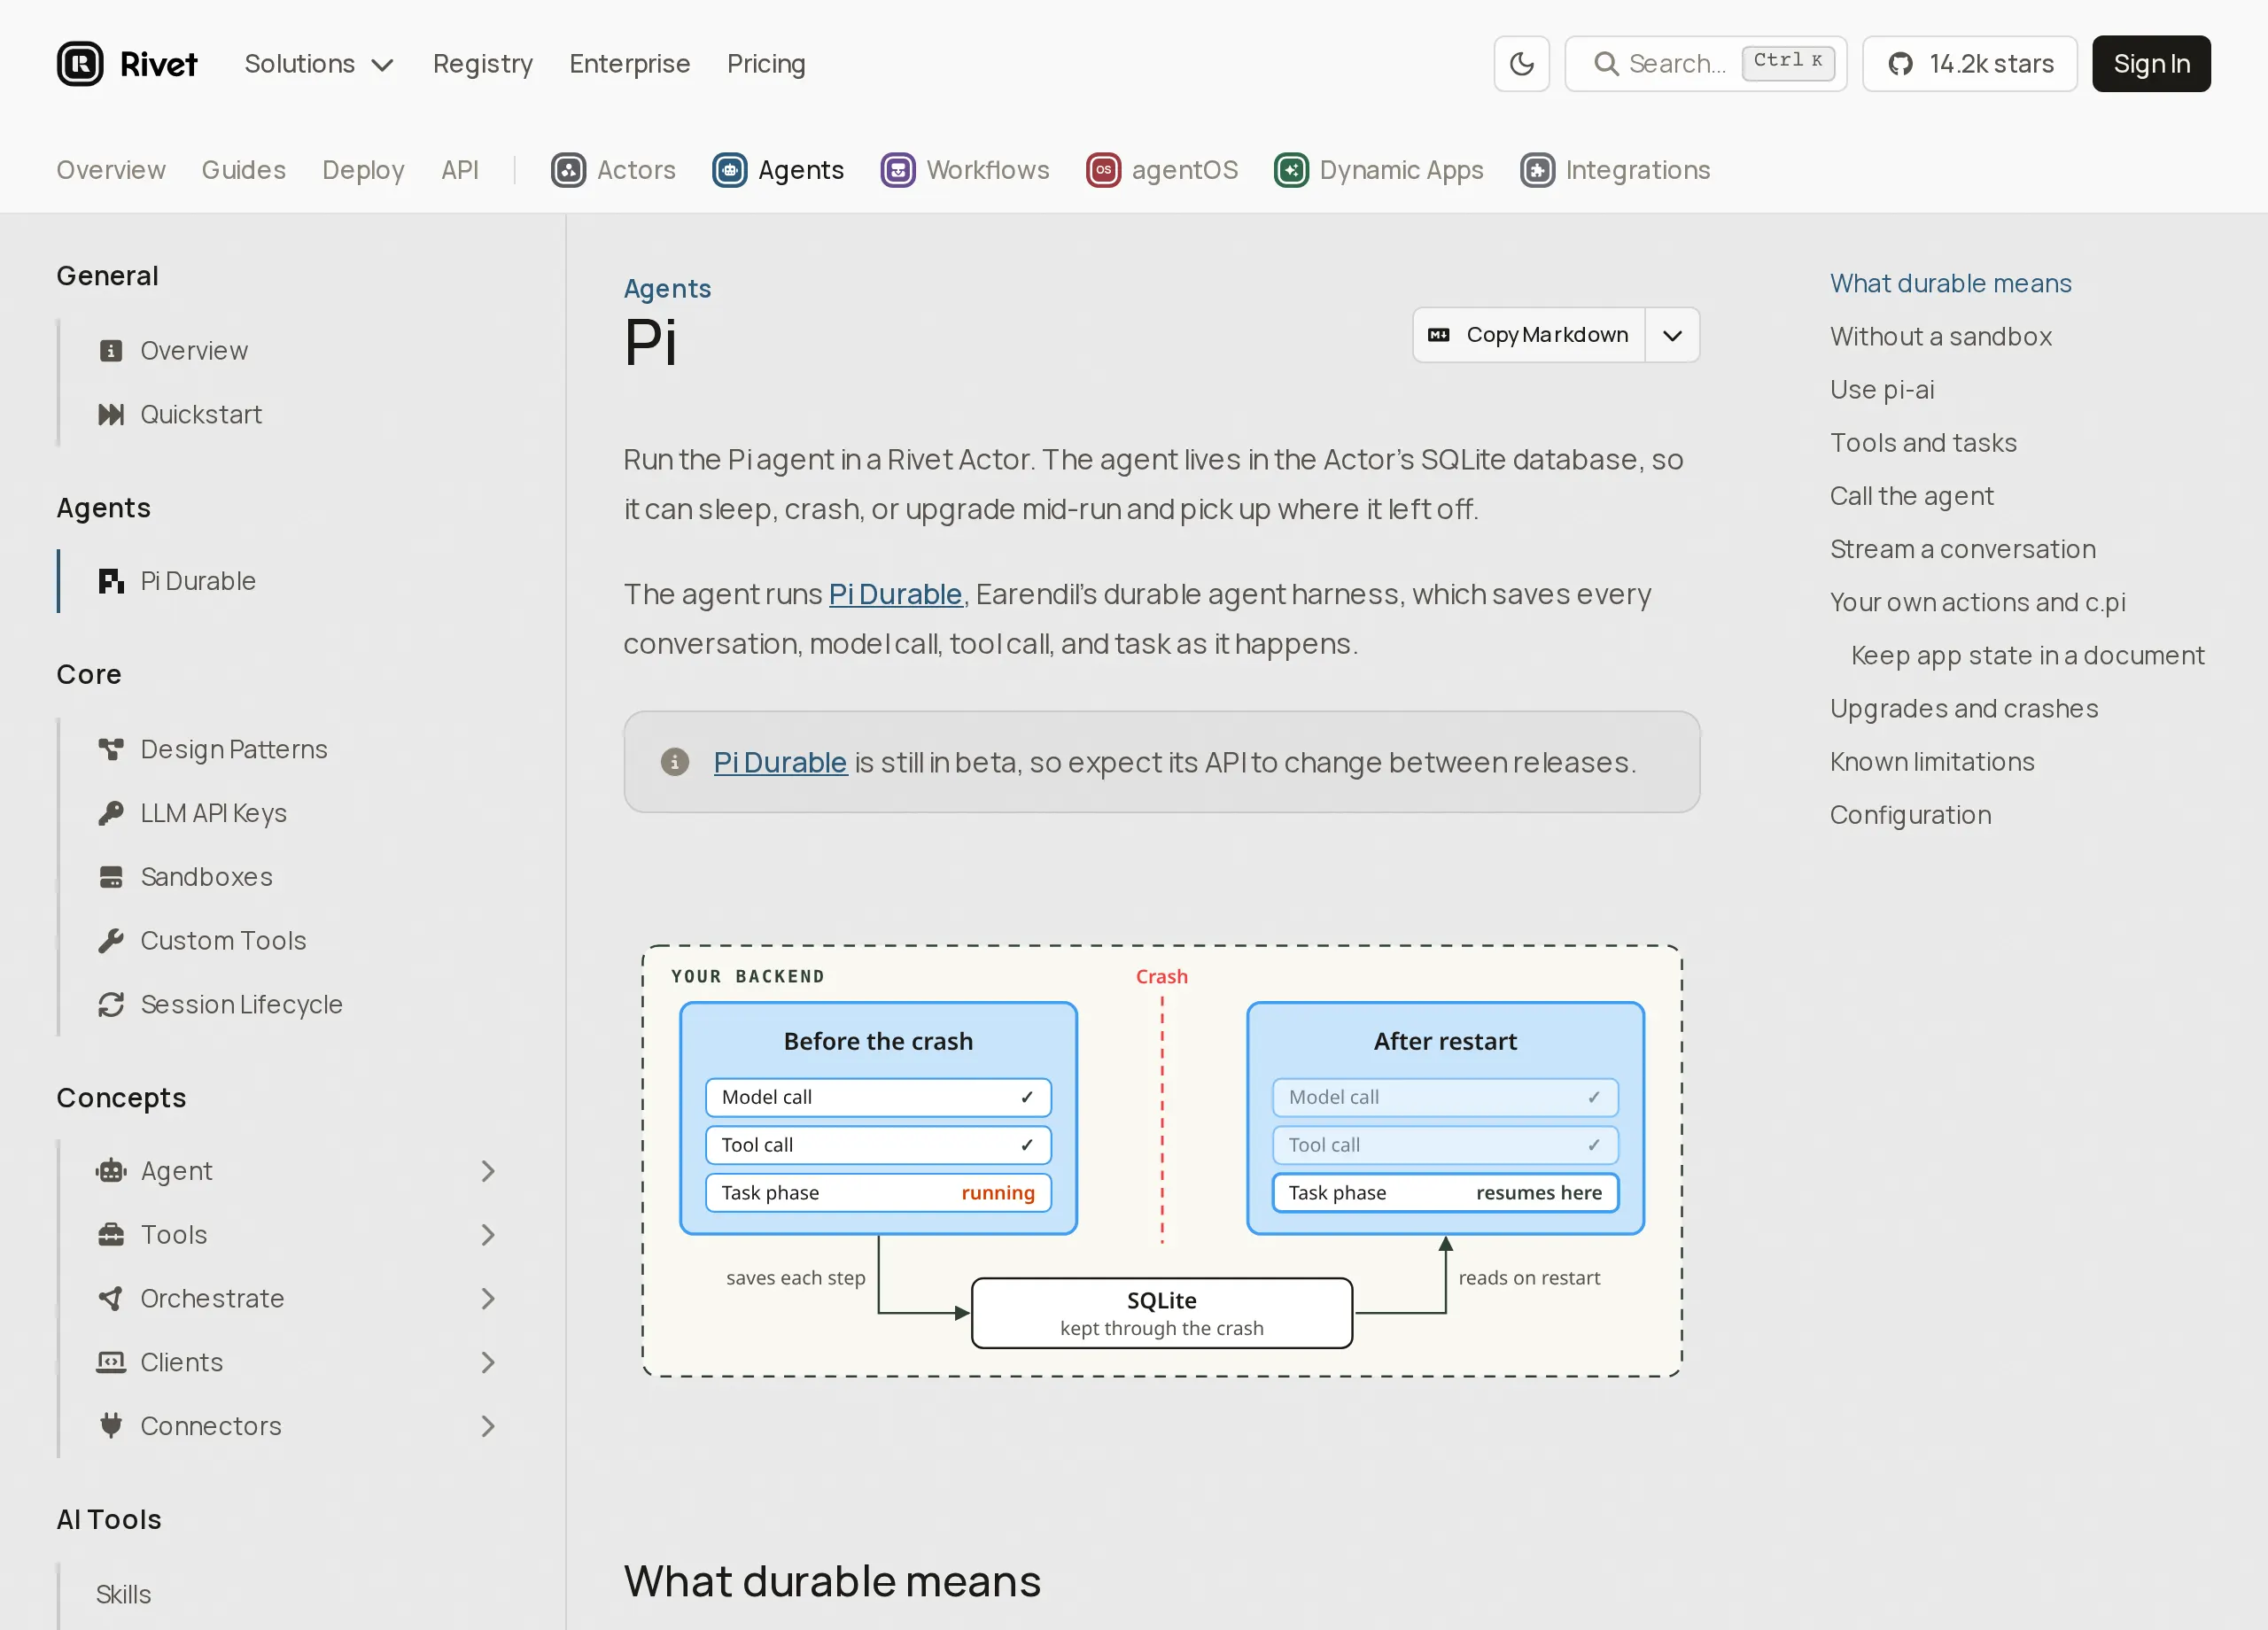
Rivet Actor 加上 Pi Durable:按 key 隔离,空闲时睡眠。[8]
三家证明的是同一件事:检查点、重放策略和分叉这些 harness 语义可以移植;休眠、租约、队列和闹钟是平台能力。选型往往先看你已经站在哪朵云上,再决定是否嵌入 Pi Durable。Cloudflare 路径上不能假设「闹钟响了就等于指令还没跑过」;Vercel 路径上长时间无提交会像假崩溃;Rivet 路径上 abort 信号必须被工具尊重。[5][7][8] 这些坑不在核心库里,却是上线后最先碰到的。
和通用 durable execution 怎么比
把地图摊开,大致四层。左侧更贴近 agent 图与会话语义,右侧更强于跨服务编排。

越往右越强于跨服务定时与信号;越往左越贴近模型循环与工具策略。[1][6][9]
| 机制 | Pi Durable | LangGraph checkpointer | Temporal 等全重放 | Restate / DBOS / Inngest | CF Workflows / DO 托管 |
|---|---|---|---|---|---|
| 恢复单位 | 任务 / 对话 | 图节点状态 | workflow 事件史 | step / journal | DO 状态或工作流步 |
| 模型调用 | 截断则重发 | 视你怎么设计 | 须进 Activity | 须记为 step | 须显式持久 |
| 工具副作用 | replay 显式 | 自管 | Activity + 幂等 | step 幂等 | 自管 |
| 多会话 / 分叉 | 一等公民 | 需自建 | 自建 | 自建 | 视粘合层 |
| 长等待 / 信号 | 定时器 + 平台闹钟 | 弱 | 强(Signal) | 强 | 闹钟 / 托管状态机 |
| 你买到的是 | agent 语义库 | 图状态 | 编排引擎 | 代码优先编排 | 平台对象生命周期 |
Temporal(以及 Azure Durable Functions)走事件溯源:恢复时从头重跑 workflow 函数,已记录的 Activity 结果注入而不再执行。编排代码必须确定性,LLM 与工具必须进 Activity。[9] 你得到跨服务长睡眠和人工审批信号的工业级底座,但对话记录、压缩、转向(steer)、分叉和工具重放标签,都要自己长在 Activity 边界上。若目标是「审批挂三天再继续履约」,这层往往比 agent harness 更合适。
Restate、DBOS、Inngest 更偏日志或记忆化:已完成的步骤直接回放结果,不一定整段重执行编排函数。[9] 适合把业务工作流写成普通函数。对 agent 而言,你仍要决定一轮模型调用算不算一个 step、工具失败如何标记、会话分叉存在哪里。
Cloudflare Workflows 把步骤状态放在平台侧;Durable Objects 则是代码住在可休眠对象里。Pi Durable on Cloudflare 选的是后者:对象里嵌 harness,而不是把每个工具拆成 Workflows 的一步。[5][9] 对「一会话一对象、闲时休眠」的 bot,这条路更贴。
LangGraph checkpointer 给单图崩溃恢复,从上一节点快照继续。它通常盖不住「睡二十四小时等 webhook」「函数超时换机器」「多人同时转向同一会话」。Temporal 文档甚至建议:若已用 Temporal,图内 checkpointer 用内存即可,因为耐久性由 Temporal 承担。[9][10]
更实用的对照是:你愿意把确定性边界画在哪。Temporal 强迫 workflow 代码确定性,副作用进 Activity。Pi Durable 强迫工具作者声明重放策略,会话状态进提交。LangGraph 强迫节点边界清晰、状态可序列化。三者都能挂了再跑,但挂了之后谁有权决定重不重跑副作用,答案完全不同。选错边界的典型症状,是框架层透明重试把一次退款打成两次。Exactly-once 实验里,透明的 sdk-retry 反而把成功率打坏,就是这个机制。
HN 讨论里有人指出,durable agent 空间不如本地 coding agent 那么吵,但大厂都在做,因为无人值守、harness 与算力分离、以及多玩家都需要它。[4] 另一条高频问题是虚拟机、浏览器、沙箱里的状态怎么办。检查点能重建 harness 的内存视图,重建不了「浏览器已经点到第 N 页」,除非你声明式地驱动环境、快照整机,或把不确定性以 interrupted 交回模型。Armin 的回答是:取决于 agent 设计;给完整 sandbox 往往就要快照,大量 agent 并不需要完整虚拟机。[4] 这和站内谈环境可辨识的方向一致:环境若不能被查询与复现,耐久的只是幻觉。
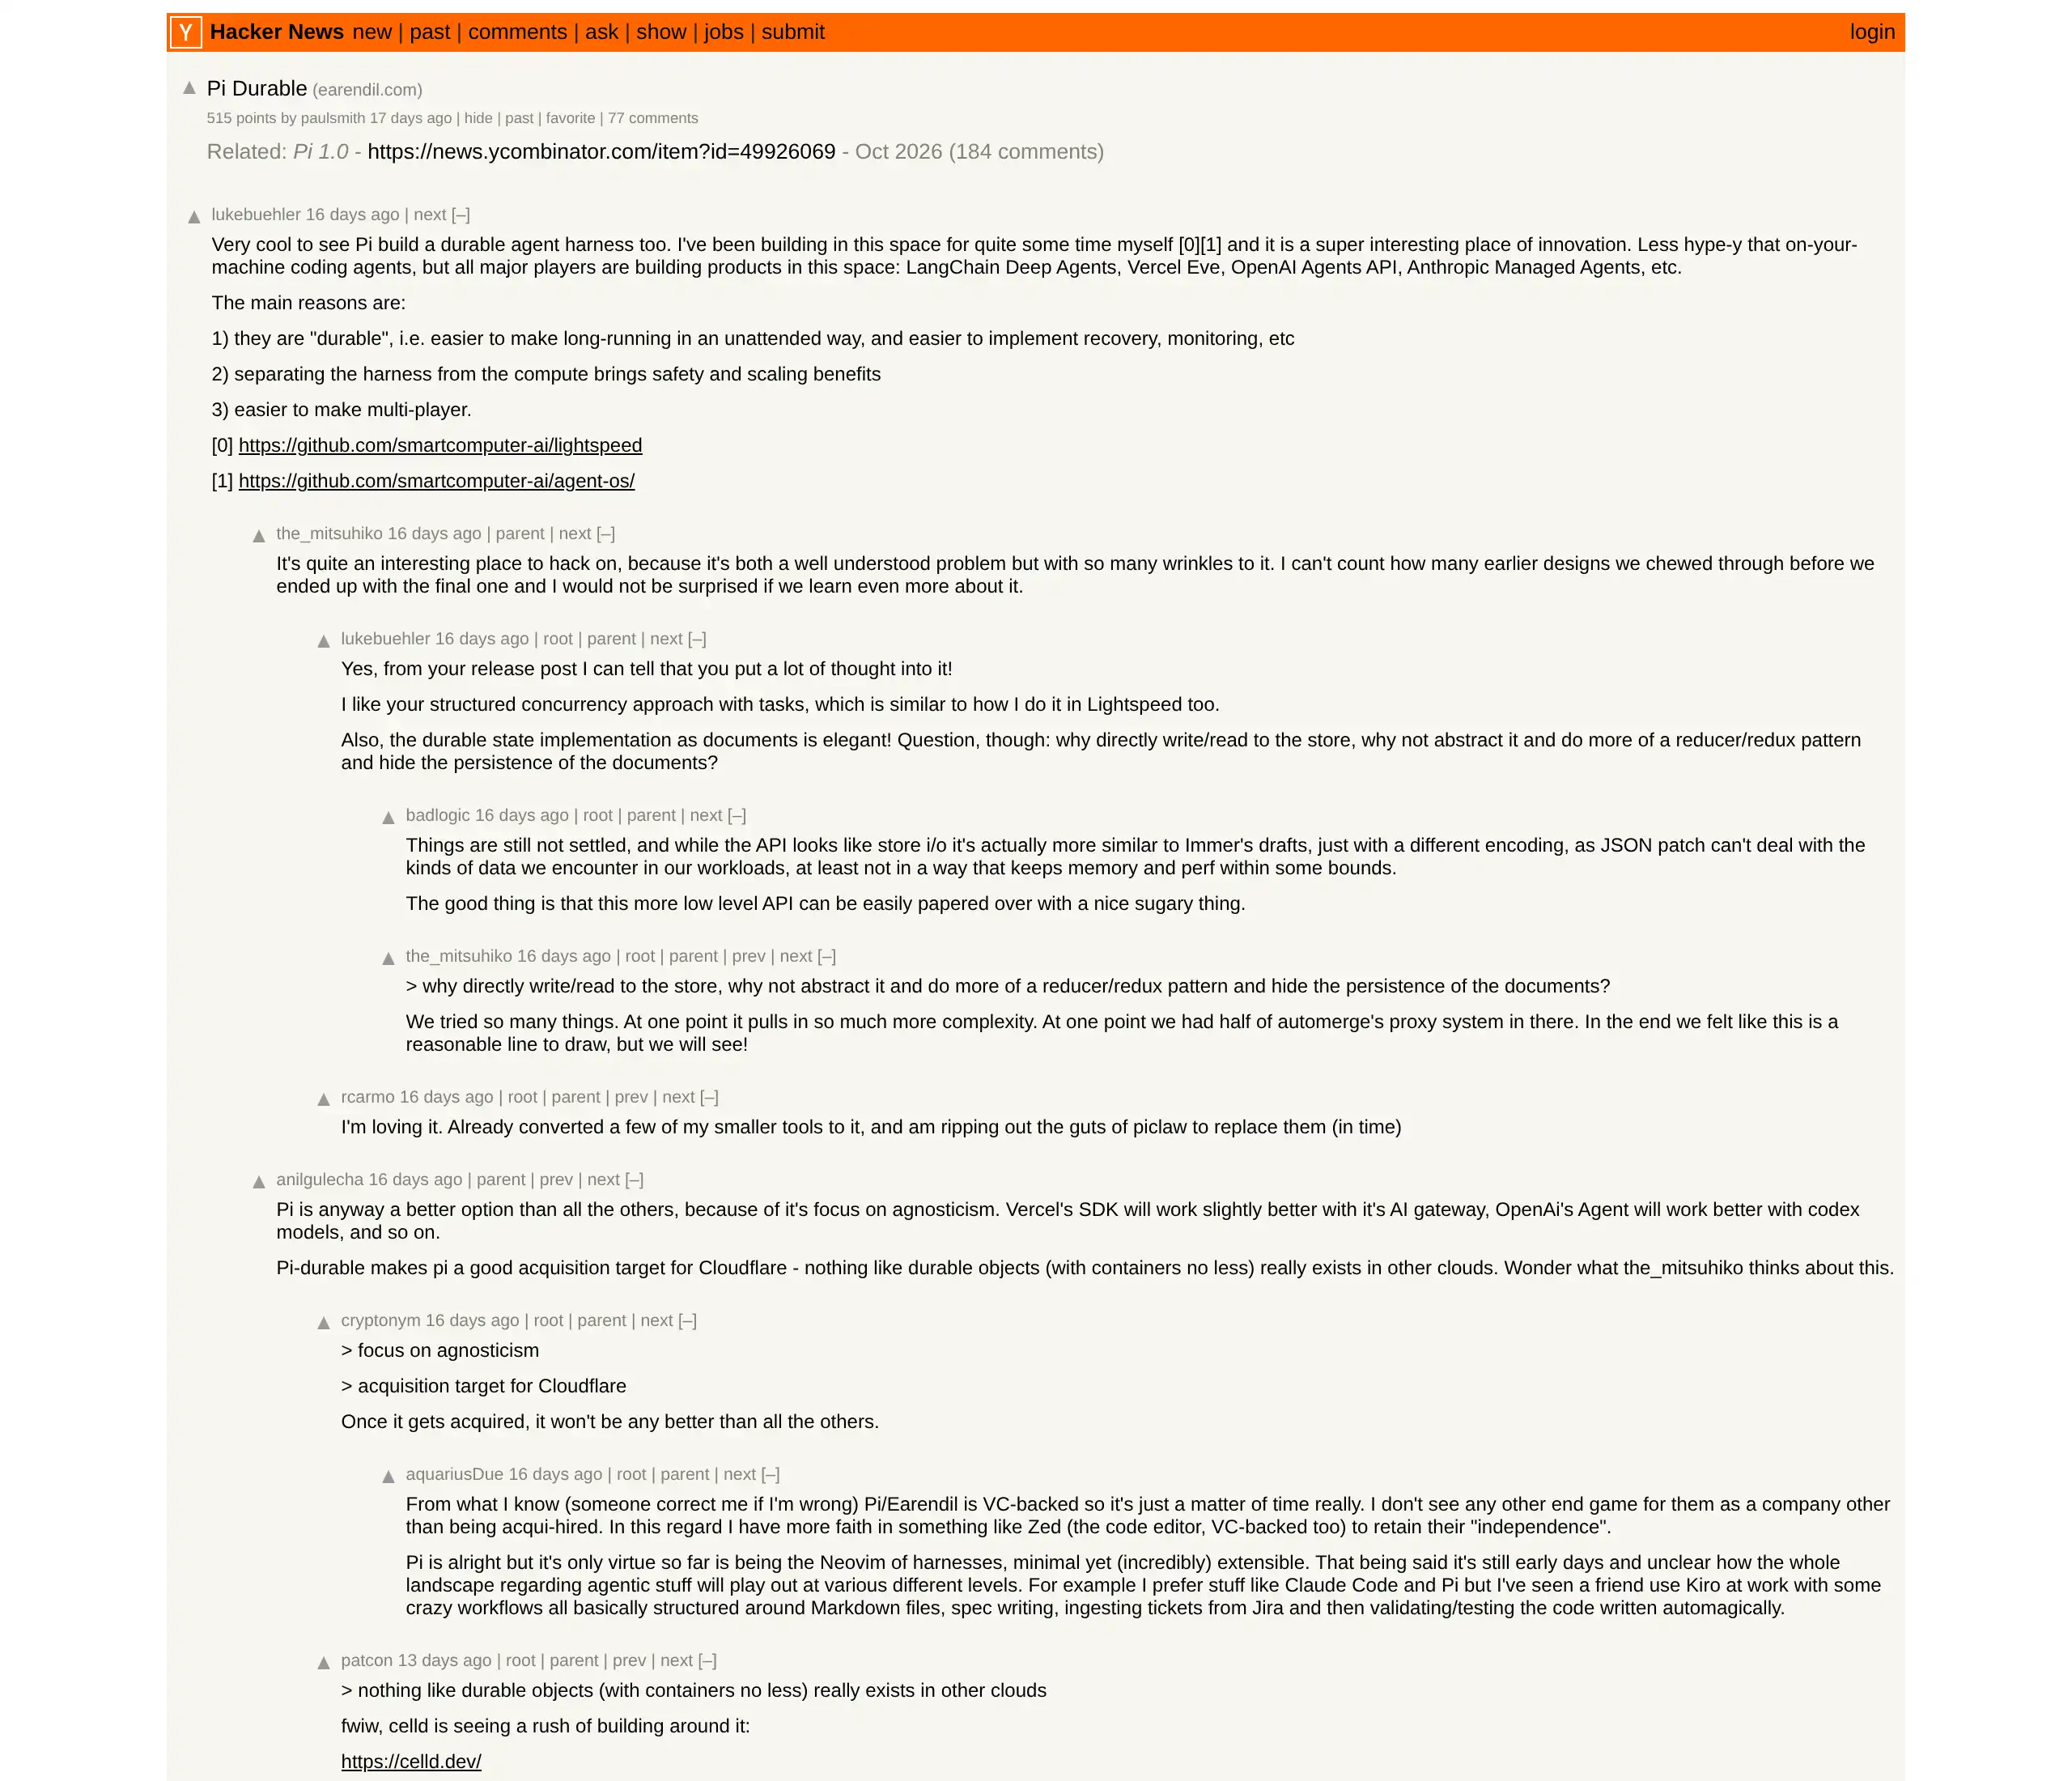
HN:库路线与全家桶 SDK、沙箱状态、requestId 语义是讨论焦点。[4]
MindStudio:强调实验性 API、默认 SQLite 的掉电语义,以及持久不等于无限上下文。[3]
对照时别把词焊在一起
讨论里常有人说「我们上了 durable,所以不会双写」。这句话通常把三件不同的事焊成了一块。检查点管任务阶段快照;工具是否 replay-safe 管崩溃后能不能自动再跑;requestId 只保证提交被承认一次,管不了服务端双扣。[1][2][4] 休眠与闹钟属于平台,Vercel 的 World 日志则是把每次提交接到可换函数续跑的事件流上。[5][6][7][8] 排障时拆开看:退款双写查 safe 标签和支付幂等键,客户端重复提问查 requestId,进度丢失查检查点有没有落盘。
Durable 明确保不住的东西
下面几条写进清单,免得选型时自我安慰。
外部副作用的端到端恰好一次,requestId 与 safe 重放管不到。Stripe 式扣款、不可逆邮件仍要契约层幂等键,见站内 Exactly-once 文。执行环境里的隐式世界状态,例如未快照的浏览器、未声明式的 shell、依赖墙钟的脚本,恢复后会和对话记录打架。模型上下文容量也不会因为磁盘上有完整历史而变大,压缩与 handoff 仍是产品问题。[1][3] 默认存储的掉电语义同样要单独看:Memory 不持久,默认 SQLite 不保证主机掉电保住最新提交。[2][3] API 仍是实验性的,生产要预算迁移与符合性测试。[2][8] 沙箱与策略引擎也不是内置一等公民:执行环境是接口,Gondolin 一类沙箱另插。HN 上有人抱怨这一点,维护者认为自带沙箱才符合可插拔哲学。[4]
决策框架:你到底需不需要

先问进程死了这轮还有没有价值,再问副作用与平台能力。[1][6][9]
可以按四问裁。
进程死了,这轮工作还有没有价值?若没有,人会接着点,终端 Pi 或 Claude Code 一类就够。若有,例如 Slack bot、值班、过夜调查,就需要某种耐久性。失败模式是丢进度还是双写?丢进度用检查点;双写必须动工具契约与幂等键,光换 harness 不够。要不要闲时休眠、闹钟、函数时长上限接管?要的话,优先在已有平台上粘合 Durable Object、Vercel Queues 或 Rivet,而不是先自建 Temporal。跨多个微服务、人工审批挂起数天,则 Temporal、Restate、DBOS 一类更合适,agent 语义另嵌。要不要多会话分叉、多人转向,以及与对话记录原子提交的应用文档?要的话,Pi Durable 这类贴近 agent 的 harness 比「通用工作流再自己拼会话」省大量胶水;只要线性图节点快照,LangGraph checkpointer 可能就够。
三个场景可以帮助校准。值班 Slack bot 里,通道是一场对话,线程是分叉,多人同时 @agent 需要收件箱与转向,进程又会随容器滚动重启:这是 Pi Durable 加上 Durable Object 或 Queues 的典型甜区。[1][5] 过夜代码迁移里,人走了 agent 还要跑几小时;若工具大多是读仓库与开 PR,safe 重放加检查点往往够;若中途会点合并或改生产配置,那些工具应保持默认不可自动重放,并在外部系统挂幂等键。跨财务与库存的履约里,真正的跨服务补偿和三天审批,优先交给 Temporal、Restate 或 DBOS;agent 只作为 Activity 里的一步,或作为会调用编排 API 的前端大脑。不要让 harness 假装自己是分布式事务引擎。
我的看法很直接。若你做的是产品化的 agent 应用,要多表面、要恢复、要多线程会话,Pi Durable 是目前少数把工具重放策略和会话分叉、文档写成一等公民的开源库。它故意不做全家桶,所以 Cloudflare、Vercel、Rivet 的粘合文才重要。若你做的是企业跨系统编排,先选 Temporal 一类引擎,再把模型调用关进 Activity,不要指望一个 agent harness 替你编排支付与库存。两者可以叠用,但职责要画开:harness 管对话记录与工具策略,编排引擎管跨服务生命周期。
还有一条常被忽略:Durable 的价值也在失败语义可读。interrupted、排队中的收件箱、被拥有的子代理、中止树,让产品和值班能回答「刚才扣款工具跑到哪了」。没有这些标签,你只有「agent 说成功了」。Exactly-once 文已经说明,自报成功不可信。
也别把库路线神化。大厂更多卖托管产品,Pi Durable 坚持可组合库:不绑厂商,但休眠、观测和沙箱预算要自己粘。[4] 没有平台工程带宽时,买 Vercel / Cloudflare 粘合或托管 Agents API 往往更快到可值班状态。即便不直接依赖它,重放、所有权和文档这套词,换栈时也能当检查清单。
和站内几篇怎么接
环境可辨识 讲环境要可查询、可复现;恢复对不上环境时,检查点就是空壳。Claude Code harness 给循环蓝图,这里补持久化边界。Strands 产品化循环控制,Pi Durable 让循环状态可恢复。Exactly-once 把副作用的药开在契约上,replay 与 requestId 只是 harness 侧对齐。从 demo 迁到可值班服务时,先分清丢进度还是双写,再谈重放与所有权,最后才选 Durable Object、Queues 或 Temporal。
收束
Pi Durable 把 agent 会话从进程内存里拽出来,变成可提交、可恢复、可分叉、可多人观察的状态机,并用 replay 把「什么可以自动重试」写成工具作者的责任。Cloudflare、Vercel、Rivet 证明这套语义能嵌进休眠对象与队列。它仍保不住外部副作用、隐式沙箱世界、上下文窗口与实验性 API。选型时先画清:你丢的是进度还是一致性,你要的是 agent 语义还是跨服务编排。画清了,durable 才是杠杆,而不是又一个会双扣款的重试器。
写工具时有一个更稳妥的默认:把每个会改外部世界的工具先当成「崩溃后不可自动重放」,再单独论证为什么某几个只读工具可以标 safe。这个默认比「框架帮你重试」更接近生产真相,也更接近 Pi Durable 自己的设计选择。
参考
- Earendil, Pi Durable(2026-10-01)。 ↩
- npm, @earendil-works/pi-durable README(1.3.0);源码在 earendil-works/pi。 ↩
- MindStudio, Pi Durable: What It Is and Why It Matters for Agent Apps(2026-10-04)。 ↩
- Hacker News, Pi Durable(515 points,讨论含 requestId、沙箱状态、库 vs SDK)。 ↩
- Earendil, Pi Durable on Cloudflare(2026-10-16);示例仓 pi-durable-cloudflare。 ↩
- Vercel, Running Agent Harnesses Durably。 ↩
- Vercel, Running Pi Durably on Vercel;vercel-labs/durable-harness。 ↩
- Rivet, Pi(Agents 文档)。 ↩
- 对照综述见 ChangeGamer Durable Execution for Long-Running Agents 与各厂商文档(Temporal、Restate、DBOS、Inngest、Cloudflare Workflows)。 ↩
- Temporal, LangGraph integration(Temporal 承担耐久性时图内可用内存 checkpointer)。 ↩