AI harness 往环境里长:Anthropic 重做源码管理、游戏变成 harness、Codex 仓库,讲的是同一件事
10 月 13 日,Anthropic 工程博客发了一篇《Redesigning source control at Anthropic》,讲他们在五个月里把 monorepo 从 git 迁到自研的版本控制系统 Scion。原因写在第二段:今年 5 月公司平均每天合并约 2,500 个代码变更,到 9 月已经超过 30,000 个,源码管理、构建和 CI 这些按人类规模设计的基础设施成了最大的瓶颈。[1] 这篇帖子在 Hacker News 上截至 10 月 19 日有 894 分、上千条评论。[2] 同一天上 HN 的还有一篇小得多的文章,游戏开发者 Kyle Kukshtel 把自己的演讲整理成《Your Game Is A Harness》,讲怎么把一款游戏改造成 agent 能读懂、能操作的样子。[8][9]
一边是每天几万次合并的 AI 实验室,一边是独立游戏作者。OpenAI 今年 2 月那篇《Harness engineering》是第三种规模:几个工程师、一个从空仓库开始、全部由 Codex 写出来的产品。[16] 三篇放在一起读,说的是同一件事:写代码变便宜以后,决定 agent 能干多少活的,是它所在的环境能不能被查询、被复现、被度量、被拦住。 「harness」这个词也在跟着变,从 agent 外面那层循环,慢慢往下长进了仓库、引擎和 CI。
先说结论
- harness 的重心在下移。 站内之前拆过的 Claude Code、Strands、DeepSeek Harness,管的是 agent 主循环;这三个案例投入最多的地方,是 agent 碰到的环境本身。
- 四个共同性质:可查询、可复现、可度量、可约束。 Scion 把仓库问题做成服务端 API,游戏用种子和命令把状态钉死,Codex 仓库让日志、指标和 UI 都能被 agent 直接读。
- 合并和评审的规矩在被重写。 Anthropic 放弃了带全局锁的合并队列,改成合并后、部署前的自动测试,人审「意图」而不是逐行读代码;OpenAI 的阻塞性合并闸门也很少。
- 规模决定该投哪一层。 绝大多数团队用不上自研版本控制,但人人都用得上「让测试能无界面跑、输出是文字和数字」。
「harness」这个词在漂移
站内写 harness 的文章已经不少:Agent Harness 模式拆 Claude Code 的主循环,Strands Harness和 DeepSeek Harness讲怎么把这层循环做成可插拔的软件,Growing Harness讨论哪些控制决策该长成代码。这些文章里,harness 指的都是包在模型外面、驱动它调工具的那层运行时。
Kukshtel 用的是同一个词,意思已经往外扩了。他说 harness 是 agent 面对某类输入时要走的一套固定动作,Claude Code 是一个,但它可以被扩展、蒸馏、改写,去贴合你手上的具体工作;问题在于现有的 harness 都不会「跟你的游戏说话」,游戏对它们是黑盒,模型能看到的只有写出来的代码。[8] OpenAI 那篇说得更直接:工程团队的主要工作,变成了设计环境、说清意图、搭反馈回路,让 Codex 能可靠地干活;agent 卡住时,人要问的是「缺了什么能力,怎么让它对 agent 既看得见、又强制得了」。[16]
我的看法是,这不只是用词松了。主循环这一层已经被各家做得越来越像,差距开始出在循环外面:同一个 Claude Code,放进一个能无界面跑测试、能用一条命令复现 bug 的仓库,和放进一个只能靠人眼看画面的游戏工程,产出完全不是一回事。下面三节分别看三个案例在环境里动了什么。
Scion:当仓库的客户端几乎全是 agent
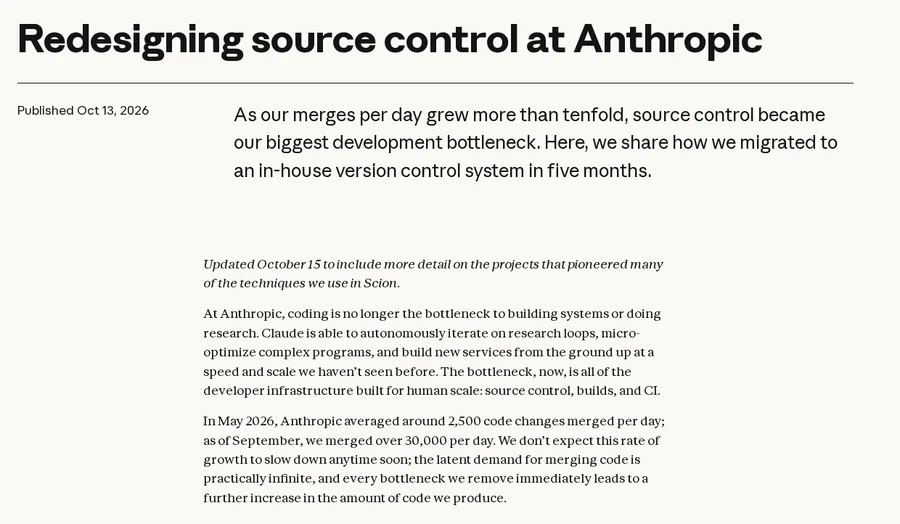
截图:Anthropic 工程博客原文开头,10 月 15 日更新过一次[1]
Anthropic 先承认自己的负载很特殊。主干历史接近 100 GB,压缩后的工作副本超过 25 GB,光 CI 每天就要检出约 2,500 万次,还没算开发环境、agent 沙箱和研究任务;如果每次都老老实实拉取,一天的 git 流量会超过 600 PB。[1] 浅克隆、稀疏检出、promisor remote、内部镜像、blob 存储里的仓库快照,这些常规办法他们都用过,最多时运营着几百个内部 git 镜像。合并速度一上来,快照离主干越来越远,依赖历史的操作(diff、blame)在部分克隆上也越来越难维持。
他们回头看到的问题是:git 的前提是每个副本都能离线工作,可他们其实把 git 当集中式系统用,而且几乎所有客户端都是天然在线的 agent 和 CI 任务。于是问题变成:如果从一开始就假设客户端永远在线,源码管理该长什么样?[1]
图:git 镜像方案与 Scion 分层缓存的对照,数字均为 Anthropic 文中自述[1]
答案是服务端和客户端彻底不对称。Scion 的服务端负责回答文件历史和 blame、创建提交、做合并和 rebase;客户端只维护一个有界的本地对象缓存,按需取树和 blob,几乎不自己计算。[1] 提交的单位叫 changeset,是预写日志里的一条记录,只存改了哪些文件和指向 blob 存储的地址。blame、路径历史这些都算「派生数据」,按父提交递归算出,可以立即算也可以用到再算。ref 被刻意少用,移动一个 ref 只是对 Spanner 里一行做比较并交换。
对 agent 来说,这一层最关键的变化是:仓库从「一个要先下载下来的东西」变成「一个可以直接提问的服务」。CI 任务要拿某个提交和合并基点之间的 diff,问服务端就行,不需要工作副本;很多写操作也能完全通过 API 完成。Anthropic 说内部的自动 bisect 和自动 revert 流水线,没有这种便宜的程序化访问就做不到这个规模。[1] 有人问为什么不支持离线攒提交,作者 Nick G. 回答:可以做,但客户端就得学会服务端的所有本事,照样答不了历史、blame 这类全图问题;而 Scion 最重的用户 Claude 必然在线。[3]
迁移后的效果见上图,数字都来自 Anthropic 自述。[1]
合并队列撑不住以后
比存储层更值得普通团队琢磨的,是文章后半段对流程的改动。
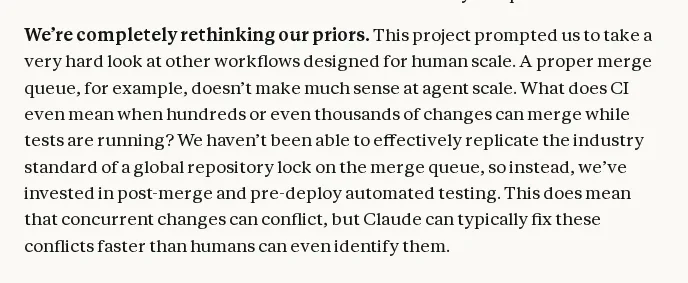
截图:Anthropic 说合并队列在 agent 规模下「没多大意义」[1]
带全局仓库锁的合并队列是业界常规,可当测试还在跑、就有成百上千个变更合进来时,这把锁没法维持。Anthropic 的做法是把检查挪到合并之后和部署之前,代价是并发变更会冲突,他们的说法是 Claude 修这些冲突的速度,比人发现它们还快。[1] 作者在评论里补了一句,现在常见的是一个人对接几个编排 agent、编排 agent 再管一组 agent,怎么让这些 agent 写代码时少互相冲突,他们还在想办法。[4]
图:合并队列与 Anthropic 现行流程的对照;OpenAI 的做法见下文[1][16]
锁拿掉之后,安全网换成了别的东西。Scion 支持对单个目录设权限,代码评审工具 Antique 能表达语义化的审批规则,区分只改注释的变更和敏感的逻辑变更,让人把注意力放在后果最重的地方。[1] 每个组件还配了一个 Claude「superfan」,在专门的 Slack 频道里盯着遥测和日志,像一个除了刷图表没别的事干的老工程师;传统告警照留。
人的角色也写得很直白:做这个系统的工程师都认为 Claude 写代码比自己强,但很多时候工程师的工作就是对 Claude 说「不」。
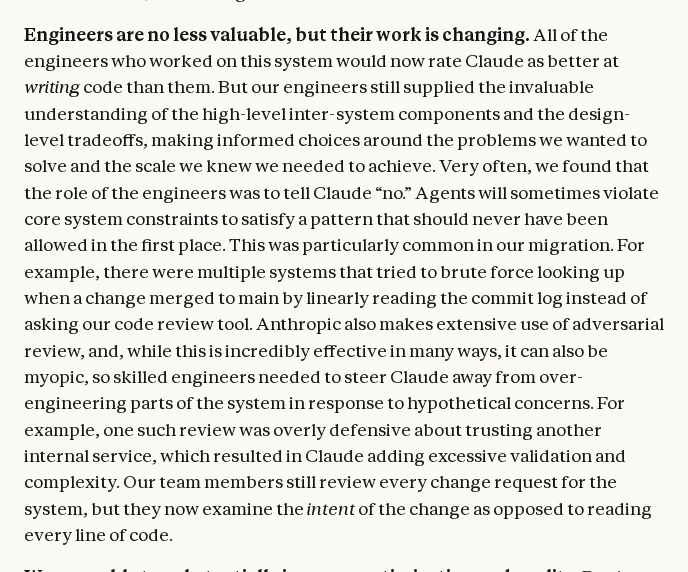
截图:Anthropic 对工程师角色变化的描述[1]
文中的例子很具体:迁移期间好几个系统想靠线性扫描提交日志来查变更何时合入主干,而不去问评审工具;有一轮对抗式评审对另一个内部服务过度戒备,让 Claude 加了一堆多余校验。团队仍然审每一个变更请求,但看的是变更的意图,不再逐行读代码。[1]
这里我跟 HN 上最高赞的那条质疑站在一边。duttish 说,他每次停止审 Claude 的代码,过后总能翻出糟糕的东西,所以不敢不审。[21] 「审意图」能成立,前提是上面那些东西都在:密集的模拟测试、模糊测试、目录权限、superfan 盯着的遥测和随时能用的自动 revert。这些不在的团队照搬「只审意图」,等于把评审拿掉了。站内那篇《Coding agent 产出更多代码,不等于产出更多软件》里的数据也指向同一处:写的一端变宽了,审的一端就会被拉长,靠省掉评审换不来交付。
五个月这个数,要连着来历一起读
Scion 那篇文章的开头有一行斜体:10 月 15 日更新,补充了开创这些技术的项目的细节。更新的起因是 Meta 前源码管理工程师 Rain(sunshowers)在 10 月 14 日写文章指出,Scion 的「派生数据」概念和 Meta 的 Mononoke 服务端几乎一样,而原文只把 Sapling 列为「来之不易的经验」,没有提 Mononoke。[5] 第二天她又写了一篇,说 Scion 的 changeset 和 Mononoke 的 Bonsai changeset 是同一个数据模型,围绕它的服务端查询接口也相似,并称两边有人员重叠。[6]
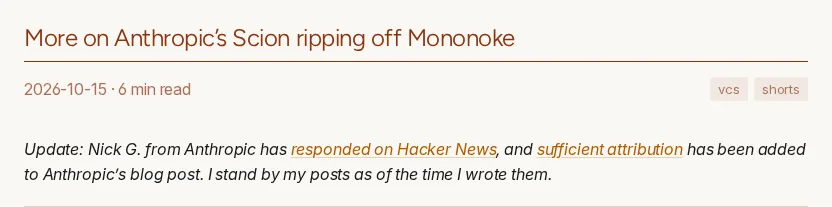
截图:sunshowers 的第二篇文章,顶部更新说 Anthropic 已补上署名[6]
现在 Anthropic 原文的脚注写明,所说的 Sapling 具体指它的服务端 Mononoke,Scion 用到的很多技术由它开创,尤其是 Bonsai 数据模型。[1] Mononoke 的公开文档也能对上:它内部以 Bonsai changeset 为规范格式,再按需转换成 Mercurial 客户端要的格式。[7] sunshowers 本人在更新里说署名已经足够。
署名之争看两边的更新就够了,它更大的影响是改变了「七个人五个月做完一套版本控制」该怎么理解。Rain 自己的说法是,指着一个现成的系统在这么短时间里重建出来,依然很惊人。[6] 我觉得对普通团队更有用的读法也在这里:agent 擅长的是在有成熟先例的设计上快速实现,Mononoke 是开源的,用 Rain 的话说,它在每个模型的训练数据里[5];它不等于你可以让 agent 从零发明一套分布式系统。作者在 HN 上也说,重点不是让大家自己 vibe-code 一个版本控制系统,很多思路能直接用回 git。[2]
游戏:把黑盒拆开
Kukshtel 的出发点是一句很多游戏开发者都说过的话:「LLM 不擅长做游戏」。他的解释是,web 应用里几乎一切都是代码,模型能读、能改;游戏里大量东西不是代码,场景、资源、运行时状态对模型都是不透明的,一个依赖操纵这些不透明东西的游戏,agent 一碰就倒。所以在他看来,这是上下文问题,不是游戏或模型本身的问题。[8]
截图:Kukshtel 的文章由 9 月 12 日卡尔加里 Indie Rodeo 的演讲整理而来[8]
他给的办法是一串彼此依赖的架构决定,核心是确定性。游戏一开始就只建一个带种子的随机源,所有不确定的调用都走它,这样第 30 次随机调用每次都一样。存档读档从第一天起就做,而且全游戏只有一种对象类型 Thing,类型差异用枚举表达,序列化只有一条进、一条出的路,模型也不用在一百个类之间猜该扩展哪个。状态修改走命令模式,命令是可序列化的对象,所以玩家的一串操作能原样回放,agent 也能在文本编辑器里写一串命令丢给运行中的游戏,不需要编译。数值放在游戏外面,改移动速度不用重新出构建。
最后一步是把模拟从引擎里拿出来,做成独立的库。引擎只发命令、只照着模拟核返回的状态渲染,不自己判断;这样网络、agent、测试都能往模拟核发命令,测试可以用纯 C# 项目跑,不用启动引擎。[8]
图:Kukshtel 的「游戏即 harness」结构,前提越早做越便宜[8]
度量那一端,他特别提醒截图会污染上下文:前后两张截图丢给多模态模型,它很难看出到底改了什么、离目标近了没有。他的做法是用 odiff 做图像 diff,输出差异图和「85% 相似」这种数字,让 agent 每一轮都有稳定的基准;性能用 samply 这类能把采样结果输出成文字的工具,因为为人眼设计的图形化 profiler,agent 读不了。[8][19][20]
这套思路不是孤例。Vectarine 引擎的文档有一页《Working with agents》,开头就说这页「主要写给 agent 看」:测试是 TOML 文件,能无窗口跑游戏、截图、模拟按键、在游戏里执行 Luau 代码;测试运行器每帧推进精确的 1/60 秒、给随机数播种,像素差默认容忍 5%,两次跑出来不是 0% 差异就说明游戏里有不确定的东西。[15] 它还算了一笔账:起一次测试要几秒,一次逻辑更新只要几微秒,所以要写能在一步里跑完多组尝试的辅助函数。
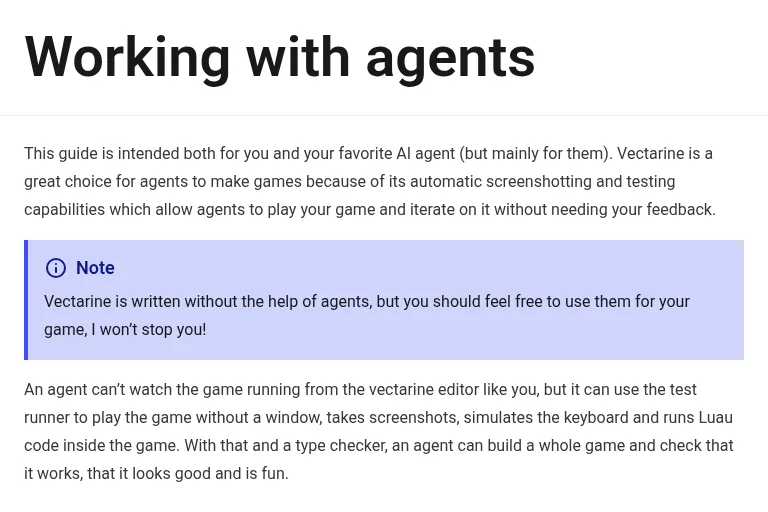
截图:Vectarine 的 agent 指南,和 Kukshtel 的结论几乎逐条对得上[15]
HN 上的实践者给了更朴素的版本。TeMPOraL 说他最有用的一句提示词是「想办法让游戏无界面运行,这样你折腾的时候我还能用电脑」,agent 做到了,从此能自己并行开好几个实例去验证假设。[10] simonw 做一个带回放的小 RTS 时发现回放在 Safari 里坏了、在 Chrome 里正常,最后模型把 Math.sin()、Math.cos() 换成了自己写的确定性实现。[11]

截图:一句提示词换来的并行验证能力[10]
反对意见值得认真听
游戏这条线的反驳很有分量,而且大多来自有多年经验的游戏开发者。
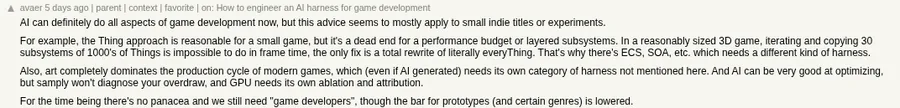
截图:avaer 认为这套建议主要适用于小型独立游戏[12]
avaer 说,Thing 这种胖结构在小游戏里没问题,但在中等规模的 3D 游戏里,每帧遍历和拷贝几十个子系统、成千上万个 Thing 根本做不完,这正是 ECS 和 SOA 存在的原因;美术占了现代游戏制作的大头,需要另一类 harness;samply 也诊断不了过度绘制,GPU 要有自己的归因手段。[12] 另一位做过 MMO 的开发者说得更尖锐:模型总想把一切都变成确定性的,可游戏除了模拟类以外并不是可验证的模拟器,为了迁就验证器,代码会出现大量反复改动和僵化。[13] 跨平台确定性本身也不便宜,着色器和图形差异不是一个定点数库能救的。
Kukshtel 自己在文末也承认,他正在发布的小项目一样都没用上,这套东西针对的是更大的项目。[8] 我觉得这句后记比正文还重要。这些手段都有成本,而成本在项目早期最低、在后期最高。它们的回报来自 agent 迭代的次数:迭代越多、越依赖 agent 自己验证,越值得投;一个周末的原型,不值得为它做独立模拟核。
还有一条意见我很认同,来自 drusepth:别让 LLM 去调转向半径、冻结帧这种手感上的细节,让它去造工具,让人调得更快。他们给一款 Steam 游戏做了大约一百个这类小工具,全是 LLM 写的。[14] 环境可读这件事,对人和对 agent 是同一笔投资。
Codex 仓库:把知识和规矩都搬进仓库
OpenAI 的案例在中间。规模不是 Anthropic 那样的几万次合并,团队用五个月从空仓库做到大约一百万行代码、合并约 1,500 个 PR,人从三个工程师增长到七个,平均每人每天 3.5 个 PR;他们估计耗时约为手写的十分之一。[16]
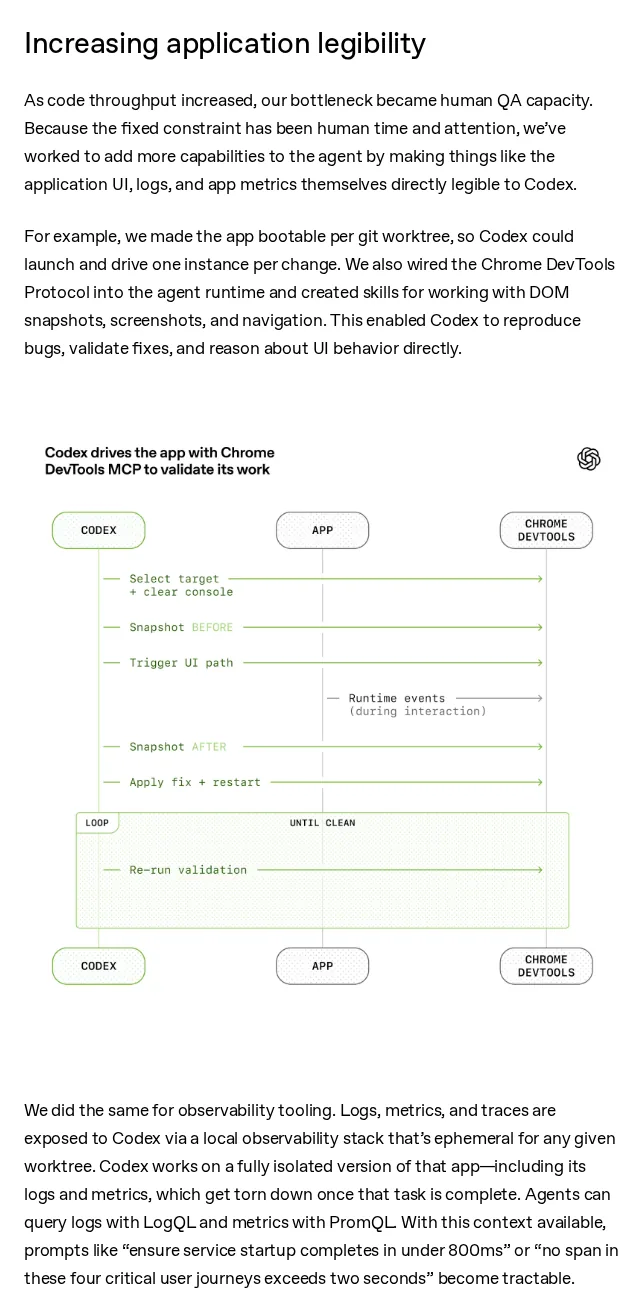
截图:OpenAI 让应用 UI、日志和指标直接对 Codex 可读[16]
第一个瓶颈是人做 QA 的能力,于是应用能按 git worktree 各起一份,Codex 每个改动开一个实例;把 Chrome DevTools Protocol 接进 agent 运行时,配上处理 DOM 快照、截图和导航的 skill;日志、指标和链路追踪通过一套随 worktree 起停的本地观测栈暴露出来,agent 用 LogQL 和 PromQL 查询。有了这些,「服务启动要在 800 毫秒内完成」这种要求才变得可以交给 agent。[16] 这和游戏那边的「无界面跑、输出数字」是同一个思路,只是换成了 web 服务。
知识那一侧,「一个大 AGENTS.md」的做法失败了:它挤掉任务的上下文,很快过时,也没法机械检查。现在的 AGENTS.md 只有大约一百行,当目录用,真正的知识放在结构化的 docs/ 里,由 linter 和 CI 检查新鲜度和交叉链接,还有一个定期跑的 agent 专门找过时文档、开修复 PR。[16] 站内《Progressive Disclosure》讨论过同样的分层加载问题。
规矩那一侧最值得抄的一个细节是:架构约束用自定义 lint 和结构测试强制执行,而 lint 的报错信息是专门写给 agent 的,里面直接带修复方法。[16] 人的品味写一次,之后对每一行代码自动生效。他们也讲了代价:Codex 会复制仓库里已有的模式,包括不好的那些,团队一度每周五花 20% 的时间清理「AI slop」,后来改成把「黄金原则」写进仓库、让后台任务定期扫描偏差、开小的重构 PR。合并上,他们和 Anthropic 走到了同一边:阻塞性的合并闸门很少,PR 寿命很短,flaky 测试常常靠重跑解决;文章自己也说,这在低吞吐的环境里是不负责任的。[16]
四个共同性质
把三个案例摆在一起,环境层的投入可以归成四个性质。
| 性质 | Scion(Anthropic) | 游戏 harness(Kukshtel、Vectarine) | Codex 仓库(OpenAI) |
|---|---|---|---|
| 可查询 | blame、历史、diff 都是服务端 API,任务不必有本地仓库 | 状态是一张 Thing 列表,测试能直接读 | UI、日志、指标经 CDP、LogQL、PromQL 暴露 |
| 可复现 | 内容寻址、不可变的 changeset,提交哈希「在哪都能用」 | 单一种子、命令回放、精确的帧步长 | 每个 worktree 一份应用和观测栈 |
| 可度量 | 每层缓存命中率、superfan 盯遥测 | odiff 相似度、samply 文本采样、像素差阈值 | 启动时间、链路耗时这类可断言的指标 |
| 可约束 | 目录权限、语义化审批、人审意图 | 模拟核是唯一的状态来源,引擎不做判断 | 分层依赖规则、带修复说明的 lint |
表里没有一项是新发明。确定性、命令模式、黑盒游戏架构在游戏圈讲了很多年,服务端版本控制有 Piper、Mononoke 在前,分层和 lint 更是老生常谈。HN 上有人调侃,发明了 AI 之后,大家才开始在乎可调试性和迭代速度。[9] 我不觉得这是在挖苦。差别在于杠杆:这些做法以前只省人的时间,现在还决定 agent 每轮迭代是几秒还是几分钟,以及它能不能自己判断改对了没有。
按规模决定先投哪一层
下面是我会给一个团队的顺序,从几乎所有人都该做的开始。
- 让验证能无界面跑,输出文字和数字。 不管是 web 服务还是游戏,先保证 agent 不用看屏幕就能知道改动成没成:测试能命令行跑,失败信息说清楚原因,截图类检查给出差异百分比。这一步成本最低,回报最直接。
- 把不确定性收拢。 随机数统一播种,时间从外部传入,跨平台数学函数换成确定性实现;判断标准是同一个测试连跑两次结果完全一致。
- 给每个改动一个隔离的环境。 按 worktree 起应用和观测栈,让 agent 可以并行开实例,用完即删。
- 把规矩写成会报错的代码。 架构边界、命名、文件大小写成 lint 和结构测试,报错信息里写怎么修;
AGENTS.md只当目录。 - 最后才动合并流程和版本控制。 合并前的检查真成了瓶颈,再考虑把一部分检查挪到合并之后,前提是自动 revert、监控和权限都已经到位。仓库真的大到 git 吃不消时,先看 ERSC 这类「对外讲 git 协议、底层换存储」的方案和 jj 的多后端,自研是最后的选项。[17][18]
大部分团队停在第三步就已经很好。Anthropic 在文中自己也说,Scion 只对体量极大的 monorepo 有意义,而且它能花的 token 远超一般公司愿意花的。[1]
落地时常踩的坑
- agent 绕开正确的接口。 Anthropic 的例子是扫提交日志而不去问评审工具。办法是把正确的接口做得最便宜,再用 lint 或权限把错的那条路堵上。
- 对抗式评审把系统做重。 agent 互相挑刺会对假想风险过度设防,评审规则里要写明信任边界。
- 截图当证据。 把整张截图丢给模型,它会被无关区域带偏。先关掉无关图层或裁剪,再用 diff 数字说话。
- 确定性只做了一半。 模拟状态确定了,GPU 输出和跨平台图形仍然不同;如果渲染结果会反馈回逻辑,这部分要单独处理。
- 文档变成垃圾场。 越写越长的规则文件很快没人维护。拆小、加机械检查、定期让 agent 清理。
- 把别人的吞吐当目标。 每天三万次合并是 Anthropic 的负载,不是行业标准。[2]
结语
三篇文章各有可挑剔的地方:Scion 的署名起初没做到位,游戏 harness 在大项目里会碰到性能和美术的墙,Codex 仓库的做法 OpenAI 自己也说未必能推广。但方向一致:主循环那层越来越标准化,拉开差距的是 agent 所处的环境。下次 agent 在你的项目里反复失败,先别急着换模型,问一句 OpenAI 那篇里的话:缺的是什么能力,怎么让它对 agent 看得见、也强制得了。
参考来源
- Anthropic. Redesigning source control at Anthropic(2026-10-13,10-15 更新):https://www.anthropic.com/engineering/redesigning-source-control ↩
- Hacker News.「Redesigning source control at Anthropic」讨论串:https://news.ycombinator.com/item?id=50073633 ↩
- Hacker News. nickg-anthropic 评论:为什么不做离线提交缓冲:https://news.ycombinator.com/item?id=50079495 ↩
- Hacker News. nickg-anthropic 评论:多层编排 agent 与并发冲突:https://news.ycombinator.com/item?id=50078031 ↩
- sunshowers. Anthropic’s Scion is heavily inspired by Mononoke(2026-10-14):https://sunshowers.io/posts/anthropic-mononoke/ ↩
- sunshowers. More on Anthropic’s Scion ripping off Mononoke(2026-10-15):https://sunshowers.io/posts/anthropic-mononoke-2/ ↩
- facebook/sapling. Mononoke 文档:Mercurial and Sapling Support:https://github.com/facebook/sapling/blob/main/eden/mononoke/docs/5.2-mercurial-sapling-support.md ↩
- Kyle Kukshtel. Your Game Is A Harness(2026-10-10):https://kylekukshtel.com/ai-harness-engineering-game-development-claude-code ↩
- Hacker News.「How to engineer an AI harness for game development」讨论串:https://news.ycombinator.com/item?id=50072120 ↩
- Hacker News. TeMPOraL 评论:让游戏无界面运行:https://news.ycombinator.com/item?id=50080720 ↩
- Hacker News. simonw 评论:回放在 Safari 中失效与确定性三角函数:https://news.ycombinator.com/item?id=50074610 ↩
- Hacker News. avaer 评论:Thing、ECS 与美术 harness:https://news.ycombinator.com/item?id=50075724 ↩
- Hacker News. dudeinhawaii 评论:确定性与游戏的可验证性:https://news.ycombinator.com/item?id=50078115 ↩
- Hacker News. drusepth 评论:让 LLM 造调参工具:https://news.ycombinator.com/item?id=50078259 ↩
- Vectarine. Working with agents:https://vectarineengine.com/guides/working-with-agents/ ↩
- OpenAI. Harness engineering: leveraging Codex in an agent-first world(2026-02-11):https://openai.com/index/harness-engineering/ ↩
- East River Source Control. What comes after git(2026-09-10):https://ersc.io/blog/what-comes-after-git ↩
- Hacker News. steveklabnik 评论:ERSC 的 git 兼容层:https://news.ycombinator.com/item?id=50075405 ↩
- dmtrKovalenko/odiff:https://github.com/dmtrKovalenko/odiff ↩
- mstange/samply:https://github.com/mstange/samply ↩
- Hacker News. duttish 评论:停止审查后总会发现问题:https://news.ycombinator.com/item?id=50082912 ↩