OpenRouter 上怎么给 coding agent 选型、门禁和分级升级
做 coding agent 的人,每周都会碰到同一类决策:默认模型换不换、提示词改完要不要挡合并、便宜模型答不稳时要不要再打一枪更贵的。排行榜给不了答案——榜平均的是别人的任务;你的 agent 是窄任务、多步工具调用、还要为重试付钱。OpenRouter 在 2026-10-01 连发了三篇操作向材料:用自有样例画成本/质量点来选型、在 CI 里把 LLM eval 当合并门禁、按模型自报置信度分级升级。[1][2][3] 这篇把它们串成一条可落地的流水线,并补上官方路由/回退文档、FrugalGPT / RouteLLM 的经典数字,以及站内已经写过的评测可靠性对照。目标读者是在做 agent 产品的工程师,不是 OpenRouter 的产品简介。
和站内文章的关系:控 harness 控成本谈企业路由与账单责任在 harness;Haiku 5.5 当 subagent 的成本账和 DeepSeek Flash 便宜在哪谈单模型计价形状;Coding Agent 烧钱的三种习惯谈轨迹层浪费;Agent 评测可靠性和 CIR 因果评测谈「分数到底支持什么主张」。本文停在选型—门禁—升级三层操作,不重复价目表算术。
先把四条路摆在一张桌上,后面每一节都在拆其中一格为什么会踩坑。
| 策略 | 你在优化什么 | 典型信号 | 主要坑 |
|---|---|---|---|
| 按排行榜选默认模型 | 「最强」 | 公开基准名次 | 任务分布对不上;agent 多步成本被低估 |
| 自有样例上的成本/质量前沿 | 「过质量线里最便宜的」 | 20–50 条自有样例 + usage.cost | 样例太小、分数抖动没留余量 |
| 网关/市场路由器(含 Auto) | 「少改代码换模型」 | 任务分类 + 市场花费份额 | 市场最优 ≠ 你的 SLA;同 slug 多 provider 质量差 |
| 置信度分级升级 | 「便宜模型能接就接」 | 结构化 confidence 字段 | 自报分未校准;和错误回退混用 |
先说结论:三层,而不是一个开关
- 选型层:每个任务先定质量线,再在自有样例上算「每质量分成本」,取过线且有余量的最便宜者。[1]
- 门禁层:提示词、工具 schema、agent 逻辑的改动要过固定 eval 集;阈值从「未改动分支反复跑」测得的 floor 来,不是拍脑袋的 0.9。[2]
- 运行层:错误回退(
models数组 / provider failover)和置信度升级是两件事——前者在请求失败时换模型,后者在「答了但没把握」时换模型。[3][4]
一句话:**排行榜帮你列候选,自有前沿帮你定默认,CI 帮你防回退,置信度帮你按请求付溢价。**下面按机制展开。
成本/质量前沿:用自己的点,不要用别人的榜
OpenRouter 那篇选型框架的核心句子很直白:问题不是谁分最高,而是谁是过线里最便宜的。[1] Agent 任务往往很窄——分诊工单、抽一个字段、不确定就升级——便宜模型能不能摸到和前沿模型一样的准确率,只能量,榜代劳不了。
三步操作:
- **先定质量线。**合规/医疗/法务可以设很高;高流量客服可以接受「九成常规正确、一成干净升级」。延迟敏感任务要把「太慢」也当成直接出局。[1]
- **在 20–50 条自有样例上跑便宜 / 中档 / 前沿各一档。**打分用同一套 rubric;确定性任务用精确匹配,开放题再用 LLM-as-judge。成本读响应里的
usage.cost(OpenRouter 在非流式与流式最后一条消息都会带),不要拿价目表乘自己估的 token。[1] - **取过线且余量大于跨次抖动的最便宜者。**余量来自观察:同一候选多跑几次或换一批流量,看分数摆多大幅,要求赢家比线高出这个摆幅。[1]
他们给的示意表(价目取 2026-09-18 目录价;token 与质量分为示意)在 85 分线上是这样读的:GPT-5.6 Luna 每千次约 0.32 美元、分 82,出局;Gemini 3.7 Flash 约 1.09 美元、分 89,过线 +4;Claude Opus 5 约 7.25 美元、分 97,过线但贵六倍多。过线后取便宜的,Flash 入选。[1]
图:把三个候选画在「每千次成本 × 质量分」平面上;质量线以下直接出局,线上取最便宜。数字来自 OpenRouter 示意表[1]。
换任务,答案就换。同一篇文章里:客服分诊质量线 80、便宜档即可;代码审查 88、中档;合规审查 95、只能上前沿。[1] **方法一样,线不一样。**价目和模型版本会变——他们举例 2026-05 到 09 四个月里 Gemini Flash 上了四个版本——所以脚本和样例集要留下来,模型或价格一变就重跑。[1]
边界条件:
- 样例太少:三五条只能做冒烟,定不了余量。Anthropic 的 agent eval 指南也建议从真实失败里抽 20–50 个简单任务起步(OpenRouter CI 文引用)。[2]
- 只比单轮:agent 会为工具调用和重试付多轮钱;要用「完整跑完一次任务」的
usage.cost合计,而不是首轮补全价。[1] - 榜上第一当默认:站内 Agent 评测可靠性已经说明,模型排序的可靠度往往远低于「固定模型–scaffold 系统」排序;堆同类任务也抬不高多少。[5] 用公开榜给自己的 agent 定默认模型,主张和测量对不上。
网关层:provider 路由、错误回退、Auto,各自管什么
选型定的是逻辑模型;线上请求还要落到具体 provider 端点。OpenRouter 文档把几件事分得很清:
**Provider 选择。**默认按价格负载均衡:先避开近 30 秒内明显故障的端点,再在稳定端点里按价格平方倒数加权,其余做后备。[6] 你可以用 provider.order 指定优先级,allow_fallbacks: false 禁止落到名单外,require_parameters: true 只走支持你全部参数的端点,sort 按价格 / 吞吐 / 延迟排,以及 preferred_min_throughput / preferred_max_latency 等软偏好。[6]
模型错误回退。请求体里的 models 数组按优先级尝试;主模型因宕机、限流、审核拒绝、上下文长度校验等报错时,才试下一个。按最终答出来的那个模型计价,响应里的 model 字段会告诉你是谁。[4] Anthropic Messages 端点的 fallbacks 最多 3 条,且不能和 models 同用。[4]
**Auto Router(openrouter/auto)。**按提示词分类到约 30 种细粒度任务类型,再按该类型近 7 天社区花费份额排序,套上你的 cost_tier(low / medium / high / xhigh / max),形成主选加回退;分类或排名不可用时降级到默认集合,请求不会因为路由基础设施挂掉而失败。[7] 多轮会话会尽量粘住上一轮模型(session_id 或消息指纹),任务类型变了可以换。[7]
这三层都不是「按置信度升级」。OpenRouter 自己写明:models 回退看的是错误,不是「有效但低置信」的答案;置信度路由要你自己写。[3]
实践里还有一刀,来自跑过大量 OpenRouter 流量的工程文(后上 HN):同一模型 slug 在不同 provider 上,工具调用基准可以差一截——作者举例 DeepSeek V4 Flash 在首方与 DigitalOcean 上 TAU-Bench Airline 约 81% 对 58%;量化过滤也不等于质量过滤;reasoning.effort 在部分 provider 上会被静默忽略;钉死三家「可靠」provider 两周后仍可能集体 429。[8] CI 门禁文因此要求评测请求 provider.order 钉死一家并 allow_fallbacks: false,否则「换了 provider」会被误读成「提示词回退」。[2]
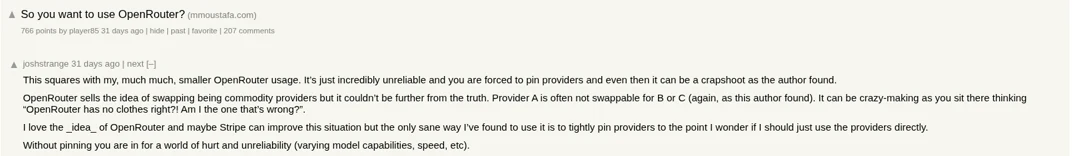
截图:Mo Moustafa 那篇实践文上 HN 后 766 分、207 条评论;首条评论说自己用量小得多,也只能把 provider 钉死才稳定(Hacker News 原帖,2026-10 截取)[8]
CI 门禁:把 eval 当成会挡合并的单元测试
提示词改一行,客服 agent 就能把「14 天退款」说成「30 天」——普通 CI 不会查模型说了什么。[2] 门禁的做法和挡失败单测一样:仓库里放固定 eval 集,相关文件一改就跑,通过率低于阈值就非零退出。
四步骨架(细节以 OpenRouter 教程为准):[2]
- **触发范围用 job 级过滤,不要用 workflow 级
on.pull_request.paths。**GitHub 对「整个 workflow 被 path 跳过」会让关联 check 停在 Pending,required check 反而卡住合并;job 被if跳过则算通过,无关 PR 才能合。[2] 用dorny/paths-filter产出agent: true/false,eval 作业needs它。把 changes 和 eval-gate 都设成 required——只 require eval-gate 时,filter 作业自己挂了会导致 eval 被跳过并显示通过。[2] - **eval 集与提示词同仓、同 PR 改。**每个 case 带
mustMention/mustNotMention;同义表达用字符串列表(「human / person / our team」任一条即可),避免模型换个说法就被判死。[2] CODEOWNERS 护住prompts/与eval-sets/,并打开「Require review from Code Owners」,否则最快的过关方式是改松测试。[2] - 脚本对每案多次采样、多数表决;exit 1 表示质量回退,exit 2 表示评测根本没跑起来(空集、坏参数、provider 超时),避免「空数组得到 NaN 通过率却过线」。[2]
- **阈值从 floor 来:**在未改动的 main 上连跑六次(能更多更好),取最低通过率当 floor,阈值设在它下面或贴着它。三案集合的通过率只有 0 / 0.33 / 0.67 / 1.00 四档,阈值 0.9 实际等于「三案全过」——这也是集合要往 20+ 长的原因。[2]
图:路径过滤 → 跑 eval → 对照测得阈值;exit 1/2 分开质量回退与基础设施失败。依据[2]。
噪声怎么压:先查断言是不是过严;再查模型的 supported_parameters 里有没有 temperature/seed——OpenRouter 目录在 2026-09-18 约 445 个模型里,同时列出两者的 267 个,约五分之二缺一或缺俩;Claude Sonnet 5 一类会静默忽略温度。[2] 剩下的抖动用奇数次采样多数表决吸收。PR 只差一案失败时,对 main 重跑同一套:main 也挂 → 噪声;main 过 → 当回归。[2]
和站内评测文的对照:Agent 评测可靠性强调可靠度是主张依赖的——系统排序可以很稳,模型排序未必;CI 门禁测的是「这版 prompt+harness 有没有回退」,主张要对准「系统」,别把「过了三案字符串断言」说成「模型变强了」。[5] CIR提醒平均成功率会抹平 rescue 与 harm;门禁里的字符串断言同样可能「平均看起来稳、单案伤害被掩盖」,所以失败案要留 trace(教程脚本用 ./x 打出每次采样)。[9][2]
工具调用 agent 超出「一问一答」时,教程指向 Ori Eval:断言可以写「调了 lookup_order、没调 issue_refund」,并用另一模型族做 judge;judge 上线前要先和人判对齐。[2] 平台(DeepEval / Braintrust / Arize / Galileo)加的是历史与看板,exit code 模式不变——先从脚本开始。[2]
置信度升级:排序可用,绝对值别信
发送每一请求到最强模型,等于给便宜模型本可以答对的请求付前沿价;按关键词/任务类型写死路由,流量一变规则就过期。[3] 置信度升级夹在中间:让模型在结构化输出里带回 0–1 的 confidence,高于阈值留下,低于阈值再打更强模型。[3]
关键澄清——OpenRouter 原文几乎整段都在打这个点:自报分不是校准概率。0.85 不是「85% 会答对」;不同提示、不同模型上的 0.85 也不能互换。你能用的是排序:在自有流量上按分箱看错误率,若低分段错得多、高分段错得少,排序就可用于路由。[3]
他们的算术示意(200 条代表流量,非你的阈值):≥0.95 约占 41%、错约 1%;0.85–0.94 约 27%、错约 4%;0.70–0.84 约 18%、错约 11%;0.50–0.69 约 9%、错约 34%;低于 0.50 约 5%、错约 61%。错误率在 0.70 以下陡升,候选阈值 0.7:约 14% 请求升级,留下的答案错误率大约从整体近 10% 降到约 4%。[3] 阈值上调到 0.85 会再吞掉 0.70–0.84 那箱,升级率约到 32%,留下错误率大约到 2%——准确率、成本、延迟一起动。[3]
图:便宜模型强制输出 confidence → 过线留下 / 不过线二次调用。示意误差带来自[3];与 models 错误回退分开。
实现要点:
- 用
response_format+ JSON Schema 强制answer/confidence;数值范围写在description里,而不是依赖minimum/maximum(Anthropic 严格模式不支持这类数值约束)。strict: true各家执行力度不同,解析后仍要校验。[3] provider.require_parameters: true,否则不支持 structured outputs 的端点仍可能接到请求并忽略参数。[3]- 代码里二选一:同一函数内重试更强模型(策略集中);或把便宜调用当第一遍并打日志(方便重标定)。两者都可再叠
models错误回退。[3] - 上线后盯三件事:分数分布、升级率、未升级答案的错误率。换便宜档/升级档、或流量变难,都要重做分箱。[3]
反例与误用:
- 全局一个阈值:退款政策问答和「取消会不会扣款」的错答代价不同。[3]
- 把自报 0.9 写成 SLA「正确率 90%」:主张不成立。[3]
- 用置信度替代评测门禁:校准漂移时,你会稳定地「很有信心地错」。门禁测的是改动有没有破坏行为;升级测的是单请求要不要加钱。
学术对照:级联与学习型路由早就在算这笔账
**FrugalGPT(Stanford,2023)**把省钱策略收成三类:提示适配、LLM 近似、LLM 级联;级联用打分函数决定是否接受当前答案,不接受再问下一个。实验里可在匹配最佳单模型表现时最高省约 98% 推理成本,或在同成本下相对 GPT-4 提升约 4% 准确率(视数据集而定;HEADLINES 上匹配 GPT-4 时从约 33.1 降到约 0.6 的成本单位,省约 98.3%)。[10] 和今天置信度升级的结构同构:都是「便宜先上、不可靠再升级」,差别在打分器是外挂回归模型还是模型自报。
RouteLLM(Berkeley / Anyscale 等,2024)学的是请求之前在强弱模型间选择的路由器(偏好数据 + 增强),强调每请求只打一个模型以控延迟。公开基准上可在不大伤质量的前提下把成本降到 一半以下(文中写 over 2×);矩阵分解路由器在增强数据上 MT Bench 的 CPT(50%) 可到约 13.4% 强模型调用(相对随机约 50%)。[11] 它和 OpenRouter Auto 的差别:RouteLLM 是你训的专用路由器;Auto 是市场花费份额的在线指数。[7][11]
对 agent 产品的含义:学术线证明「级联 / 路由」能大幅省钱;工程线要补上你的质量线、你的 floor、你的校准。没有这三样,98% 和 2× 都只是别人的曲线。
把三层嵌进同一条 agent 流水线
选型、门禁、升级不是三个独立项目,而是同一条流水线的三个闸门。一个常见接法是:
- 离线:用自有样例刷新默认模型表(任务类型 → 模型 ID → 质量线 → 上次标定日期)。表进仓,改表走 PR。
- 合并时:PR 若改了
prompts/、工具 schema、agent 逻辑或 eval 本身,CI 用当前默认模型(或 PR 指定的候选)跑固定集;不过线不能合。[2] - 在线:默认模型带 structured confidence;低分走升级模型。错误路径另挂
models回退,避免把超时当成「低置信」。[3][4] - 周更:价目或主候选版本变更的当周,重跑前沿脚本;升级阈值看未升级错误率有没有爬升。[1][3]
和 控 harness 控成本 的衔接:企业账单争论常停在价目表,那篇把责任挪到 harness 默认;本篇的「默认模型表 + CI 门禁 + 升级阈值」就是 harness 侧可提交进 Git 的控制面。和 Coding Agent 烧钱的三种习惯 的衔接:路由省下的钱,可能被「重复检索 / 重跑测试」吃回去——门禁和升级解决的是模型档位,轨迹层浪费要另开 Skills 或预算帽。
最小 eval 集怎么长:从三次真实事故各抽一案起步(教程里的退款窗口、过期例外、威胁升级就是这种形状),每事故一案进仓;集合到 20 以前,阈值解释要写成「允许挂几案」而不是「0.93 这种假精度」。[2] 打分从字符串断言开始;工具调用路径再迁到 Ori 一类能断言「调了哪个工具」的 harness。[2]
provider 钉死与高可用怎么并存:评测与标定阶段钉死,是为了让方差来自提示词而不是端点;生产阶段用短名单 order + 受控 allow_fallbacks,并订阅 per-provider 板——同一权重在工具调用任务上差二十个点时,负载均衡等于随机降质。[8][2] Auto Router 适合「还没定任务分档、先要一个不丢人的默认」的探索期;一旦质量线写进合同或 SLA,就应退回显式模型 ID + 自有前沿。[7]
决策框架与检查清单
按任务定默认(选型)
- 质量线、延迟上限、错答代价写下来了(三选一冲突时谁让步)
- 有 20–50 条来自真实失败/真实流量的样例,不是公开榜子集
- 至少三档模型跑完,成本来自
usage.cost,分数同一 rubric - 赢家过线余量 ≥ 跨次摆幅;脚本和样例进仓
上线前(门禁)
- eval 集与 prompts 同仓;CODEOWNERS + required review
- job 级 path filter;changes 与 eval-gate 均为 required
- 阈值 ≤ main 上测得的 floor;采样为奇数;钉死 provider
- exit 1 / exit 2 分开;fork PR 策略想清楚(密钥不会进 fork workflow)
运行时(升级 + 回退)
- 错误回退与置信度升级代码路径分开
- confidence 来自 schema,解析后校验;
require_parameters: true - 阈值按任务类型分箱标定;监控未升级错误率
- 同 slug 多 provider:看贴合你工作负载的 per-provider 板,不盲信量化标签[8]
什么时候不要用某层
- 任务极窄且错答代价极低:可能只需要选型层的便宜默认,不必上置信度二次调用
- 监管要求「每次答复可追溯到固定模型版本」:Auto 与多 provider 负载均衡都要收紧到钉死
- 评测集还在剧烈改:先把门禁阈值放宽或只告警,避免用噪声训练团队「无视红叉」
最小可复现步骤(一天内能搭起来的骨架)
- 从生产日志抽 30 条,标金标签或可断言的必须含/不得含字符串;存
eval-sets/core.json。 - 写一个只换 model 字符串的脚本:读
usage.cost,打分,打印「分 / 每千次成本 / 每分成本」;先跑三档候选,定默认。[1] - 把同一 eval 集接进 GitHub Actions:paths-filter +
node scripts/run-evals.mjs --samples 3;在 main 上连跑六次记 floor,再写进--threshold。[2] - 给默认模型加 structured confidence;用历史 200 条做分箱,定第一个阈值;升级目标先选贵一档的中档,而不是直接跳到最贵。[3]
- 生产打开三张图:默认模型分数分布、升级率、未升级错误率;模型或价目变更当周重跑步骤 2。
代码块里不要假定 shell 变量展开;密钥用环境变量名 OPENROUTER_API_KEY 传入。CI 示例与 OpenRouter 教程同构时,记得把 provider.order 改成你的提供商标识,并与 --model 同步。[2]
边界条件与反例(收束)
- 示意数字当目标:Flash 每千次 1.09 美元、阈值 0.7、省 98%,都是别人的算术或旧模型市场;你的曲线要自己画。[1][3][10]
- 门禁绿了 = 产品好了:三案字符串门禁防的是已知回归,不是能力上界;集合要随生产事故增长。[2]
- Auto 替代产品策略:市场花费份额优化的是「社区在付什么」,不是「你的 SLA 要什么」。[7]
- 钉死 provider 当永久高可用:实践里三家同时恶化过;要有错误回退或降级文案,而不是假想名单永恒。[8]
- 置信度替代人审:高错答代价任务上,升级到更强模型仍可能错;人审/工具校验还在链上。[3]
选型、门禁、升级三层叠好之后,OpenRouter 对你更像一块「可换模型的底板」:目录价和 usage.cost 让前沿可算,provider 与 models 回退让错误可恢复,Auto 提供市场指数——但质量线、floor、校准仍然只能出在你自己的仓库里。
参考来源
- OpenRouter, Cost vs. Quality Tradeoff Framework for Agent Models(2026-10-01) ↩
- OpenRouter, How to Gate Pull Requests on LLM Evals in CI(2026-10-01) ↩
- OpenRouter, Confidence Thresholds for Model Escalation Routing(2026-10-01) ↩
- OpenRouter Docs, Model Fallbacks ↩
- 站内,Agent 评测可靠性:堆任务救不了排行榜;原论文 arXiv:2610.00651 ↩
- OpenRouter Docs, Provider Routing ↩
- OpenRouter Docs, Auto Router ↩
- Mo Moustafa, So you want to use OpenRouter?(2026-09-07);HN 讨论 item 49621546 ↩
- 站内,CIR:harness 恢复别只看平均成功率;原论文 arXiv:2610.00372 ↩
- Chen, Zaharia, Zou, FrugalGPT(arXiv:2305.05176) ↩
- Ong et al., RouteLLM(arXiv:2406.18665) ↩
- 站内对照:控 harness 控成本、Haiku 5.5 subagent 成本账、DeepSeek Flash 成本账、Coding Agent 烧钱的三种习惯