agent 记忆该装在哪一层:上下文数据库、团队记忆与轨迹转 Skill 的对照和选型框架(2026)
这两周有好几个仓库都把自己叫作「agent 记忆」:腾讯云的 TencentDB Agent Memory 和火山引擎的 OpenViking 的 README 上都挂着 GitHub 趋势榜当日第一的徽章,再加上 ai-memory、XERJ、Graphify 这类面向 coding agent 的工具。[1][3][5][6][7] 同一周,腾讯混元放出了一个专门负责「写记忆」的模型 Hy-Memory-30B-A3B,CopilotKit 的文档里多了一套把对话线程变成可发布 Skill 的流程。[8][9]
放在一起读,你会发现它们几乎没有在解决同一个问题。有的在管这一步的上下文窗口里该留什么,有的在管跨会话怎么记住一个用户,有的在管一个团队的 agent 共享哪些知识,有的在管做过的事怎么沉淀成下次的做法。「记忆」这个词把四件事揉成了一件,选型时最常见的错误就是拿一个层的工具去治另一层的病。
我的看法有三条,后面逐条展开。第一,先判断坏的是哪一层,再挑工具。第二,写入路径(谁决定记什么、怎么改写)比存储格式更决定质量。第三,这一批工具正在收敛到同一个做法:人能直接读和改的文件当真源,向量索引只是派生物。这个方向我认同,但它把一个新问题推到了台前:记忆仓本身成了信任边界。
先画地图:四层记忆,各答一个问题
图:agent 记忆的四层与对应的代表做法(示例取自各项目 README 与文档)[1][2][3][5][9][8]
这张图里的四层不是我发明的分类,而是把各家 README 里反复出现的概念摆在一起:TencentDB 把短期上下文和长期记忆分成两套机制,还把 Skill 生成单列为一层;OpenViking 把知识、记忆、Skill 放进同一个文件系统但分目录;ai-memory 强调跨 agent、跨项目、跨机器、跨团队;CopilotKit 只管程序性的那一块。[1][2][3][5][9]
层与层之间会互相借力,但症状和修法差别很大。下面按层讲。
第一层:任务内上下文,问题是「留多少」而不是「记多少」
IBM 的一段讲解把上下文窗口的坏法归成四种,我觉得是目前最好用的诊断表。[10] 它用的例子是一个迁移数据库驱动的 agent:系统提示和任务只有几行,后面堆着项目说明、工具定义、一小时的动作历史,最大的一块是文件内容、测试输出和错误日志这些工具结果。
图:上下文的四种坏法、对应修法,以及记忆系统里落地这些修法的机制(坏法与修法来自 IBM 讲解,机制来自各项目文档)[10][2][5][9]
四种坏法是:投毒,agent 读错了文档,给自己写了一条「新驱动会自动重试,旧的重试代码可以删」,之后它把自己的笔记当成事实,一个文件接一个文件地删掉好好的重试代码;分心,历史太长,模型照着自己过去的动作继续往下写;混淆,工具太多选错,讲解里引的一个基准中,同一个任务给 46 个工具失败、给 19 个工具通过;冲突,后来 agent 发现笔记错了,又记了一条更正,新旧两条同时留在窗口里。[10] 修法依次是验证、压缩、精选、剪除,四种修法都是扔掉一部分东西。
TencentDB Agent Memory 的短期记忆是我见过对「分心」最具体的回应。它把完整的工具日志外置到 refs/*.md,中间一层是逐步摘要的 jsonl,最上层把任务状态压成一张带 node_id 的 Mermaid 图,只有这张图留在上下文里;需要核对细节时,agent 按 node_id 去 grep 原文。[2] README 给的数字是在 50 个连续任务组成的长会话里测的:WideSearch 成功率从 33% 到 50%,token 从 221.31M 降到 85.64M;SWE-bench 从 58.4% 到 64.2%,token 少了约三分之一。[2] 这些是项目自报,和别家的数字不能横比。
我更看重的是它的设计取向:压缩可以有损,但不能不可回溯。这正好接上站内之前读过的 JitMem,那篇的论点是写入时就把轨迹蒸成固定的反思会造成不可逆损失,应该在读取时按任务重新合成。TencentDB 的折中是两头都要:上层给模型看高密度摘要,下层把原始证据留着,路径确定可以钻回去。[2] 对「冲突」这一类坏法,站内那篇 记忆改了不生效 讲过一个更麻烦的现象:新值就在上下文里,模型偏偏选旧值。这说明剪除不能只靠追加一条更正,得真的把旧条目拿掉或者明确标成作废。
第二层:个人长期记忆,写入路径决定上限
跨会话记住一个用户,是大家最熟悉的「记忆」。TencentDB 的长期记忆是一座四层金字塔:L0 原始对话,L1 原子事实,L2 场景块,L3 用户画像。日常偏好从画像层取,只有细节要紧时才往下钻到原子事实。[2] 底层事实和日志放数据库做全文检索,上层画像和场景存成人能读的 Markdown。README 给的 PersonaMem 准确率是从 48% 到 76%。[1]
OpenViking 的思路很像,只是把分层放到了目录上:每个目录带一份一句话的摘要(L0,默认生成预算 256 字符)和一份概览(L1,默认 4000 字符),完整内容(L2)只在需要时读取。[3][4] 它的文档里有一个细节值得注意:摘要是自底向上生成的,大目录里子文件变了,上层摘要不会马上刷新,而是先累计一个「待处理变更」计数,到比例阈值(默认 10%)才重算;在此之前摘要照样可读,只是已知落后于底层。[4] 这就是分层记忆的代价,模型最先看到的那一层,恰好是最可能过时的那一层。 它在 LoCoMo 上报告三种 agent 接入后准确率都落在 80% 到 83%,原生记忆是 24% 到 57%,输入 token 降 34.3% 到 91.0%。[3] 同样是项目自报,评测用的是豆包的模型。
这一层最有意思的证据反而来自一个模型发布。Hy-Memory-30B-A3B 是一个大约 3B 激活参数的写入模型,专门替换 Mem0、MemOS 这些记忆框架里负责「决定记什么、怎么改写」的那个通用 LLM。[8] 它的评测只换写入模型,检索配置、回答模型、裁判全都固定。在四个框架上的六项平均分里,Hy-Memory 是 55.49,Claude Opus 5 是 54.62,Qwen3-30B-A3B 是 44.37。[8] 同一个框架、同一个检索器,只换写入模型,平均分能差十一分。
这组数字让我更确定一件事:讨论记忆系统时,大家花很多时间比较存储(向量库、图、文件),但真正拉开差距的往往是写入那一步。写错了,后面检索得再准,取回来的也是错的。这也是 IBM 讲的「投毒」在长期记忆里的样子:一次写错,以后每一轮都会被当成事实召回。[10] 所以对长期记忆,我会先问三个问题:写入是谁触发的,写之前有没有核对,写错了能不能找到原始对话改回来。
第三层:项目和团队知识,真源正在回到文件
这一层的变化最明显。几个项目不约而同地放弃了「文本进去、向量出来、没人看得见存了什么」的黑盒,改成人能浏览和编辑的文件。
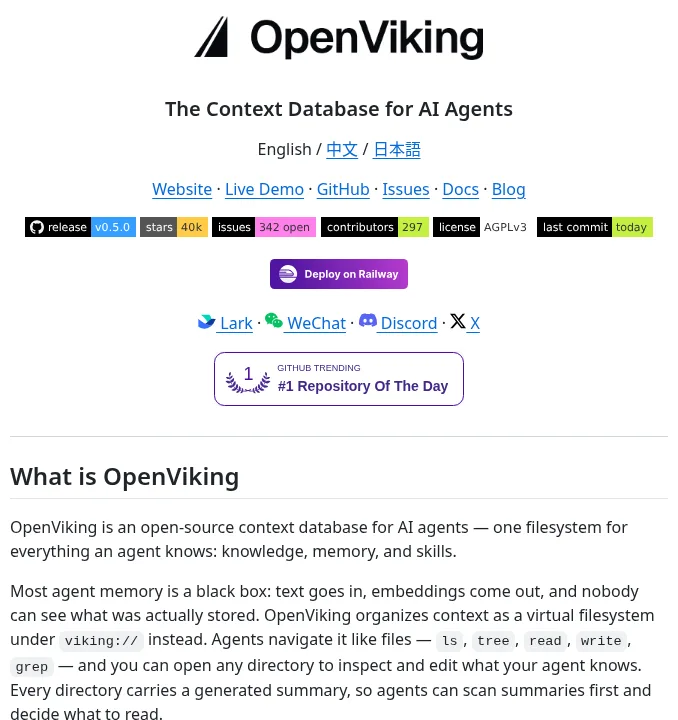
截图:OpenViking README 开头,说明它把知识、记忆和 Skill 放进一个 viking:// 文件系统(GitHub,2026-10-19 截取)[3]
OpenViking 把上下文组织成 viking:// 下的虚拟文件系统,resources/ 放文档和代码,user/{user_id}/memories/ 放偏好和经验,skills/ 放做法;agent 用 ls、tree、read、grep 去导航,语义检索可以限定在一个目录子树里,而不是扫整个向量池。[3] 会话提交以后,对话被归档,抽出的记忆是可以打开、编辑、合并的 Markdown。[3]
ai-memory 走得更彻底:真源是一个 git 管理的 Markdown wiki,数据库只是随时可以从文件重建的派生索引,没有向量库要维护。[5] 它解决的是另一个痛点:Claude Code、Cursor 都有自己的笔记,但笔记存在一台机器上、归一个 agent 所有,换工具或者交给同事就看不见了。ai-memory 让二十多个 harness 写同一份记忆,中途退出 Claude Code、在同一目录启动 Codex,下一个 agent 会拿到一份交接单,写着做到哪了、什么失败了、还有什么没解决;交接单有主人,只能被认领一次。[5] 记忆按层级定时衰减,被打开、被搜索、被链接到的页面衰减得更慢;冷掉的情节记忆可以压缩成文件路径、错误码、决定这类持久事实,近似重复会合并,疑似矛盾会被标记,而且这些默认都不调用 LLM。[5]
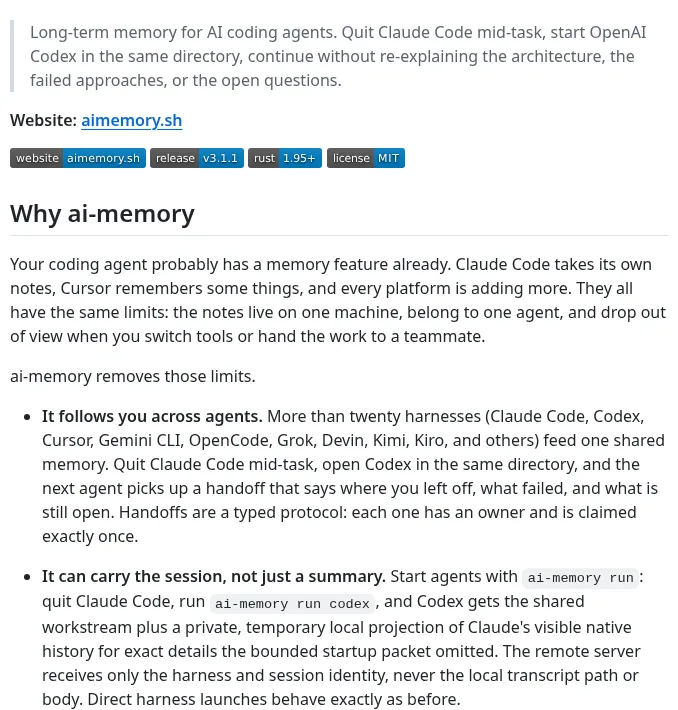
截图:ai-memory README 的「Why ai-memory」部分,讲跨 agent 交接与会话携带(GitHub,2026-10-19 截取)[5]
TencentDB 的默认分支已经换成了团队版 Memory Hub:从对话和任务里抽 Chat Memory 和 Skill,把文档变成 Wiki、把代码变成 CodeGraph;资产分 private、team、restricted 三种可见性,个人 Skill 默认私有,审核后才能分享给团队。[1] 接入方式是一个代理:把 agent 的 base URL 指向它就行,不需要插件、hook 或 MCP 服务。[1]
截图:TencentDB Agent Memory 默认分支 README,标注 Team Memory Beta(GitHub,2026-10-19 截取)[1]
代码库这一侧,XERJ 和 Graphify 是两种索引思路。XERJ 是本地搜索引擎,一条命令索引一个目录,agent 查询拿到的是段落和 file:line,而不是整份文件;它的对照实验是 8 个任务、4 种语言、每组 16 次运行,输出 token 从 grep 方案的 26,477 降到 9,982,解题数都是 16/16,只靠模型记忆的一组解了 11/16。[6] 它自己也写明,优势取决于模型有没有背过这段代码:私有、冷门或训练截止之后的代码收益大,模型早就熟悉的流行公开库上可能持平甚至更差。[6] Graphify 把一个文件夹做成知识图谱,自称每次查询比读原始文件少 71.5 倍 token。[7] 这两类工具严格说是检索层,不是记忆层,但团队知识的「读」这一半,很大程度要靠它们。
第四层:程序性记忆,关键在审核和版本
最后一层是把做过的事变成下次的做法。CopilotKit 的做法很像软件发布:先用自动学习收集对话线程、配置每日运行、审核生成的 Skill,然后发布到一个学习容器;agent 侧的适配器加一份按字母排序的 Skill 目录和两个只读工具,模型自己决定什么时候加载。[9] 有几条设计我觉得值得照抄:可以钉住一个确切的修订版本,也可以跟随最新;被撤销的修订一旦收到拒绝,新的调用就不能再用;Skill 不能覆盖 agent 的角色、安全规则、工具限制和应用策略;适配器从不执行 Skill 里的脚本,也不往磁盘写文件。[9]
TencentDB 的 Skill 库思路一致:一个 Skill 不只是一段提示,它有版本、资源文件、触发边界、执行步骤和验证规则。[1] 站内的 Agent Skills 2026 生命周期地图 讲过 Skill 从写出来到退役的全过程,这里补的是来源:越来越多的 Skill 不是人写的,而是从轨迹里蒸出来的。这样一来,审核这一步就从「锦上添花」变成了「必需」。从一次碰巧成功的轨迹里蒸出来的 Skill,会把碰巧的部分也固定下来,而且会被所有 agent 复用。
横切一刀:记忆仓就是信任边界
读这些 README 时,我最留意的是它们怎么写安全,因为记忆仓的风险和普通缓存不一样。
XERJ 的说明写得很直白:--insecure 会关掉 TLS 和 API key 认证,任何能连到端口的调用方都是超级用户,可以读取和删除所有索引,包括所有 /_memory 命名空间;所以新节点默认只绑定 127.0.0.1,绑定到其他网卡的明文监听会拒绝启动。[6] OpenViking 要求读写记忆用用户密钥,root 密钥反而不能读写记忆。[3] ai-memory 在存储之前,先在一个有类型的隐私边界上清洗钩子捕获的内容;接到团队服务器上时,跨项目的个人画像默认关闭,按人私有。[5] TencentDB 团队版用代理接管 base URL,这意味着代理能看到 agent 的全部流量。[1]
我的判断是:只要记忆会被自动写入,它就是一条把一次性的提示注入变成持久状态的通道。某次会话里读到一个恶意网页,写进了长期记忆,以后每个会话都会把它当成事实召回,这就是 IBM 说的投毒,只是来源换成了外部。[10] 所以选型时,「谁能写、写之前清洗什么、写错了能不能回滚」要和检索质量放在同一张表上看。文件做真源在这里有一个实际好处:git 历史本身就是审计记录,ai-memory 里没有内容被硬删除,旧版本留在 git 和版本链里可以恢复。[5]
常见踩坑
这些项目的文档里散落着不少「边界条件」,我把会直接影响选型的几条摘出来。
摘要层会过时,而且模型最先读它。 上面讲过 OpenViking 的上层摘要按阈值刷新。[4] TencentDB 的画像层也是从原子事实聚合出来的。[2] 所以凡是分层的方案,都要问一句:底层改了以后,上层多久跟上,跟上之前模型会不会按旧画像做决定。我的做法是给关键事实(比如「旧鉴权模块不能动,移动端还在用」)留一条不经聚合、直接读底层的路径。
缓存的 Skill 可能一直不更新。 CopilotKit 的适配器在第一次成功加载以后,遇到网络失败、超时或者服务器不可用,会继续用上一份快照并标记为过期,而且没有最长过期时间;断网的进程可以一直用最后一份验证过的快照,直到重启清空。[9] 这是为了可用性做的取舍,合理,但你得在监控里看 stale 这个状态,不然一份已经被你在后台修正过的 Skill,会在某台机器上继续生效很久。[9]
团队共享开得太早。 个人记忆里混着大量只对一个人成立的习惯和临时判断。TencentDB 让个人 Skill 默认私有、审核后才分享,ai-memory 让交接单保持私有、只共享项目知识,都是在处理这个问题。[1][5] 如果你的方案没有这一层区分,先别接团队服务器。
拿别家的基准数字横比。 PersonaMem、LoCoMo、WideSearch、tau2-bench、作者自建的编码任务,测的是完全不同的东西,回答模型和裁判也不一样。[1][2][3][6][8] 能用的只是每个项目自己的「开 / 关」前后差,以及 Hy-Memory 那种只换一个组件、其余全部固定的对照。真要选,就在自己的任务上做一次同样的固定对照。
以为装上就会用。 CopilotKit 的文档特意提醒,模型自己决定要不要调用 Skill 工具,一次运行里没有调用不代表投递失败;初始化成功也不代表容器里真有 Skill。[9] 记忆工具普遍有这个问题:存进去了,模型不取,效果就是零。上线后第一件事是看工具调用日志,而不是看存了多少条。
对照表
| 项目 | 主要所在层 | 真源 | 写入方式 | 共享 | 自报证据 |
|---|---|---|---|---|---|
| TencentDB Agent Memory | ①②③④ | 下层数据库,上层 Markdown | 自动捕获、抽取、聚合;Skill 审核后分享 | private / team / restricted | PersonaMem 48%→76%;长会话 WideSearch 33%→50%[1][2] |
| OpenViking | ②③ | viking:// 文件系统 | 提交会话后抽取为 Markdown | 按用户目录 | LoCoMo 80%–83%(原生 24%–57%)[3] |
| ai-memory | ②③ | git 里的 Markdown wiki | 钩子静默捕获,默认零 LLM 调用 | 按项目共享,交接单私有 | 未给基准数字[5] |
| CopilotKit 学习型 Skill | ④ | 已发布的 Skill 修订 | 线程→每日运行→审核→发布 | 按容器,可钉版本 | 未给基准数字[9] |
| XERJ | ③(检索) | 本地索引 | 一条命令自动索引目录 | 单机为主 | 输出 token 26,477→9,982,均 16/16[6] |
| Graphify | ③(检索) | graph.json 与 wiki | 读取文件抽概念和关系 | 文件 | 每次查询少 71.5 倍 token[7] |
| Hy-Memory-30B-A3B | ②(写入模型) | 不涉及 | 替换框架里的写入 LLM | 不涉及 | 四框架平均 55.49[8] |
表里的数字来自各项目自己的 README 或模型卡,基准、模型、设置都不同,只能看各自的前后差,不能跨行比较。
决策框架:按症状选,而不是按名字选
把上面的内容压成一组按顺序问的问题:
- agent 在一个长任务的后半段开始重复、跑偏、选错工具吗? 这是第一层的病。先做精选(少给工具)和压缩(日志外置、摘要留在窗口、能按 id 钻回原文),不需要长期记忆。[10][2]
- 用户每开一个新会话都要重新介绍自己和项目吗? 这是第二层。优先选写入路径透明的方案:能看到写进了什么,写错了能找到原始对话改回来。如果你在用 Mem0、MemOS 这类框架,换一个更好的写入模型可能比换存储收益更大。[8]
- 换个工具、换台机器、交给同事,上下文就断了吗? 这是第三层。选文件做真源、支持多 harness 的方案,先在单人场景跑顺,再考虑团队共享;团队共享之前,先把可见性和审核流程定下来。[5][3][1]
- 同样的排障步骤、发布检查,每次都要 agent 重新摸索吗? 这是第四层。把轨迹蒸成 Skill 可以,但一定要有人审核、有版本、能撤销,并且 Skill 不能覆盖安全规则。[9][1]
- 代码库太大,agent 每次都在 grep 和读整份文件上烧 token 吗? 这是检索问题,先上索引;如果代码是模型熟悉的流行公开库,先小范围测一下,收益可能不大。[6][7]
- 以上任何一层,只要会自动写入,就先回答三件事: 谁能写,写之前清洗什么,怎么回滚。答不上来,就先别开自动写入。
如果要在一个 coding agent 项目里试,我会这样排两周:
- 第一周只动第一层。挑一个经常跑到后半段就跑偏的长任务,记下基线:成功与否、总 token、中途重复了几次同样的动作。然后只做两件事,把工具清单砍到这个任务真正需要的几个,把大块工具输出外置到文件、窗口里只留摘要和路径,再跑同一组任务对比。
- 第二周再加一层,只加一层。用户反复重新介绍项目,就加第二层;多人或多工具之间交接断档,就加第三层。打开之前先把「谁能写、写前清洗什么、怎么回滚」写进配置说明,并且每天抽查一次新写入的条目,看有没有把错误结论写成事实。
- 两周结束时只看三个数:同一组任务的成功率、token、以及新写入条目里需要人工改正的比例。第三个数降不下来,说明写入路径有问题,换存储解决不了。
最后说一个我自己的倾向。如果只能从一层开始,我会从第一层开始。它不需要新的服务,不碰用户隐私,修法都是「扔掉一部分」,失败代价最小;而且第一层做不好,往窗口里塞再多长期记忆也只会加重分心和冲突。站内那篇 扩张 Harness,而不是堆上下文 讲的也是这个方向:能力应该长在 harness 的结构里,而不是一直往上下文里加东西。
参考来源
- TencentCloud,TencentDB Agent Memory,默认分支 README(团队版 Memory Hub):https://github.com/TencentCloud/TencentDB-Agent-Memory ↩
- TencentCloud,TencentDB Agent Memory,main 分支 README(插件版:符号化短期记忆与分层长期记忆):https://github.com/TencentCloud/TencentDB-Agent-Memory/blob/main/README.md ↩
- volcengine,OpenViking README:https://github.com/volcengine/OpenViking ↩
- OpenViking 文档,Context layers:https://docs.openviking.ai/en/concepts/03-context-layers ↩
- akitaonrails,ai-memory README:https://github.com/akitaonrails/ai-memory ↩
- xerj-org,XERJ README:https://github.com/xerj-org/xerj ↩
- Graphify-Labs,graphify README:https://github.com/Graphify-Labs/graphify ↩
- 腾讯混元,Hy-Memory-30B-A3B 模型卡(Hugging Face):https://huggingface.co/tencent/Hy-Memory-30B-A3B ↩
- CopilotKit 文档,Skill delivery:https://docs.copilotkit.ai/intelligence/learned-skills ↩
- IBM Technology,《Context Engineering for AI Agents: 4 Failure Modes to Avoid》(YouTube):https://www.youtube.com/watch?v=BwXremQ-i6I ↩