Mercor 劳动指数:90% 的工时没有 AI 基准覆盖,饱和之后又该怎么测模型
10 月中旬,Mercor 发布了劳动指数(Mercor Labor Index)的第一部分:一张把 AI 基准逐条对到美国职业任务上的「基准地图」。核心结论只有一句,美国人约 90% 的工作时间花在现有基准几乎没测到的任务上。[1] 这条在 Hacker News 上到 10 月 18 日上午拿了约 599 分、543 条评论,排在最前面的评论讲的是「门童谬误」:用自动门换掉门童看起来稳赚,后来才发现门童还顺手做着一堆没人记账的事。[4]
我觉得这张地图值得认真读,原因不在 90% 有多精确,Mercor 自己也说这是暂定数字。它的价值在于把一件大家隐约知道的事拆成了可以逐条核对的清单:榜单分数回答的问题,和你团队要回答的问题,经常不是同一个。同一周 arXiv 上有一篇论文从另一头切进来:就算题目对口,前沿模型都快拿满分以后,分数也分不开谁强谁弱,这时能不能从「它们是怎么做对的」里读出差距。[5] 还有一篇提醒了第三件事,分数本身是某个程序从输出里读出来的,换个程序读,同一批输出的「提升」能差出十几个点。[6]
覆盖、饱和、评分程序,这三件事正好是团队做模型选型和内部评测时会依次撞上的三堵墙。下面先拆 Mercor 的方法和它的偏差,再讲饱和之后怎么测,最后给一个可以照着走的框架。
先说结论
- 公开基准对软件、金融、法律这类高工资、高 AI 暴露的岗位测得相对密,对中等收入的长尾知识工作和体力工作几乎是空白。你的活如果落在后一类,榜单排名基本不能直接拿来用。
- 覆盖的缺口靠重新加权补不回来。Mercor 试过按职业任务加权,分数只动了几个点,因为没被测到的任务压根没有题。
- 饱和的基准还有用。只看做对的作答记录、让裁判模型成对比较,预测误差比只看分数低约 5.3 倍;但模型一换代(比如推理模型出现),这套方法会系统性地低估新模型。
- 做内部评测前先问三件事:你的任务有没有题;有题的话候选模型还分不分得开;分数是哪个评分程序读出来的。
Mercor 劳动指数怎么算出 90%
Mercor 用的骨架是美国劳工部的 ONET 职业分类,923 个职业,每个职业挂一串任务描述,合计 18,797 条。[1] 以律师为例,ONET 给了 22 条任务,包括起草和审阅遗嘱、租约、合同等法律文件,就诉讼是否值得打给客户建议,根据判例分析案件的可能结果。
基准这一侧,他们挑了 29 个,标准有五条:至少 25 道公开题;题目要模型动手做事,而不是回答问题或者告诉用户怎么做;题目像企业里真会派的活,经济价值优先于学术难度;每个职业族限额,免得软件工程和研究类题目挤满清单;还没被前沿模型做饱和。[1][2] 清单里有 SWE-bench Verified、Terminal-Bench 2.1、OpenAI 的 GDPval、Sierra 的 tau2 和 tau3、ServiceNow 的 EnterpriseOps-Gym,也有 Harvey LAB、PhysicianBench、TeachArena 这类行业题,以及 Mercor 自家的 APEX 系列。[2]
题目和任务之间的对应由大模型来标。每道基准题连同整份 O*NET 30.0 任务目录一起发给 GPT 5.6 Luna,让它先列出所有说得通的任务路径,再挑一条首选。[3] 一条任务至少对上 5 道题才算「被覆盖」,最后用 Hatgis-Kessell 等人估算的各任务工时占比,把任务覆盖折算成工时覆盖。[1]
标注靠不靠谱,他们也查了。APEX 三个基准的 1,013 道题上,专家一共给了 1,763 次判断,首选标签被认可的占 76.7%;只要专家的答案出现在模型列出的候选里就算对的话,比例升到 85.4%。[3] 地图把所有候选都计入覆盖,专家却只审了首选,其余候选里有多少站得住,目前没人知道。这一点会让覆盖率偏高,方向和 90% 的结论相反,所以结论不会因此变弱。
算下来的结果是:923 个职业里只有 208 个至少有一条任务被覆盖,18,797 条任务里被覆盖的只有 924 条,22 个职业族里有 6 个连一个被覆盖的职业都没有。[1]
图:Mercor 基准地图的三层覆盖,以及部分职业族里被覆盖职业的比例(默认口径:一条任务至少对上 5 道题)。数据来自[1]。
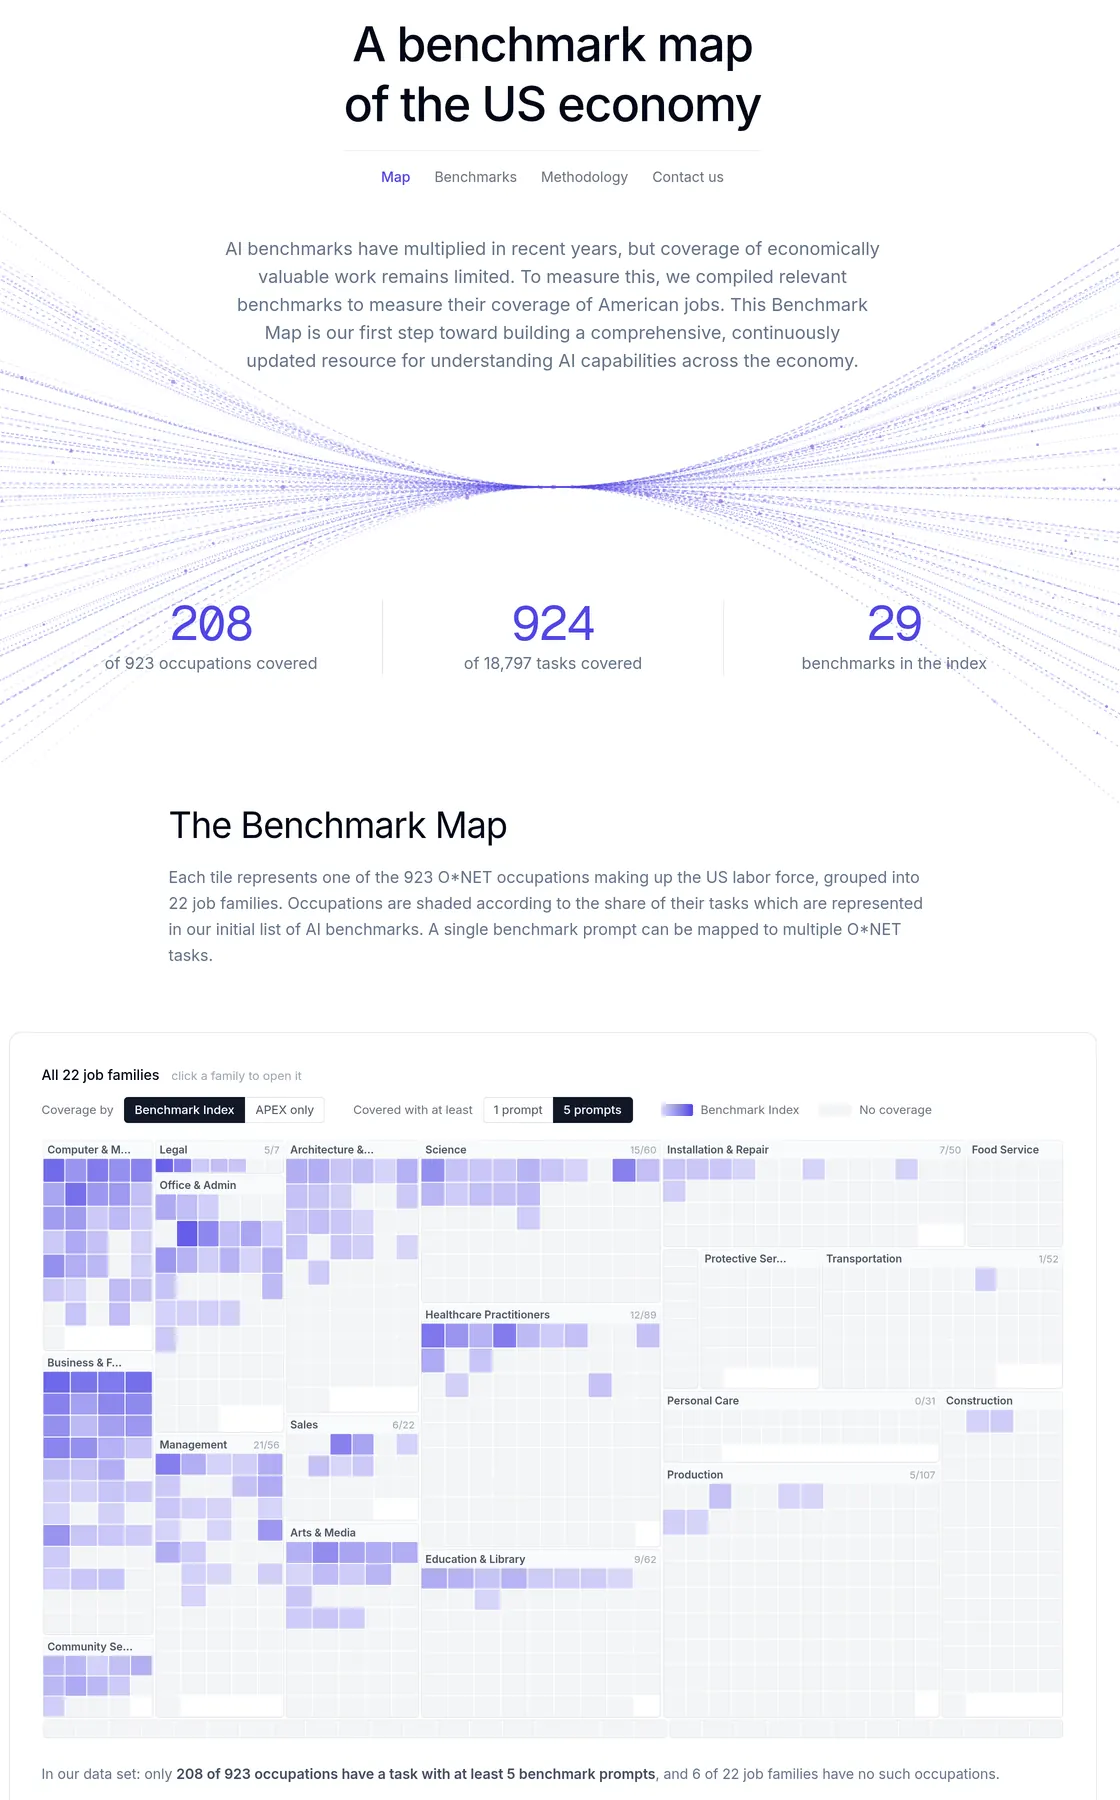
截图:Mercor Labor Index 的基准地图,每个格子是一个 ONET 职业,颜色越深被覆盖的任务越多(Mercor 原页面,2026-10 截取)[1]*
分布非常不均。计算机与数学 36 个职业里有 29 个被覆盖,法律 7 个里有 5 个;医疗从业者 89 个里只有 12 个,生产类 107 个里有 5 个,运输 52 个里有 1 个,个人护理 31 个职业一个都没有。[1]
覆盖跟着钱和 AI 暴露度走
Mercor 做了几组回归,结论指向同一个方向。第一,被 Eloundou 等人(2023)判为「AI 暴露」的任务,出现在基准里的概率约是未暴露任务的 6 倍。[1] 这在意料之中,做基准的人本来就想测 AI 最可能有进展的地方,所以题库里堆满了软件工程和财务分析,卡车驾驶和燃气厂运维几乎找不到。
第二,控制住暴露度以后,工资总额越大的职业,任务越容易被覆盖。工资总额是职业平均工资乘以从业人数,按每周 40 小时折成年值。从 Mercor 的图上看,高暴露任务里,工资总额最小一档的覆盖概率不到 5%,最大一档在 15% 上下。[1] 第三,在同一个职业内部,O*NET 专家打分最重要的那批任务,被覆盖的概率是最不重要那批的 6 到 10 倍。[1]
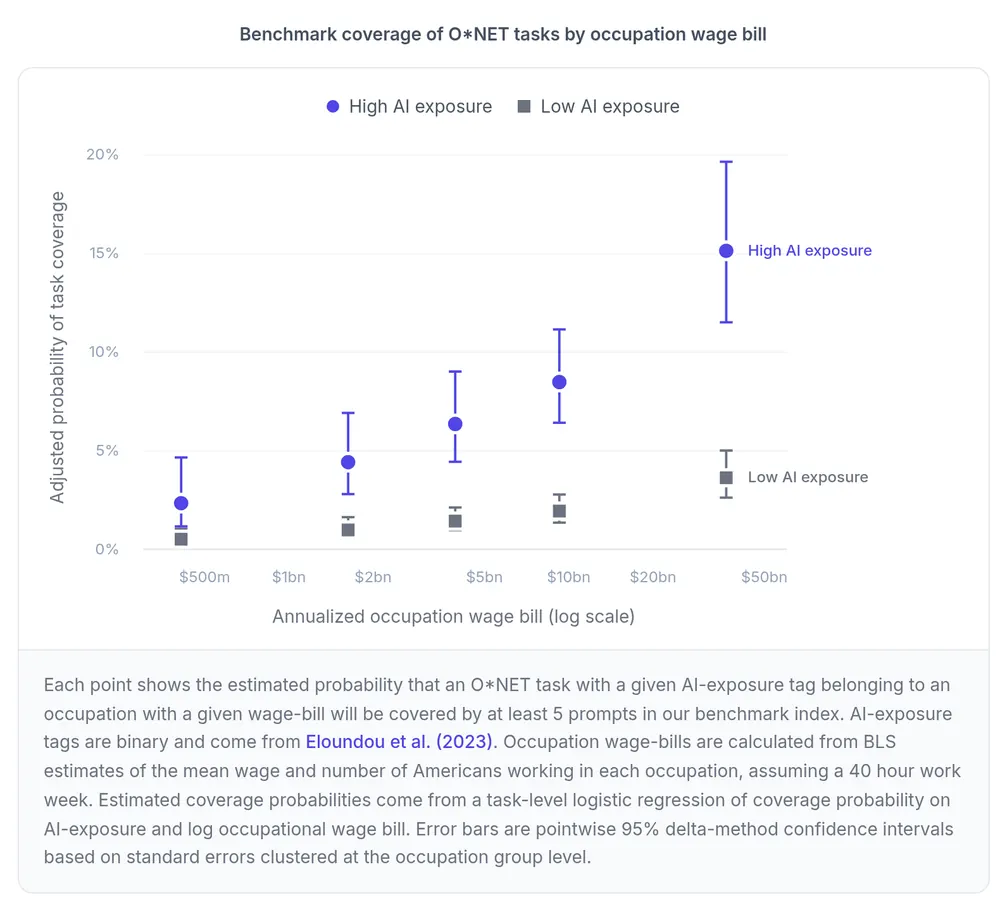
截图:工资总额越大的职业,任务越可能被至少 5 道题覆盖;高暴露组的上升最明显(Mercor 原页面,2026-10 截取)[1]
Mercor 举的例子很具体:律师那些高暴露任务被大量覆盖,而同样高暴露的法律秘书、法院书记员的任务几乎没人测。[1] 他们认为这种分配说得过去,资源有限,先测最重要、最暴露、工资盘子最大的岗位很自然。我同意这个判断,但后果要说清楚。如果你团队想交给 AI 的恰好是法律秘书那类活,比如整理卷宗、排期、录入,你在榜单上看到的「法律能力」分数,测的大概率是律师那一半。中等收入的长尾知识工作,恰好是企业最常拿来试 AI 的地方,也是基准最空的地方。
Mercor 自己列了几条偏差。只用 29 个基准,覆盖必然被低估,而且很难给这个偏差划上界;每族限额会压低软件工程这类热门职业族的覆盖;排除饱和基准可能低估简单任务的覆盖,可纳入饱和基准又可能高估覆盖,因为饱和本身常常说明题目不够真实。[1] 他们判断后一种偏差更大,所以选择排除。读的时候还要把一层背景放在心里:Mercor 的主业就是给 AI 公司提供专家数据和评测,APEX 也是他们自家的基准。[7] 这不说明结论有错,只说明「基准缺口很大」这个结论对他们的生意有利。
重新加权补不回没测到的活
既然基准对某些任务测得特别多,一个自然的想法是按 ONET 任务重新加权,让每条任务的权重相同,再算职业得分。Mercor 在 APEX 上对投行、法律、会计、软件工程四个职业试了这件事。[1] 以投行为例,对应 ONET 的「金融与投资分析师」,进入计算的有 11 条任务、176 道题:Claude Opus 5.5 Max 从每题等权的 73.3% 变成每任务等权的 70.2%,GPT-6 Astra Max 从 65.5% 变成 61.8%,Grok 4.7 xHigh 从 58.1% 变成 58.7%,DeepSeek V4.1 Flash Max 从 56.5% 变成 58.4%。[1] 变化都在几个点以内。
原因写在页面上:被纳入加权的那些任务,模型表现本来就差不多;而这四个职业相关的任务里,只有不到三分之一有足够的 APEX 题进入加权。[1] 加权只能在「有题的任务」之间挪权重,剩下三分之二没题的任务对分数毫无贡献。这是数据缺口,换统计方法修不了。
Mercor 还列了四个没解决的障碍,每一条都对应团队做内部评测时会踩的坑。
- 统计功效低。每个职业、每条任务能分到的题都很少,一两道质量差的题就能把分数带偏。
- 题目难度和保真度参差。有的题已经饱和,有的还没人解出;有的评分太粗、带小错,或者能被钻空子拿分,而且目前没有按质量加权的办法。[1] 站内写过的 CheatBench 里,每个被测 agent 至少在一类场景里作过弊,说的就是最后这种。
- 测自动化的题,未必能推到辅助。现实里模型主要是给人用的,很少端到端替掉整个岗位,可「模型让人快了多少」还没有能规模化的测法。HN 那条门童评论下面有人补了一个很实在的观察:他的团队几个小时能做完的活,AI 一两分钟就能做到中上水平,但评审、反馈和签字要来回好几天。[4] 基准测的正是那一两分钟。
- 体力任务基本测不了。Dingel 和 Neiman 估计美国只有 37% 的工作能完全在家做,也就是约 63% 的工作带有体力环节。[1]
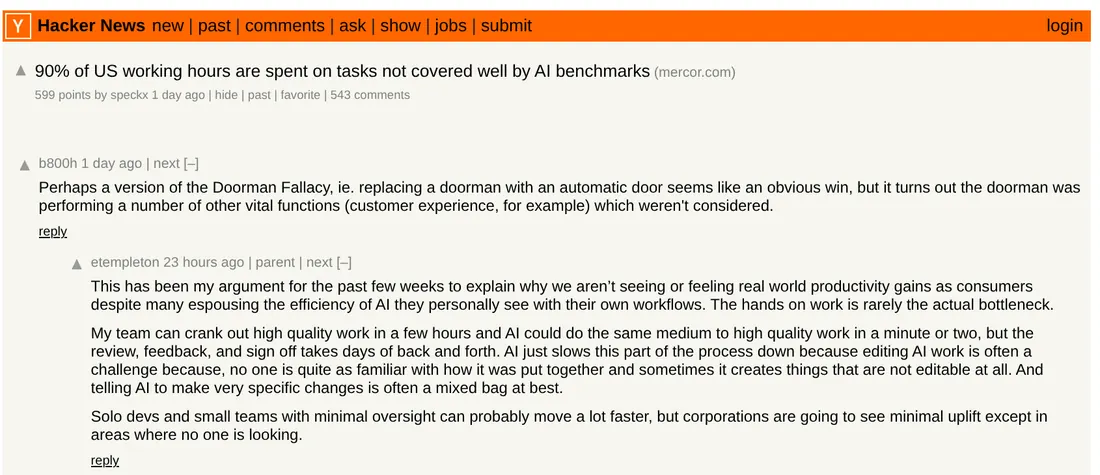
截图:HN 讨论帖,前两条评论讨论门童谬误和「动手不是瓶颈,评审才是」(Hacker News 原帖,2026-10 截取)[4]
第二堵墙:题目对口了,分数也会分不开
假设你找到了一套对口的基准,接下来要面对饱和。arXiv 2610.20667 引用的一项研究发现,60 个常用 LLM 基准里接近一半已经出现饱和迹象。[5] 几个前沿模型都接近满分以后,基准就区分不了它们。常规做法是造更难的新题,可造题和验题的速度追不上模型。
LASR Labs、UK AISI 等机构的 Morio Hamada、Jehyeok Yeon 等人在这篇论文里问了一个更省钱的问题:模型在饱和题上虽然都做对了,但做对的过程各不相同,能不能从完整作答记录(transcript)里读出能力差别?[5]
实验设计值得细讲,因为它决定了结论能信几分。他们把模型按半年分期,上一期的 7 到 8 个模型当参考,下一期的 8 个模型当预测对象,主实验的目标期是 2025 年下半年和 2026 年上半年,共 16 个目标模型。[5] 参考集里能力最强的三个模型都做对的题划进饱和集,其余的进未饱和集。真值是在未饱和集上用项目反应理论(IRT,一种同时估计题目难度和答题者能力的统计模型)算出的能力 θ*。预测时,协议只能看到饱和集上的作答记录,而且只给做对的那些,等于把正确率这条信号人为拿掉了。[5] 实验覆盖四个领域:科学(GPQA-Diamond 等)、数学(AIME 等)、编程(SWE-bench、Terminal-Bench 2.1 等)和网络安全(CyBench、InterCode)。
他们比了四种读法:从记录里算长度、回溯词频率这类固定特征再回归;用 Qwen3-Embedding-8B 转成向量再回归;让裁判模型给单条记录打 1 到 10 分;以及成对评判,把同一道题上两个模型都做对的记录放在一起,问裁判哪条出自更强的模型。[5] 基线最朴素,把所有目标模型都预测成参考模型的平均能力,这正是「只看饱和分数」时能拿到的全部信息。
图:论文的预测流程与主结果。协议只看到饱和题上做对的作答记录,真值来自藏起来的难题。数据来自[5]。
结果相当清楚。基线误差 1.37,固定特征 0.86,向量 1.01,单条打分 1.01,成对评判 0.26,约低 5.3 倍;四种读法里只有成对评判在统计上稳定地胜过基线。[5] 分领域看,成对评判在编程上的误差是 0.14(基线 2.14),网络安全是 0.26(基线 1.39),这两个 agent 类领域的优势都显著;在科学和数学上它的误差也最低,但相对基线的优势没过显著性。[5]
信号藏在哪里,论文也拆了。把记录切成三段,去掉任意一段,数学和编程的预测基本不受影响,说明能力信息分散在全程;网络安全是例外,信号集中在最后三分之一。按通道拆,去掉推理过程以后,编程的误差从 0.18 涨到 0.62,网络安全从 0.20 涨到 0.75,科学从 0.27 涨到 0.94;去掉工具调用,网络安全从 0.20 涨到 0.79,编程几乎不变(0.18 到 0.17);去掉模型对外的回复消息,哪个领域都没有显著变化。[5] 这对用闭源模型的团队很关键,因为闭源模型通常不给推理过程。论文在编程领域单独测了 6 个闭源目标模型,包括 Claude Opus 4.7、GPT-5.6 Sol 和 Gemini 3.5 Flash,在所有模型都隐藏推理的条件下,成对评判在 6 个上全部胜过基线。[5]
这个方法在哪里会坏
论文把失败情况写得很坦白,我认为这一部分比 5.3 倍更值得团队记住。
第一,换代时会系统性低估。2025 年初第一批推理模型出现,用 2024 年下半年的参考模型和裁判去评,3 个非推理目标的误差是 0.24,5 个推理目标是 6.20,裁判把推理模型的能力低估了 2.1 到 3.0 个 θ 单位。把推理 token 删掉,误差也只降到 3.37。[5] 新一代模型做题的方式变了,旧裁判看不出好在哪里。
第二,参考模型要新,也要强。把目标固定在 2026 年上半年,参考期往回推,科学领域的误差从 0.25(2025 年下半年参考)涨到 0.47(2025 年上半年),再到 10.39(2023 年参考);往回推两期的成对评判,比往回推一期的基线还差。[5] 去掉强参考模型,也比去掉弱参考模型伤得多。
第三,裁判看的是像不像强模型,不是对不对。附录里有一道 GPQA 题,裁判两次都判 glm-5.2 更强,理由是它写出了明确的推导,可那段推导里有个错(说本征值的平方和是 1,实际是 2),裁判没发现。[5] 成对偏好依据的是有没有写推导,而不是推导对不对。放到你自己的业务上,这种偏好很容易去奖励写得长、格式整齐的回答。
第四,数学和科学不稳。回测的 10 个期次里,成对评判在这两个领域有 4 次没能胜过基线。[5] 多加题也不一定有用,有些设置里裁判的系统性偏差会随着判断次数累积,而不是被平均掉。
第五,成本差几个数量级。按 2026 年 9 月 OpenRouter 的价格,固定特征不花钱,向量每期几美分,单条打分 2 到 7 美元,成对评判 55 到 105 美元,因为每道题要在每一对目标和参考之间各判一次。[5] 好在只用十分之一的题,约 6 美元一期,在 agent 类领域就已经胜过基线。对企业来说这点钱不算什么,难的是凑齐一批「在你业务上能力已知」的参考模型。
第三个变量:分数是哪个程序读出来的
同一周还有一篇值得放进来:Monash 大学 Zongye Lyu 的 arXiv 2610.20639。[6] 它问的是,用可验证奖励做强化学习(RLVR)以后,模型在训练域之外的选择题上涨了分,这个涨分有多少是真的。
做法很干净。不重训任何模型,只把基座模型和 RL 模型的同一批输出,分别交给从公开代码里抄来的答案抽取器和一个对两边一视同仁的抽取器各读一遍。在 4 对 7B 的 SimpleRL 模型上,MMLU、MMLU-Pro、ARC-Challenge 这三个域外选择题基准里,公开抽取器报告的涨分有 82% 在公平抽取器下消失了。[6] 原因是基座模型大多把答案写在正文里,比如「The correct answer is B」,RL 模型则学会了把答案放进 \boxed{},而那几个抽取器先看 \boxed{}。在公平抽取器能读出答案的输出里,基座模型只有 26.6% 带 \boxed{},RL 模型是 58.3%。[6] 一个例子最直观:Qwen2.5-7B 和它的 SimpleRL-Zoo 版本在 500 道 ARC 题上,只读 \boxed{} 的抽取器报告涨了 30.6 个点,公平抽取器读出的是 9.8 个点。[6] 对同一批输出,不同公开抽取器报告的涨分,最大和最小之间的中位数差距是 15 个点。[6]
边界也要讲清楚。在一对 32B 的 DAPO 模型上,格式带来的涨分只占约 2.1%,几乎全是真涨分。[6] 所以 82% 是 7B、这一类训练配方下的数字,不是所有 RL 模型的规律。
这篇和 2610.20667 指向同一个方向:分数是一条被压缩过的信号,压缩它的程序本身也是变量。作者给了三条做法,团队可以直接照抄:每个数字写明用的是哪个抽取器;报告抽取器在基座模型输出上能读出答案的比例;用第二个抽取器重读同一批输出。[6]
和站内几篇放在一起看
站内的 Agent 评测可靠性 讲同一张榜能可靠支持哪些结论:模型加 scaffold 的系统排序可靠度在 0.935 到 0.994,单比底层模型只有 0.148 到 0.841;同类任务堆得再多帮助有限,多样基准池化才更有用。Mercor 的地图可以看成那篇的外部版:池化得再多,池子里没有你的任务,照样测不到。CheatBench 说明评分通道本身能被钻空子,对应 Mercor 列的第二个障碍。评测环境即生产环境 那篇里,Anthropic 的问题是回头审查评测作答记录才发现的,分数上什么也看不出来。这几篇和两篇新论文的结论一致:只留分数、丢掉作答记录的评测,丢掉的信息最多。
决策框架:团队选模型和做内部评测
把上面三堵墙变成问题,按顺序问下去。
图:团队选模型前的三个问题。第一问对应 Mercor 的覆盖缺口[1],第二问对应饱和后的作答记录评判[5],第三问对应评分程序带来的涨分[6]。
落到具体步骤上:
- 列任务清单。把团队一周的活按 O*NET 那种粒度写下来,写「审阅合同条款并标出风险」,不写「法律工作」,每条估一个工时占比。
- 逐条对照公开基准。Mercor 的地图和那 29 个基准的清单可以直接拿来查你所在职业的覆盖。[1][2] 一条任务如果找不到几道对口的题,就别让榜单分数代表它。
- 补自己的题。从真实工单、历史 PR、客服记录里抽题,每条任务至少凑够几道。Mercor 的门槛是 5 道,我觉得这只是下限。总分按第 1 步的工时占比加权,不要按题数平均。
- 判断饱和。候选模型在你的题上都接近满分时,就别再用正确率排序了。
- 留下全部作答记录,包括拿得到的推理、工具调用和最终输出。agent 类任务尤其不能丢工具调用这一路。
- 用成对评判拉开差距,同时做校准。挑几个你已经清楚它在你业务上表现如何的模型当参考,用它们之间的比较校准裁判,再把新模型放进来比。参考模型要选最新、最强的那批。
- 换代时先别信裁判。新模型换了做题方式(例如从非推理变成推理),先造一批新难题直接测,再决定旧裁判还能不能用。
- 抽查裁判给的理由,看它是不是在奖励写得多、格式整齐,而不是做得对。
- 写明评分程序。每个数字附上评分器、抽取器和提示词版本;用另一个评分器重读同一批输出,差距超过几个点,先查评分器再比模型。
- 单独测辅助效果。对人机协作的岗位,测人用了模型以后完成同一批任务的时间和返工次数,这一块公开基准几乎没有。
结论
Mercor 这张地图最有用的地方,是让「榜单测的不是我的活」从一句抱怨变成了可以逐条核对的任务清单。90% 这个数字会随着他们加基准往下走,但覆盖向高工资、高暴露岗位倾斜的结构,短期内不会变。公开分数可以当筛子,排除明显不行的模型,不该当选型的最后依据。真正该拍板的,是在你自己任务清单上、按工时加权、留着作答记录、写明评分程序的那套内部评测。基准饱和本身不可怕,可怕的是题测完以后只剩下一个分数。
参考来源
- Mercor,《A benchmark map of the US economy》(Mercor Labor Index · Benchmark Map):https://www.mercor.com/research/labor-index/benchmark-map/ ↩
- Mercor,Benchmark Map · Benchmarks(29 个基准的清单与入选标准):https://www.mercor.com/research/labor-index/benchmark-map/benchmarks/ ↩
- Mercor,Benchmark Map · Methodology(LLM 标注与专家复核):https://www.mercor.com/research/labor-index/benchmark-map/methodology/ ↩
- Hacker News,《90% of US working hours are spent on tasks not covered well by AI benchmarks》(讨论帖):https://news.ycombinator.com/item?id=50121179 ↩
- Morio Hamada、Jehyeok Yeon、Matteo Migliarini、Justin Olive、Magda Dubois,《Evaluating Model Capabilities After Benchmark Saturation》,arXiv:2610.20667:https://arxiv.org/abs/2610.20667 ↩
- Zongye Lyu,《Same Answer, New Box: How Much of RLVR’s Out-of-Domain Gain Is Answer Format?》,arXiv:2610.20639:https://arxiv.org/abs/2610.20639 ↩
- RuntimeWire,Ryan Merket,《Mercor estimates 90% of US work hours lack AI benchmark coverage》:https://runtimewire.com/article/mercor-benchmark-map-human-work-thesis ↩