OpenCode 2.3.2 实测:GPT-6.2 不缓存 instructions,system prompt 改放开头的 developer 消息
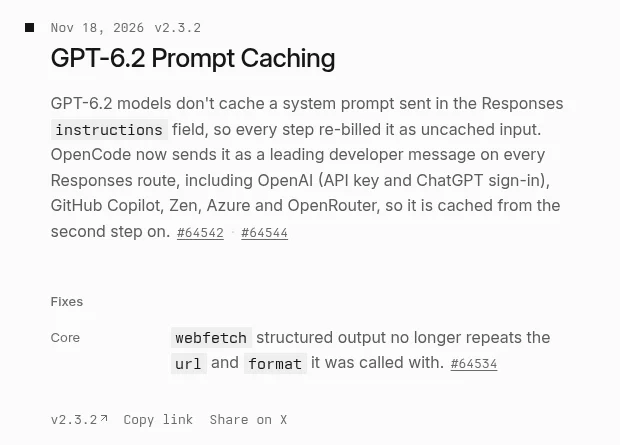
结论先说: 从 GPT-6.2 开始,Responses API 会把请求顶层的 instructions 放到 input 后面,落在缓存断点之外。哪怕每次内容一字不差,这部分也按未缓存的价格算。[4][5] OpenCode 的 system prompt 一直放在 instructions 里,所以用 GPT-6.2 时每一步都要把一万多 token 的 system prompt 重新付一遍全价。2.3.2(北京时间 11 月 18 日 09:35 发布)把它挪成了 input 里的第一条 developer 消息,从第二步起就能命中缓存。GitHub Copilot 的 gpt-6.2-sol 上,每步未缓存输入从 14,163 token 降到 3。[1][3]
| 你现在的情况 | 该做什么 |
|---|---|
| 在 OpenCode 里用 GPT-6.2(API key、ChatGPT 登录、Copilot、Zen、Azure、OpenRouter) | 升到 2.3.2:opencode upgrade,或 npm i -g @opencode/cli@latest,或 curl -fsSL https://opencode.ai/v2/install | bash。不用改配置。 |
自建路由,配置里还是 V1 的 provider 块加 "npm": "@ai-sdk/openai-compatible" | 这条路走 AI SDK,不在这次修复范围内。改成 V2 的 providers 块,package 写 @opencode/ai/providers/openai-compatible/responses。[10] |
| 中间隔着 LiteLLM 这类网关,网关再转成 Responses 请求 | 网关自己也要修。LiteLLM 已在 v1.108.13、v1.110.2 等版本修复,用 Claude Code 经 LiteLLM 调 GPT-6.2 的也在受影响之列。[8] |
| 自己写代码调 Responses API | 固定的 system prompt 放进 input 开头的 developer 消息。instructions 只留给本轮临时的指示,比如「最后一轮请总结」。 |
| 用 GPT-6.1 及更早的模型 | 两种写法都能缓存,升级不影响结果。[2] |
前缀缓存只认一模一样的开头
模型处理一段输入时,会为每个 token 算出一组中间结果(KV cache)。下一次请求如果开头完全相同,服务端就可以直接复用这些结果,只算后面新增的部分。复用的那部分按缓存价计费,GPT-6.2 Sol 和 Astra 的缓存读取价是普通输入的 0.05 倍,写入是 1.25 倍(30 分钟有效)或 2.5 倍(12 小时)。[4] 所以一个 agent 每一步发出的请求,开头越长越稳定,账单越便宜。
「开头相同」是按渲染后的 token 序列逐个比的,不是比语义。中间改一个字符,从那里往后全部作废。OpenAI 的做法是在请求里找几个「查找边界」,从最长的往短里试,看哪个前缀已经在缓存里。GPT-5.6 之后的隐式模式下,这些边界包括:最新一条符合条件的消息末尾,往前最多 20 条消息的末尾,以及开头那一串连续 developer 消息的结尾。[4] 最后一条很关键:只要 system prompt 是开头的 developer 消息,哪怕后面的对话全变了,这一段也能单独命中。
instructions 在 GPT-6.2 上的位置恰好相反。文档的说法是,GPT-6.2 起的模型把它追加在 input 之后,这样你在每一轮改它也不会破坏前面的缓存。代价是它永远在断点之外,每次都按未缓存价算,也不能在里面加显式断点。[4][5] 这个设计本身说得通:instructions 本来就该放「只对这一次请求有效」的话。问题在于大多数客户端一直把整段 system prompt 塞在这里,GPT-6.1 及以前它和 developer 消息缓存效果一样,没人觉得需要区分。
这个变化不报错,请求照常成功,只是账单变厚。LiteLLM 的复盘写得很直白:11 月 17 日 OpenAI 更新了文档,他们的告警一个都没响,直到 18 日有客户来问缓存为什么没命中。[8] 还有一处容易误导人:OpenAI 的缓存诊断(prompt_cache_options.comparison_response_id)在 instructions 的请求上报告 cache_hit,而 usage 里的 cached_tokens 和 cache_write_tokens 都是 0。[2][9] 查账以 usage 为准。
2.3.1 和 2.3.2 发出去的请求差在哪
把 OpenCode 指向本地 mock 服务,模型选 openai/gpt-6.2-sol,两轮对话、每轮调一次工具,抓到的请求如下。
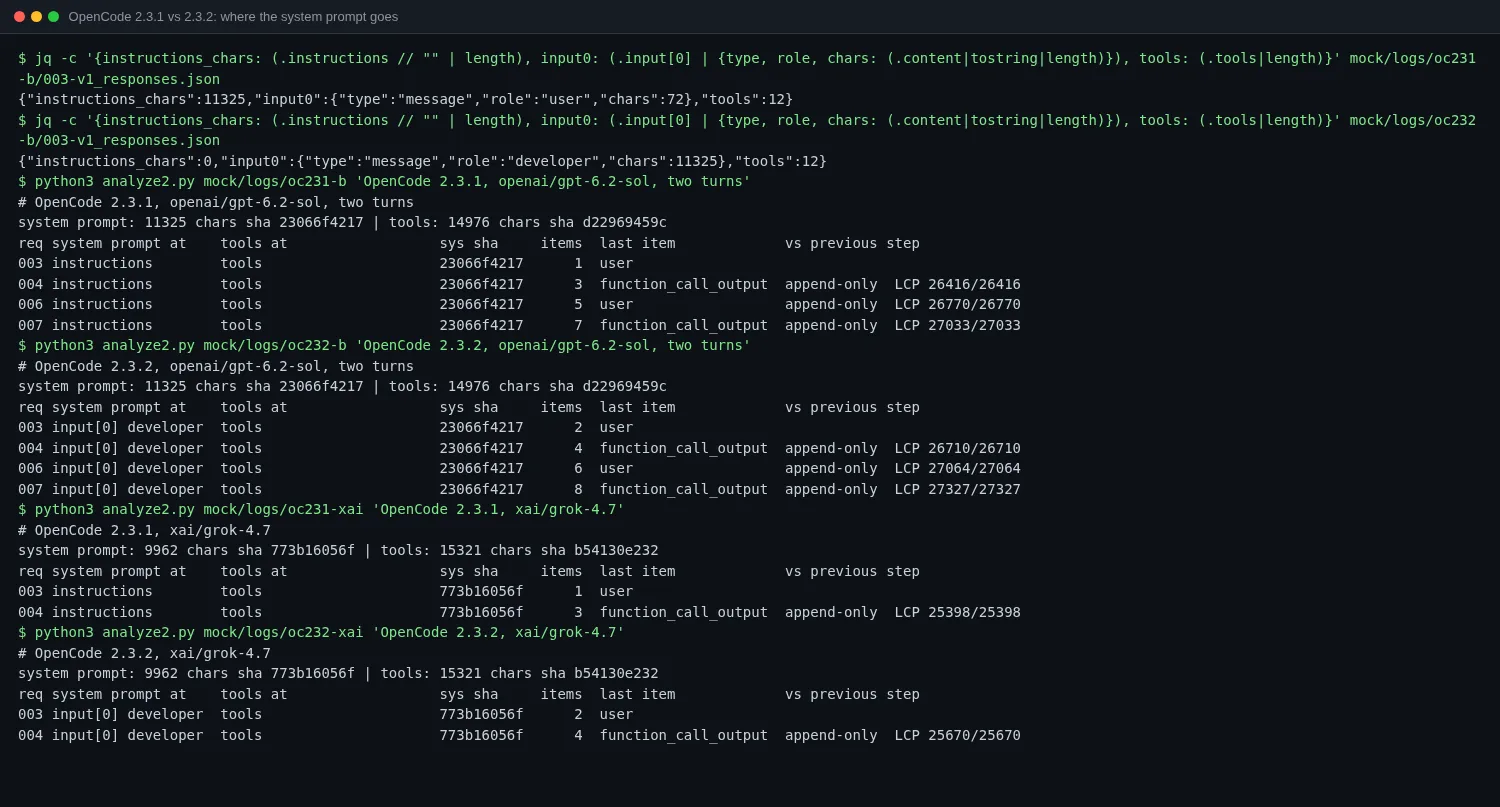
2.3.1 的请求里,instructions 是 11,325 个字符的 system prompt,input[0] 就是用户消息。2.3.2 的请求没有 instructions,input[0] 是一条 developer 消息,内容是同样的 11,325 个字符,哈希也一样。12 个工具声明(14,976 字符)两个版本完全相同,仍然放在顶层 tools。每一步的请求都是上一步原样加上新内容,把 tools、system prompt、input 依次拼起来比,上一步的全文都是下一步的开头,两个版本都是这样。
也就是说,2.3.2 只动了一件事:system prompt 换了位置,文本一个字节都没变。在 GPT-6.1 上这两种请求的缓存效果相同。在 GPT-6.2 上,前者每步都要为这 11k 字符付全价。
同样的对比在 xai/grok-4.7 和一个自定义路由(V2 providers 块,package 用 @opencode/ai/providers/openai-compatible/responses)上也做了,结果一致:2.3.1 用 instructions,2.3.2 用开头的 developer 消息。这对应两个 PR 的分工。#64542 先改了 OpenAI 自家的 Responses 路由,#64544 把改动下沉到所有 Responses 路由共用的 OpenResponses.lowerConversation,Copilot、xAI、OpenRouter、Vercel AI Gateway 和自定义的 OpenAI 兼容服务都跟着变。[2][3]
真实账单 mock 测不出来,只能看 PR 里作者的实测。ChatGPT 登录、gpt-6.2-sol、一个会话里三句短提示,每步未缓存输入从 16,969、16,992、14,457 变成 16,969、352、121。[2] 用 API key 直接发请求,instructions 写法四步的缓存命中都是 0,换成 developer 消息后从第二步开始命中 9,632、9,660、9,691 token。[2]
有两种配置不会因为升级而受益。一种是 V1 的 provider 块配 "npm": "@ai-sdk/openai-compatible",这条路走 /chat/completions,system prompt 是 messages[0],本来就不涉及 instructions。另一种是 V1 块里写了 package 但同时留着 npm:V2 只从 npm 取运行时,package 被忽略。#64783 里的用户就是这样,升到 2.3.2 后每轮仍有 1 万到 2 万 token 未缓存,改成 V2 写法后降到 6k 左右。[10]
{
  "providers": {
    "myrouter": {
      "package": "@opencode/ai/providers/openai-compatible/responses",
      "settings": { "baseURL": "https://router.example.com/v1", "apiKey": "{env:ROUTER_KEY}" },
      "models": { "gpt-sol": { "limit": { "context": 1050000, "output": 128000 }, "body": { "store": false } } }
    }
  }
}
压缩之后,前缀还剩多少
缓存最怕的就是压缩。OpenAI 文档也直说,摘要、压缩或截断都会改变前缀,让缓存复用归零。[4] 能做的是让压缩只动历史,不动前面的 system prompt 和工具。
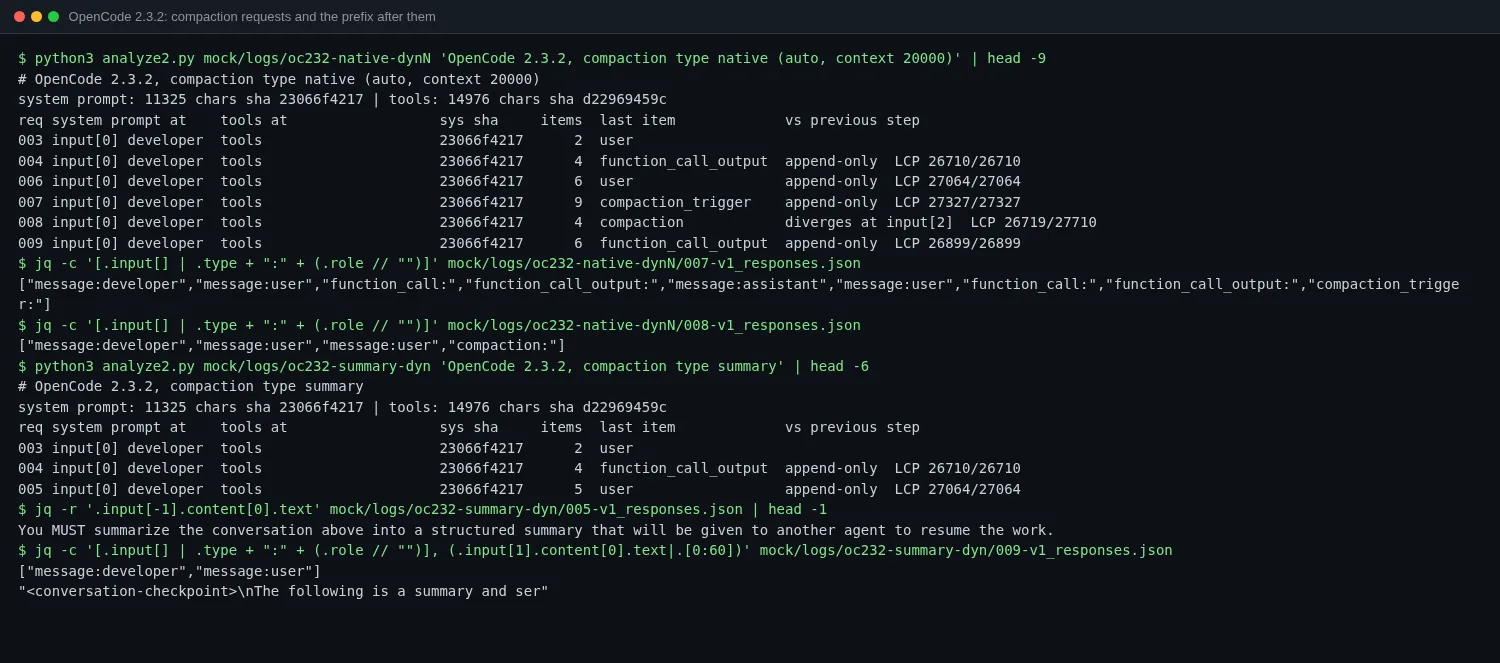
把 2.3.2 的上下文窗口设成 20,000,让 mock 报告的 token 数逐步变大,自动压缩就会触发。compaction.type 设成 native 时,OpenCode 不另开请求,而是在正常的 /responses 请求末尾追加一个 compaction_trigger,前面的内容原样保留,这一步仍是上一步的延续。压缩之后的下一次请求变成 [developer, 第一条 user, user, compaction]:system prompt、工具和第一条用户消息都在,从 input[2] 开始才不同。TUI 里手动输入 /compact 走的也是这条路。
设成 summary 时,写摘要的请求同样是完整前缀加一条「You MUST summarize the conversation above…」的用户消息,能吃到前面的缓存。压缩后剩下 [developer, user "<conversation-checkpoint>…"],system prompt 和工具不变。2.3.1 两种模式的形状相同,只是 system prompt 还在 instructions 里。
release notes 说 /responses/compact 现在也读同一份缓存前缀。[1] #64544 的数据是:带 instructions 的压缩请求在 gpt-6.2-sol 上读到 0 个缓存 token,换成 developer 消息后读到 3,190 个里的 2,962 个。[3] 本地几次压缩都没走到这个端点,这一点没能亲眼看到。
其他几家怎么排前缀
同样的 mock 也接了 Codex CLI 0.171.0、Claude Code 2.1.330、Gemini CLI 0.70.0 和 Qwen Code 0.28.3。它们的 system prompt 都不在 instructions 里,但排法各不相同。
| 协议 | system prompt 放在哪 | 工具声明放在哪 | 缓存标记 | 压缩后前缀 | |
|---|---|---|---|---|---|
| OpenCode 2.3.2 | Responses | input[0] developer(11,325 字符) | 顶层 tools(12 个) | 无,靠隐式边界 | system 和工具不变,历史重写 |
| Codex 0.171.0 | Responses | input[1..4] 四条 developer | input[0] 的 additional_tools | 无 | 内容相同,条目 id 全部换新 |
| Claude Code 2.1.330 | Messages | 顶层 system 三块 | 顶层 tools(12 个) | system[1]、system[2]、最后一条消息 | system[0] 计费头变了,其余不变 |
| Gemini CLI 0.70.0 | generateContent | 顶层 systemInstruction(30,747 字符) | 顶层 tools | 无,不用 cachedContent | 没有测 |
| Qwen Code 0.28.3 | Chat Completions | messages[0] system(22,432 字符) | 顶层 tools(10 个) | 无 | 没有测 |
Codex 从来不发 instructions,顶层也没有 tools。它开了 incremental_tools,工具声明放进 input[0] 的一个 additional_tools 条目里,分 functions、clock、collaboration 三组,共 26,071 字符。后面是四条 developer 消息(第一条 26,194 字符),再是一条装环境信息的 user 消息,最后才是用户的话。这正好就是 #64542 说的「工具在开头的 additional_tools 里时,system prompt 紧跟其后」的排法。[2] 每一步和 codex exec resume 都是原样追加。0.170.0 给 GCP、0.171.0 给 Bedrock 默认打开了增量工具声明,0.171.0 还让压缩保留当前生效的附加上下文。[11][12]
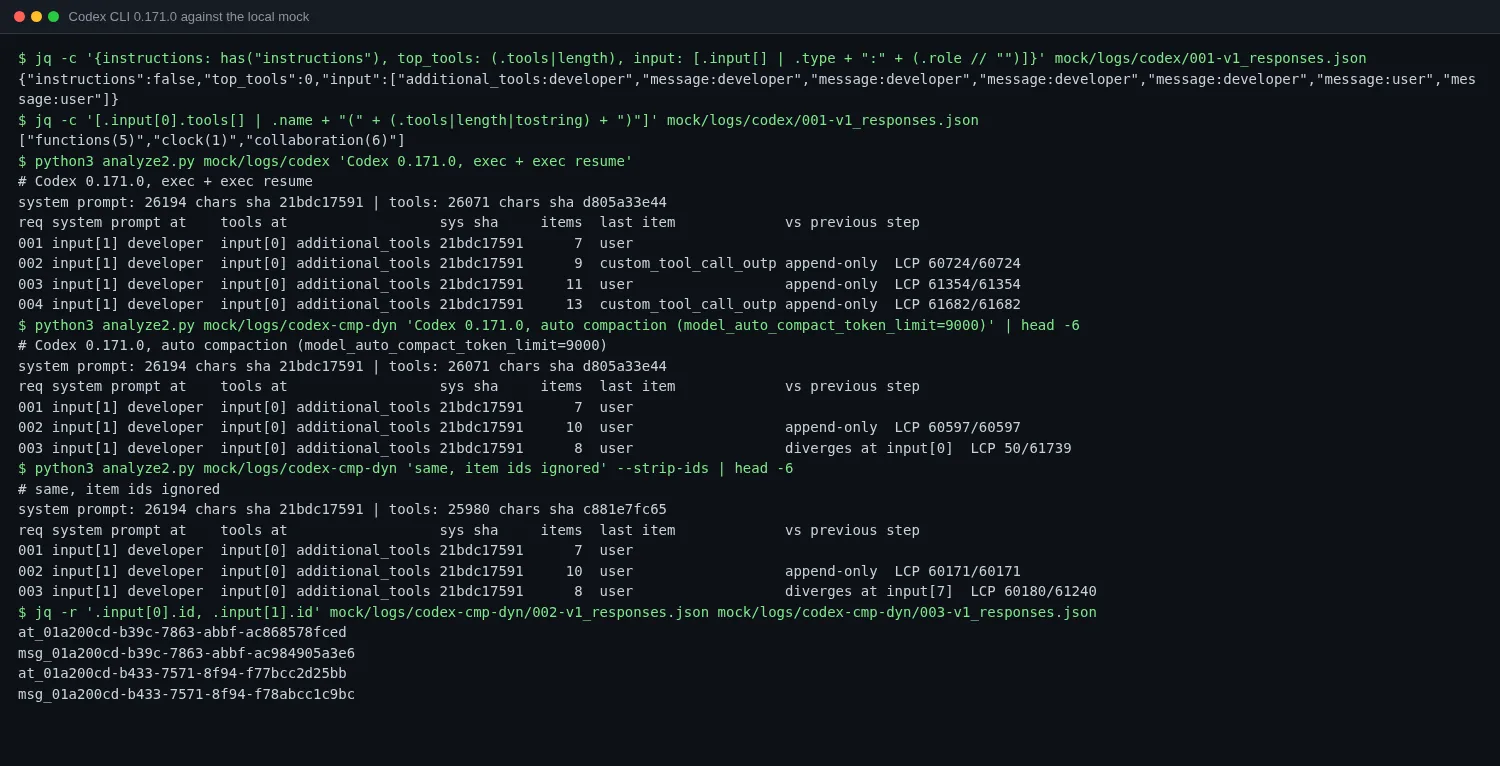
把 model_auto_compact_token_limit 设成 9,000 触发自动压缩后,Codex 重建了初始上下文:工具和 developer 消息的文本一字不差,但每个条目的 id(at_…、msg_…)都是新生成的。忽略 id 比,前 7 个条目完全一样。条目 id 会不会进入模型看到的 token 序列,本地判断不了。如果不进,压缩后的前缀就能接着用。另外,OpenAI 文档写明 additional_tools 条目不接受 prompt_cache_breakpoint,想给工具加显式断点只能加在它后面的 developer 消息上。[4]
Claude Code 走 Anthropic Messages。Anthropic 的缓存前缀顺序固定为 tools、system、messages,最多 4 个断点,断点往前回看 20 个块。[6] Claude Code 的 system 有三块:第一块 74 字符的 x-anthropic-billing-header: cc_version=2.1.330.581; cc_entrypoint=sdk-cli;,第二块 62 字符的身份声明,第三块 7,077 字符的正文。cache_control 打在第二、第三块和最后一条消息上,工具本身不打。环境信息不在 system 里,而是在第一条用户消息后面插了一条 role 为 system 的消息(9.4k 字符),请求头里带着 mid-conversation-tool-changes 之类的 beta 标记。工作目录、平台这类随环境变化的内容因此碰不到前面的 system prompt。
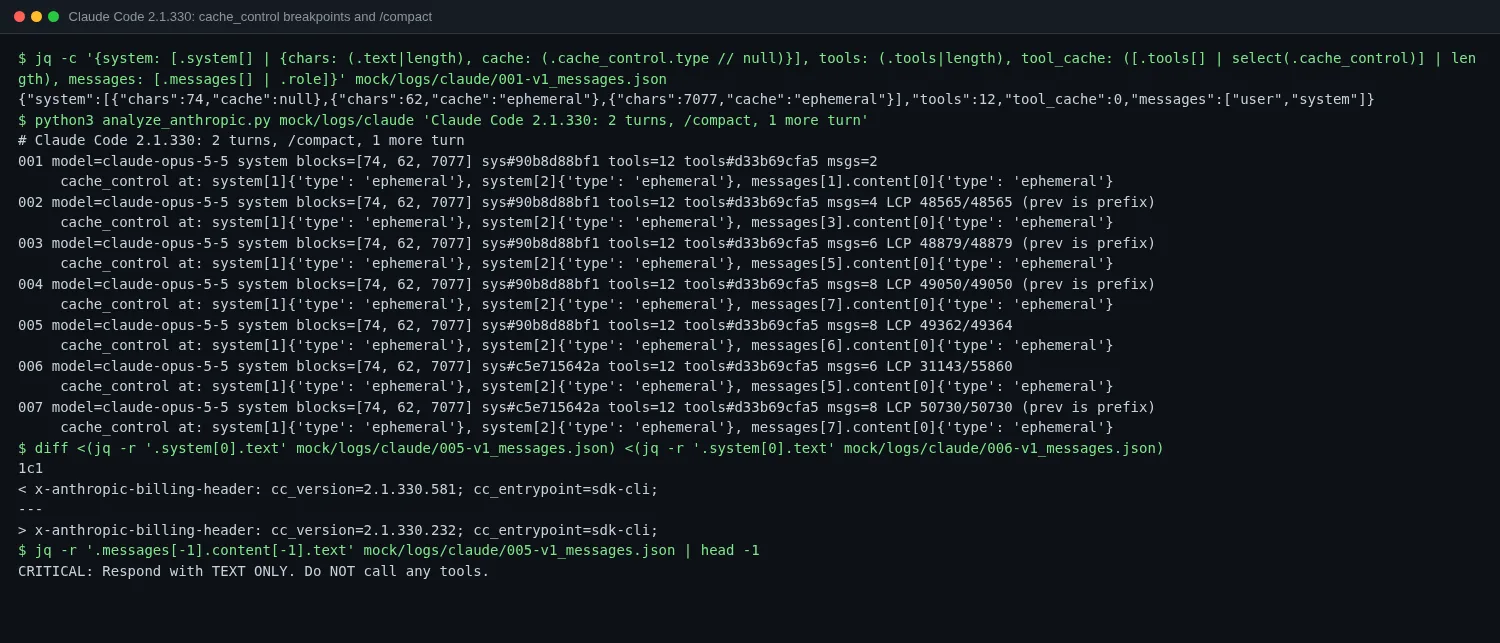
手动 /compact 时,写摘要的请求在最后一条用户消息上追加「CRITICAL: Respond with TEXT ONLY…」,前缀完整保留。压缩后工具和 system 正文都没变,唯一变的是第一块计费头里的数字,从 .581 变成 .232,两次独立会话都是这两个值。自动压缩的情况相同:2.1.328 修了自动压缩沿用旧 system prompt 的问题,现在它和 /compact 一样重建 system prompt。[13] 这块计费头排在 system 的最前面,它是否算进缓存比较的前缀,只有用真实账号才能看出来。
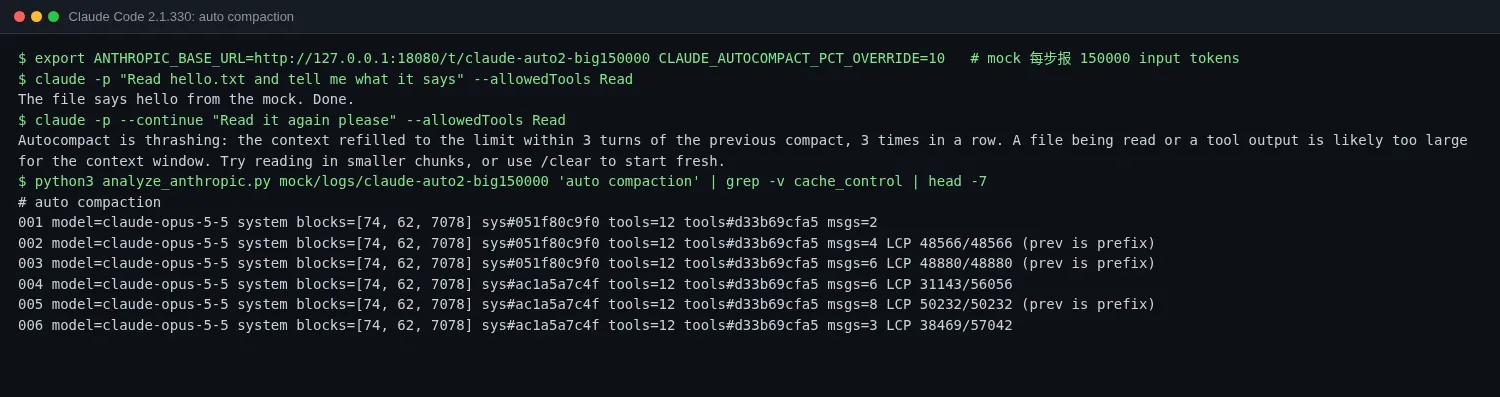
测自动压缩时还撞见一条提示。让 mock 每步都报 150,000 输入 token、把 CLAUDE_AUTOCOMPACT_PCT_OVERRIDE 设成 10 之后,Claude Code 连续压缩几次就停下来,报「Autocompact is thrashing: the context refilled to the limit within 3 turns of the previous compact, 3 times in a row」。真实场景里遇到这句,多半是某个文件或工具输出太大。
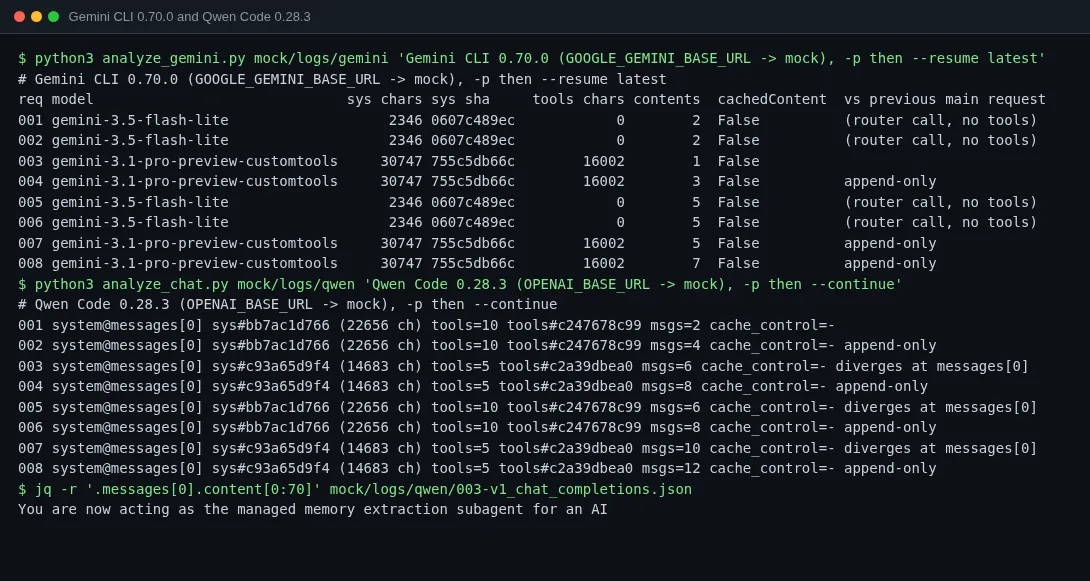
Gemini CLI 把 30,747 字符的 systemInstruction 和 16,002 字符的工具声明放在顶层,每一步、包括 --resume latest 之后都不变,contents 原样追加,不用显式的 cachedContent,靠 Gemini 2.5 起默认开启的隐式缓存。Google 的文档建议把大段公共内容放在开头,它正是这样做的。[7] 另外每一轮开始前,它会先用 gemini-3.5-flash-lite 跑两次路由判断,system prompt 只有 2,346 字符,没有工具,是另一份独立的前缀。
Qwen Code 走 Chat Completions,system prompt 是 messages[0](22,432 字符),10 个工具在顶层,没有任何 cache_control,能不能缓存完全看后端。主循环在 --continue 之后也是原样追加。不过每轮结束后,它会跑一个「managed memory extraction」子 agent,system prompt 换成 14,683 字符的另一份,工具只有 5 个。这一步每次都从头算,不吃主循环的缓存。0.28.3 新增的 inject 模式会把新消息投到正在跑的那一轮,在下一批工具调用结束时读到,也是追加而不是改写。[14]
Goose 1.60.1 改了压缩提示词,去掉了 Claude 模型会拒绝的 <analysis> 草稿段,[15] 本期没有实测。
写 agent 时可以照做的几点
五家放在一起看,思路其实一样:不变的东西放最前面,会变的东西往后放,压缩只重写历史。OpenCode 2.3.2 和 Codex 用开头的 developer 消息,Claude Code 用 system 块加显式断点,Gemini 用顶层字段。大家都在保护同一段前缀,只是各自的 API 给的工具不同。
自己写 agent 的话,下面三点可以直接拿去用。第一,GPT-6.2 上别再把长 system prompt 放 instructions,这是一条「不报错的回归」,只能靠看 usage.cached_tokens 发现。第二,日期、工作目录、git 状态这类每次都可能变的信息,不要拼进 system prompt。Claude Code 把它放进第一条用户消息之后的 system 消息,Codex 放进一条单独的 user 消息,都是为了让前面那段保持原样。第三,标题生成、路由判断、记忆提取这类旁路调用各自有一份前缀,次数多了也是一笔账,值得单独看。
上一期写的是 OpenCode 2.3 把子 agent、超时命令和压缩改到后台。压缩到底省不省钱,可以拿 Claude Haiku 5.5 当 subagent 和压缩引擎的那套账 自己算。团队层面怎么用路由和治理管住 coding agent 的花费,见 企业 coding-agent 路由与治理。Claude Code 核心循环的整体结构见 Agent Harness 模式。
测了什么,没测什么
实测过的(Linux x64,所有 CLI 都指向本机 mock 服务,没有用任何真实账号):
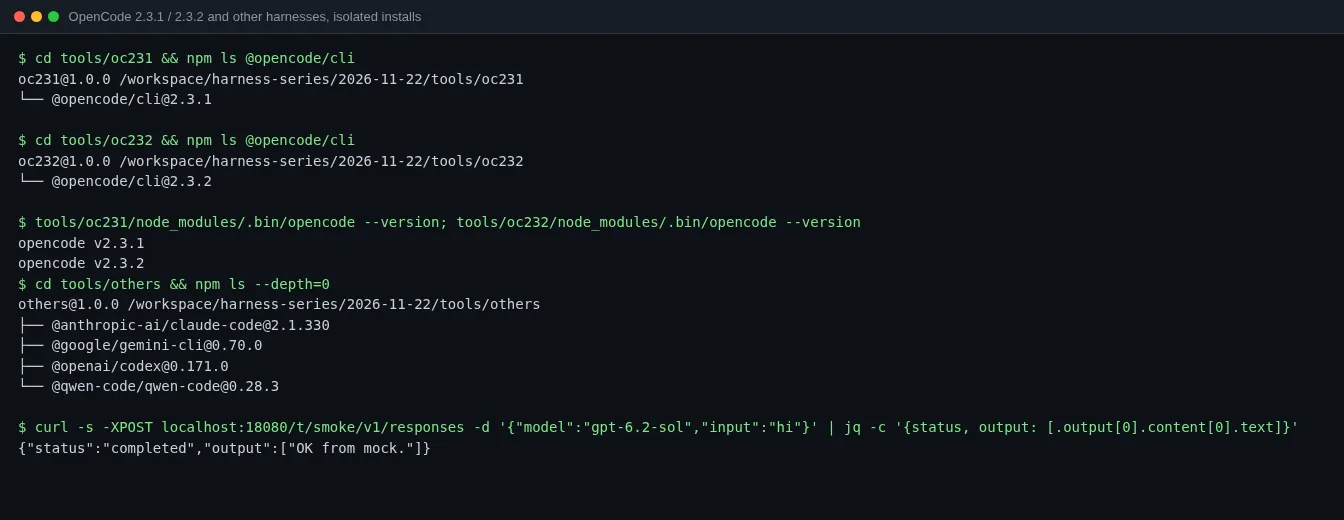
- OpenCode 2.3.1 和 2.3.2:
openai/gpt-6.2-sol、xai/grok-4.7、自定义 Responses 路由三条路的 system prompt 位置和逐步前缀,V1provider块和 OpenRouter 走 Chat Completions 的情况,native和summary两种自动压缩,TUI 里手动/compact。 - Codex CLI 0.171.0:自定义 provider(
wire_api = "responses"),exec、exec resume和一次自动压缩。 - Claude Code 2.1.330:两轮对话、手动
/compact、自动压缩。 - Gemini CLI 0.70.0 和 Qwen Code 0.28.3:一轮加一次续接会话。
没测的:
- 任何真实计费和缓存命中。mock 只能看请求长什么样,本文里的 token 和命中数字全部来自 PR、issue 和官方文档。
/responses/compact端点,以及 Copilot、Zen、Azure 的真实路由。OpenCode 内置的 OpenRouter provider 在本地走的是 Chat Completions,它平时是否用 Responses 没能确认。- Codex 在 GCP 和 Bedrock 上的增量工具声明,Codex 条目 id 是否影响缓存。
- Claude Code 的计费头是否计入缓存前缀。
- Gemini CLI 和 Qwen Code 的压缩,Qwen 的 inject 模式。
- Goose 1.60.2、Aider 0.86.0、Kimi CLI 1.52.0、Cursor CLI、Amp 本期都没有跑。
参考来源
- OpenCode v2.3.2 changelog:https://opencode.ai/changelog/v2.3.2,GitHub release:https://github.com/anomalyco/opencode/releases/tag/v2.3.2 ↩
- OpenCode PR #64542,send the OpenAI system prompt as a developer message:https://github.com/anomalyco/opencode/pull/64542 ↩
- OpenCode PR #64544,send the system prompt as a developer message on every Responses route:https://github.com/anomalyco/opencode/pull/64544 ↩
- OpenAI 文档,Prompt caching:https://developers.openai.com/api/docs/guides/prompt-caching ↩
- OpenAI 文档,Using GPT-6.2:https://developers.openai.com/api/docs/guides/latest-model ↩
- Anthropic 文档,Prompt caching:https://platform.claude.com/docs/en/build-with-claude/prompt-caching ↩
- Google 文档,Gemini API context caching:https://ai.google.dev/gemini-api/docs/caching ↩
- LiteLLM,Cost Update: OpenAI’s GPT-6.2 caching change may increase input costs:https://docs.litellm.ai/blog/gpt-6-2-instructions-caching-incident ↩
- openai/codex issue #62312:https://github.com/openai/codex/issues/62312 ↩
- OpenCode issue #64783:https://github.com/anomalyco/opencode/issues/64783 ↩
- Codex rust-v0.170.0 release notes:https://github.com/openai/codex/releases/tag/rust-v0.170.0 ↩
- Codex rust-v0.171.0 release notes:https://github.com/openai/codex/releases/tag/rust-v0.171.0 ↩
- Claude Code v2.1.328 至 v2.1.330 release notes:https://github.com/anthropics/claude-code/releases/tag/v2.1.328、https://github.com/anthropics/claude-code/releases/tag/v2.1.330 ↩
- Qwen Code v0.28.3 release notes:https://github.com/QwenLM/qwen-code/releases/tag/v0.28.3 ↩
- Goose v1.60.1 release notes:https://github.com/block/goose/releases/tag/v1.60.1 ↩