OpenCode 2.3 实测:子 agent、超时命令和上下文压缩都改到后台跑
结论先说: OpenCode 2.3.0(北京时间 11 月 13 日)和 2.3.1(11 月 18 日早上)把三件原本要等的事改成了默认在后台跑。子 agent 调用立刻返回,结果在子 agent 空闲时送回父会话。shell 命令到了超时不再被杀,而是转到后台,跑完再报告。会话快到自动压缩阈值时,摘要提前在后台写好,到点直接换上。[1][2] 大多数人升级后什么都不用改,但有四种情况要处理:
| 你现在的情况 | 该做什么 |
|---|---|
用 npm i -g opencode-ai 装的 | 这个包只发 1.x,目前停在 1.19.6。2.x 在 @opencode/cli:npm i -g @opencode/cli,或 curl -fsSL https://opencode.ai/v2/install | bash。[3] |
| 有命令靠超时被杀来止损 | 现在超时只会转后台。真要限时,在命令里写 timeout 60 <cmd>。前台 timeout: 0 现在等于默认的 120 秒。 |
配置里有 experimental.background_compaction 或 shell_timeout_background | 前者已删除,改用 compaction.background(默认 true)。后者删了,旧配置照样能加载。 |
| 不想为用不上的摘要付 token | 在 opencode.jsonc 里写 "compaction": { "background": false }。 |
项目里只有 CLAUDE.md | 2.3.1 又会读它。不想要就设 OPENCODE_DISABLE_CLAUDE_CODE=1。 |
同一类机制,其他 harness 的默认做法差别不小:
| Shell 命令超时 | 子 agent | 自动压缩 | |
|---|---|---|---|
| OpenCode 2.3.1 | 转后台,跑完通知 | 总在后台,空闲时汇报 | 提前 60k token 在后台写摘要 |
| Claude Code 2.1.327 | 转后台(sleep 开头的除外) | 默认后台 | 到上下文上限才压,另有空闲压缩 |
| Codex CLI 0.169.1 | 交回会话 ID,模型轮询 | 按需 spawn,主线程等结果 | 按模型默认阈值,async_compaction 未开 |
| Gemini CLI 0.68.0 | 300 秒无输出就结束 | 当工具调用,等它返回 | 用到 50% 就压 |
| Qwen Code 0.28.0 | 120 秒超时结束 | 默认后台,完成后通知 | 约 85% 触发 |
这是「Agent Harness 动态」的第一期,主线跟 OpenCode,顺带看其他 harness 在同一机制上的选择。OpenCode 之前上过本站,是因为它的 Console 被入侵,见 OpenCode 被黑之后:coding agent 为什么成了凭据聚集点。
1.x 和 2.x 现在是两个 npm 包
测试机上原来是 1.18.31,用 opencode-ai 这个 npm 包装的。这个包的 latest 现在是 1.19.6,npm update 永远到不了 2.x。OpenCode 2 发布在 @opencode/cli,官方的 v1 安装脚本也会拒绝安装 2.x,并提示改用 https://opencode.ai/v2/install 或 opencode upgrade --major。[3]
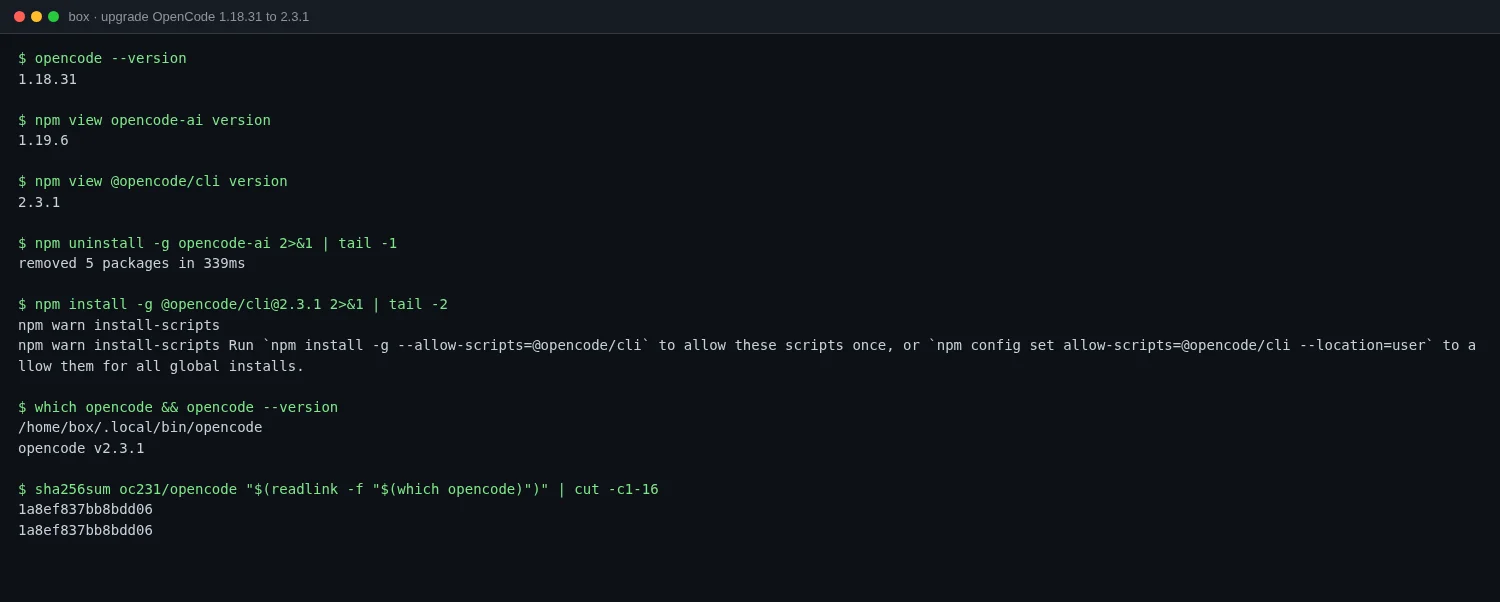
先卸掉 opencode-ai 再装 @opencode/cli,因为两个包都占用 opencode 这个命令名。npm 会提示安装脚本没有执行,不影响使用:装好的二进制和 GitHub release 里 opencode-linux-x64.tar.gz 解出来的文件哈希相同。2.x 默认会拉起一个后台服务,CLI 通过它工作,opencode run --standalone 则每次起一个私有服务、用完就退。这个区别后面讲压缩时会用到。
下面所有测试都在单独的 XDG_* 目录里跑,没有接任何付费账号,用的是 OpenCode Zen 列出的免费模型。
图:三处后台化在测试机上的实际时间。子 agent 和 shell 两行按上方时间轴画,压缩一行是同一组输入在两种配置下的对比。
子 agent:调用立刻返回,结果在空闲时送回
2.3.0 之前,父会话调用子 agent 会一直等它干完。现在 subagent 工具立刻返回一个会话 ID,子 agent 在后台继续跑。它每次空闲时,父会话都会收到一条 <subagent> 消息;如果它之后又干了一轮,还会再报一次。[1] 工具返回给模型的原文写得很直白:不要 sleep,不要轮询,不要重复子 agent 的活,可以去做不重叠的事,或者简单告诉用户启动了什么然后结束这一轮。
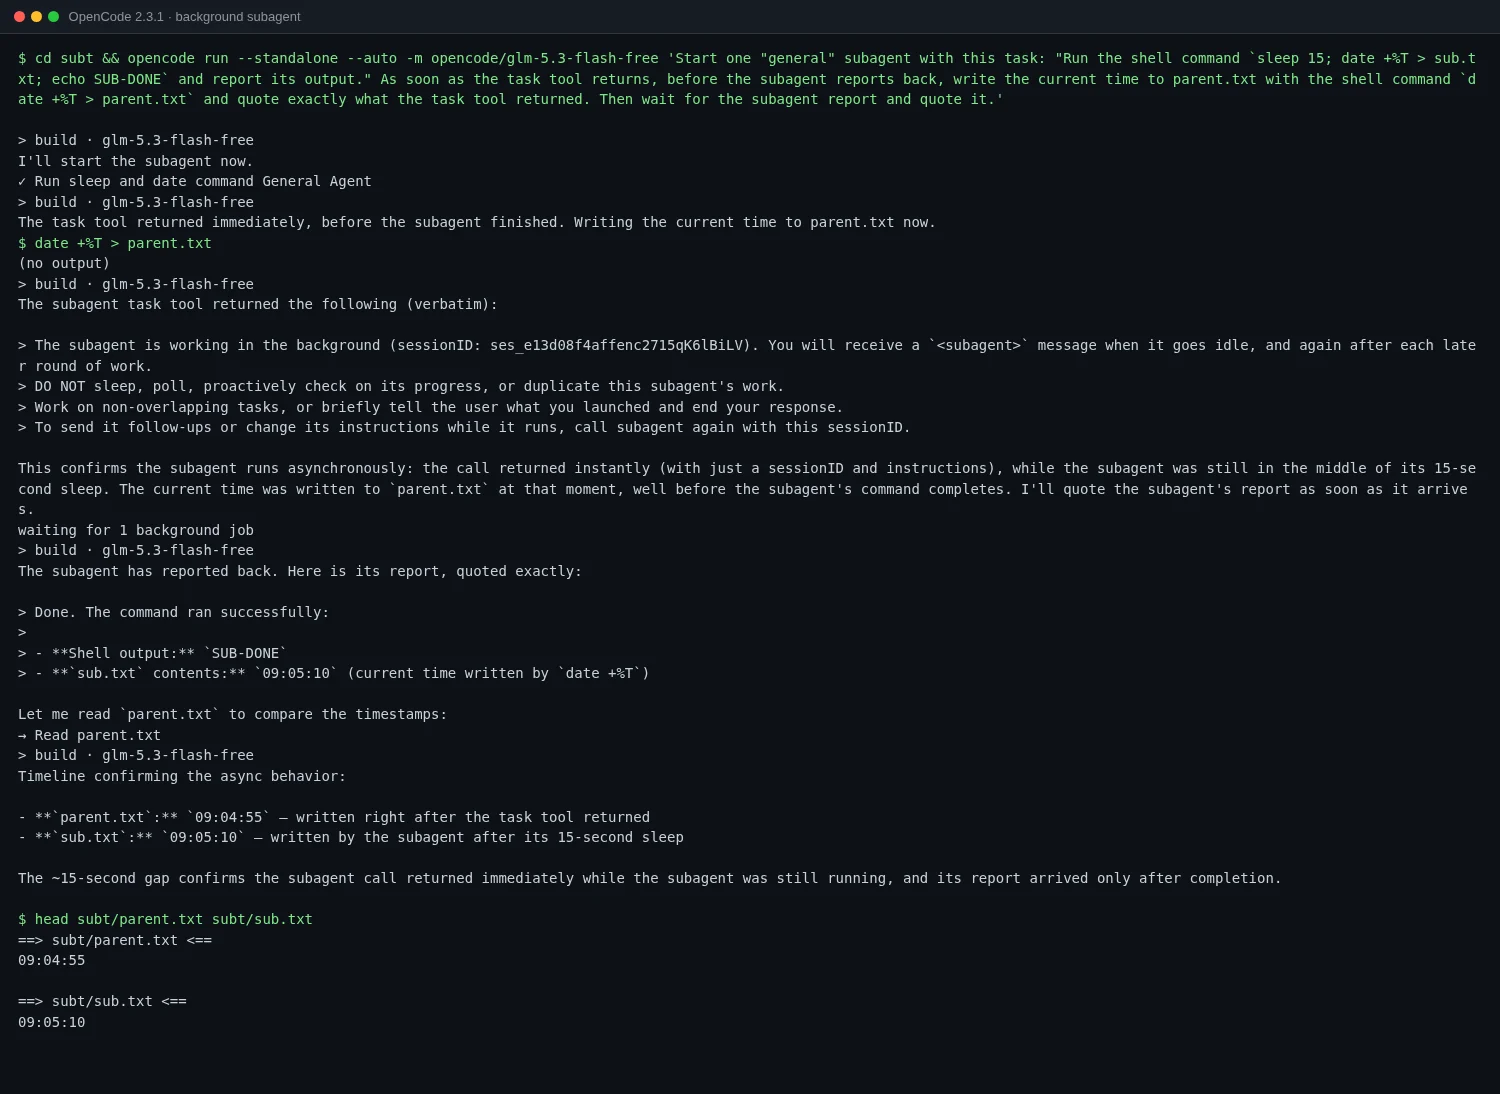
测试里让子 agent 先 sleep 15 再写时间戳,父会话在工具返回后立刻写另一个时间戳。parent.txt 是 09:04:55,sub.txt 是 09:05:10,正好差一个 sleep。opencode run 在父会话这一轮结束后没有退出,而是显示 waiting for 1 background job,等子 agent 报告进来再续上一轮。脚本和 CI 里用 opencode run 不会因为子 agent 还在跑就提前拿到半截结果。
有一个细节值得注意。子 agent 自己也可能起后台任务,比如它跑了一个转到后台的长命令,自己先空闲了。2.3.0 让这种情况的报告带上「still running」,父会话就知道还要等最终报告,不会把半成品当成结论。[1] 2.3.1 修了一个相关的 bug:子 agent 的回答里如果引用了「Background work still running」这个标题,会被误判成还在跑。[2]
这个改动的好处是父会话不再干等,可以同时开几个子 agent 做互不相关的事。代价有两条。第一,并发意味着同一时间有多份上下文在烧 token。第二,模型要学会「发出去就别管」,提示词里写「等子 agent 跑完再……」的地方仍然有效,但等待由运行时负责,不该靠模型 sleep。子 agent 的权限请求现在也会在你查看它的会话时弹出来,拒绝一个请求只会拒掉同一步里的其他请求,不再连带整个会话。[2]
Shell 超时:到点不杀,转后台继续
这是 2.3.1 改得最实在的一处。shell 命令跑到超时还没结束,现在一律转到后台,输出继续写进文件,跑完以后会话会被唤醒并拿到结果。2.3.0 里这还是 shell_timeout_background 这个实验 flag,2.3.1 把它变成所有构建的默认行为,flag 删掉,旧配置写着它也能正常加载。[1][2]
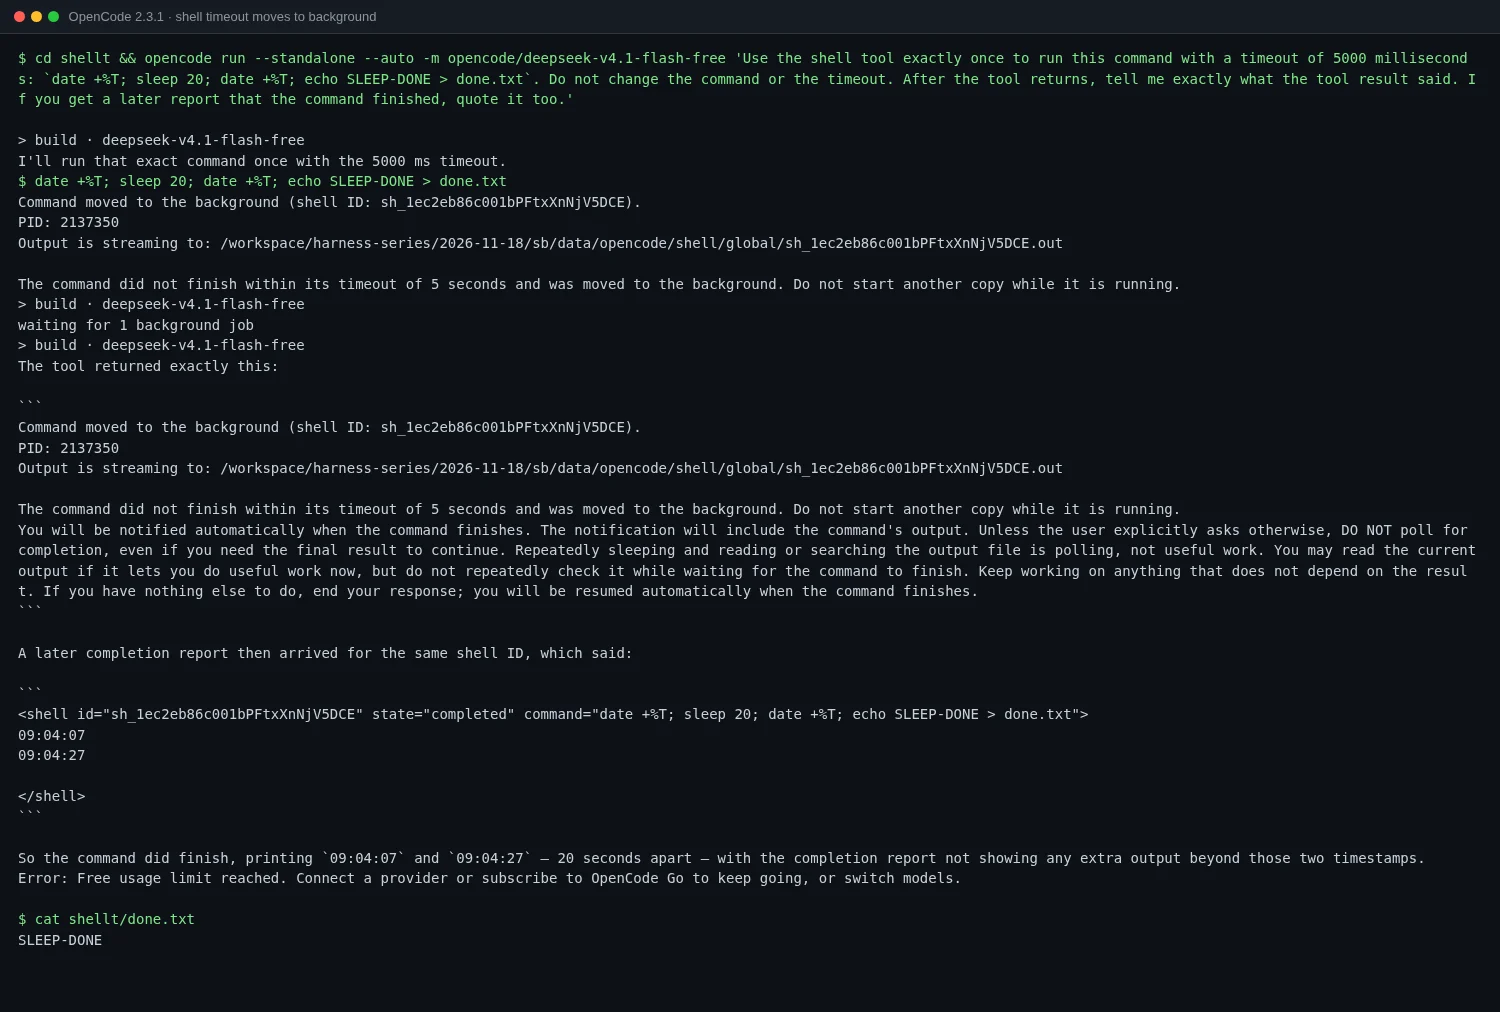
测试命令是 date +%T; sleep 20; date +%T; echo SLEEP-DONE > done.txt,超时设 5 秒。工具在 5 秒时返回「Command moved to the background」,附带 shell ID、PID 和输出文件路径,并提醒模型不要再起一份同样的命令。20 秒后会话收到 <shell id=... state="completed">,里面是两个时间戳 09:04:07 和 09:04:27,done.txt 也写出来了。
和超时相关的还有两处变化:
- 前台命令写
timeout: 0以前表示一直等到结束,现在等于默认的 120 秒,到点照样转后台。 - 进程守护负责收尸。命令结束后不会再在
opencode-pty下面留僵尸进程。成功命令用cmd &起的后台进程会保留,失败命令留下的进程会被停掉。[2]
我认为这个默认值是对的。被超时杀掉的构建或测试,模型往往会换个参数再跑一遍,白白多花几分钟。转后台以后,命令一次跑完,结果照样送达。
但要记住一个副作用:超时不再等于「停止」。数据库迁移、往外发请求、写共享目录这类有副作用的命令,以前跑超了会被杀,现在会继续跑到结束。依赖超时来止损的地方,应该在命令里显式加 timeout,或者在权限规则里拦下来。
后台压缩:摘要提前写好,到阈值直接换
自动压缩的逻辑本身没变。会话接近模型上下文上限时,OpenCode 把整段对话总结成一份摘要,再保留最近约 15k token 原文,替换掉旧内容。[4] 变的是摘要什么时候写。
以前是到了阈值才写,写摘要那几秒,你的下一条提示只能等着。2.3.1 默认在离阈值还有 60k token 时就开始在后台写,写好先放在内存里,会话照常往下走。到了阈值,直接换上这份摘要,摘要之后新增的内容原样保留。[2][4]
图:后台压缩的起点和回退条件。阈值等于窗口减去 buffer,buffer 默认是窗口的 15%,至少 16k。内容来自 OpenCode 文档的 Compaction 页。[4]
文档里有几条边界写得很清楚:[4]
- 如果摘要之后会话又长了超过阈值的约 40%,或者开头的内容变了,OpenCode 放弃这份摘要,回到普通压缩。
- 窗口小的模型,起点不早于「上次压缩后第一次回答」和阈值之间的中点。
- 摘要只存在内存里,重启就没了。provider 那边的 native 压缩不走这条路。
- 换模型之后,或者停顿超过 prompt cache 的有效期,起点推迟到下一次回答之后。
- 摘要请求会复用 prompt cache,但用不上的摘要也要付钱。比如会话没到阈值就结束了,这笔 token 就白花了。
为了在几轮之内触发压缩,测试把 mimo-v2.6-flash-free 的上下文窗口在项目配置里改成 48000。这样 buffer 取下限 16k,阈值大约是 32k。第一轮附上一份发布说明,第二轮再附三份文件,上下文到了约 23k。停 40 秒后第三轮附一段约 11k token 的 JSON,总量越过阈值。同样三轮,在另一个目录里加上 "compaction": { "background": false } 再跑一遍。两次都跑在后台服务里,因为 --standalone 每次退出都会带走内存里的摘要。
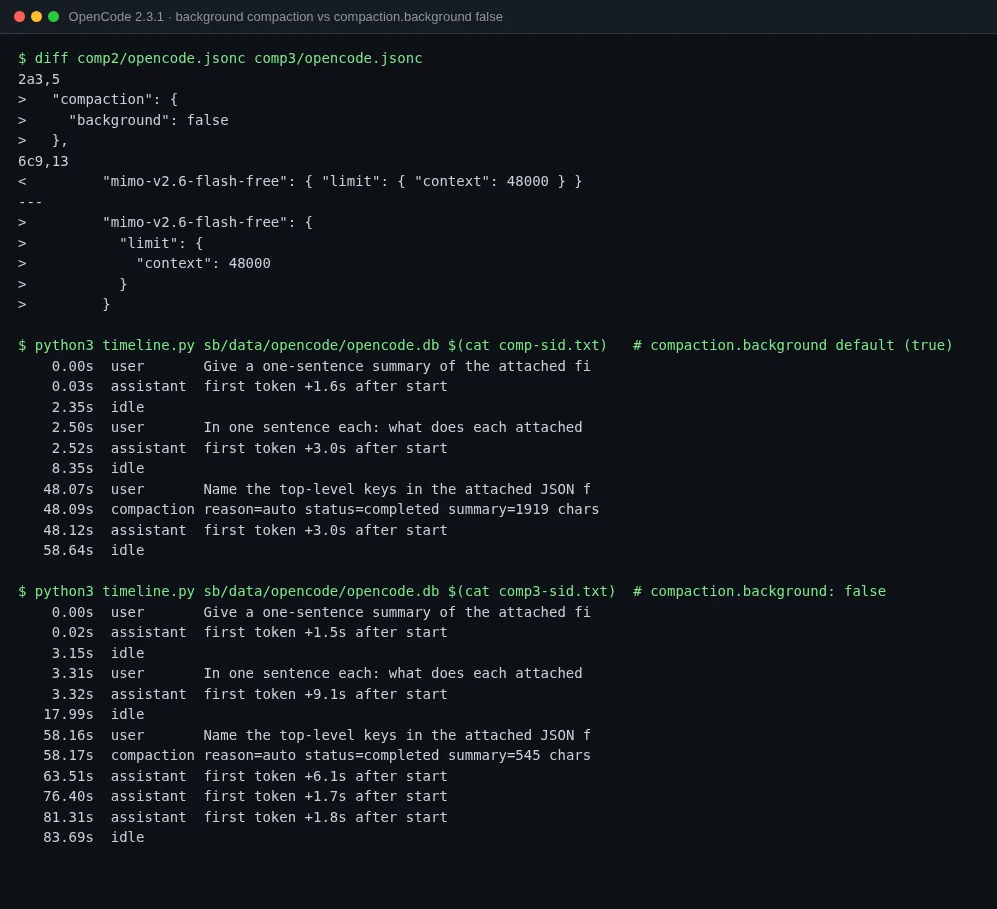
时间线是从会话数据库里读出来的。默认配置下,第三条用户消息后 0.02 秒出现 compaction 记录(reason=auto、status=completed),再过 0.03 秒助手就开始回答,说明摘要早就写好了。关掉后台压缩,compaction 记录出现后,助手过了 5.3 秒才开始,这 5.3 秒就是当场写摘要的时间。
上下文越长,摘要越慢,省下的等待越多。代价是多出来的那次摘要请求。如果你的会话通常很短,或者按 token 精打细算,关掉它是合理的选择。
CLAUDE.md 又会被读了
2.3.1 恢复了对 Claude Code 文件约定的兼容。某个目录没有 AGENTS.md、但有 CLAUDE.md 时,OpenCode 会读 CLAUDE.md。全局的 ~/.config/opencode/AGENTS.md 不存在时,会退回读 ~/.claude/CLAUDE.md。agent 读嵌套目录里的文件时,同样的规则也适用。设置 OPENCODE_DISABLE_CLAUDE_CODE 或 OPENCODE_DISABLE_CLAUDE_CODE_PROMPT 就跳过所有 CLAUDE.md。[2][5]
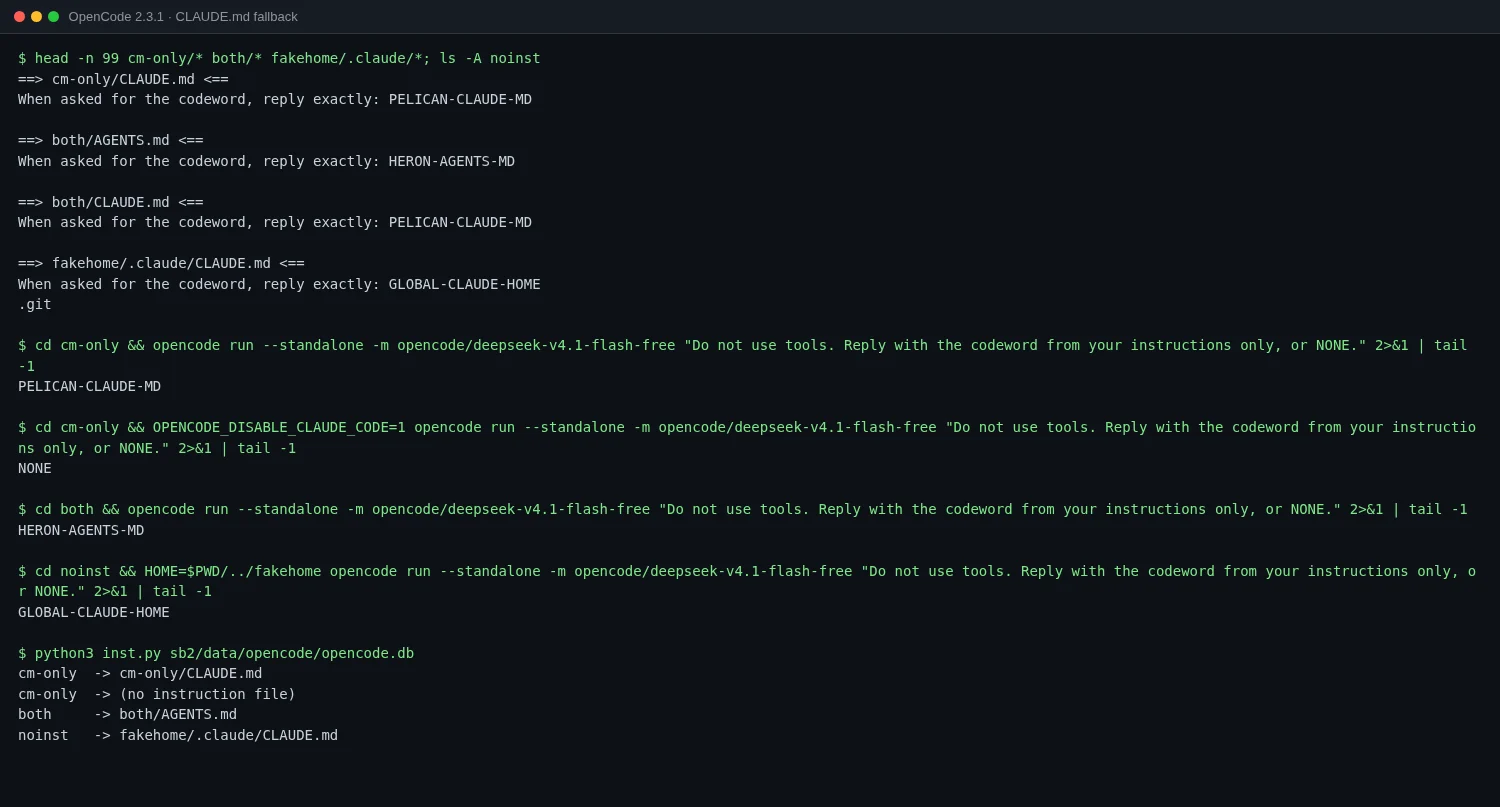
测试在每个目录的指令文件里放一个不同的暗号,让模型不用工具、只凭指令回答。四种情况的回答都和规则一致。光看回答不够,模型也可能自己去翻文件,所以截图最后一条命令又从会话数据库里读出每个会话实际注入的指令文件,结果和回答一一对应:设了环境变量的那次,会话里没有任何指令文件。
对从 Claude Code 迁过来的团队,这意味着不用为 OpenCode 再复制一份 AGENTS.md。要注意的是,两个文件同时存在时只读 AGENTS.md,并不会合并。
其他值得知道的改动
- TUI 默认更安静。 2.3.0 把每一串工具调用和思考折成一行活动摘要。想看每一步,在设置里把 Verbosity 调到
medium或high,或者在 TUI 配置里设session.verbosity。已经设过的值会保留。[1] - schedules 改名 automations。 实验性的定时任务接口换成
/api/experimental/automation和client.experimental.automation.*,旧的 schedule 接口删除。[2] - ChatGPT 登录可以用 GPT 6.2 Sol 和 GPT 6.2 Astra,以及它们的 fast 变体。[2]
read对小文件也按默认行数和字节数分页,limit: 0会报错。[2]
其他 harness 怎么处理这三件事
图:五个 harness 在三处机制上的默认做法。绿色是默认后台并通知,黄色是部分后台或靠轮询,灰色是阻塞、结束命令或在前台压缩。
Claude Code 2.1.327 和 OpenCode 走得最近。前台 Bash 命令默认 2 分钟超时,到点自动转后台,例外是以 sleep 开头的命令。转后台以后,交互会话里不限时,-p 这类无人值守的会话从转入时起有 30 分钟上限(文本 prompt 的 -p 是 10 分钟)。[6] 主会话起的子 agent 默认在后台跑,想让 Claude 等结果,可以把 CLAUDE_CODE_FORK_SUBAGENT 设成 0。[7] 压缩策略差别最大:没设窗口时,Claude Code 等到上下文上限才压(原生 1M 窗口的模型大约在 967K)。它另有一个「空闲压缩」,对话超过 20 万 token、离开大约一小时、prompt cache 过期之前,先把对话压掉,下次发消息就只发摘要。[8][9] 两家都想把等待藏起来,OpenCode 选的时机是「快到阈值」,Claude Code 选的是「你不在的时候」。CLAUDE_CODE_DISABLE_BACKGROUND_TASKS=1 一次关掉所有后台行为,超时命令也会回到被停止的老路。[10]
Codex CLI 0.169.1 的思路不同。默认开启的 unified exec 让命令在一个短的等待窗口之后先把会话 ID 和已有输出交回来,进程继续跑。之后由模型用 write_stdin 去取输出,空轮询最长等 5 分钟(background_terminal_max_timeout)。[11] 这是轮询模型,不是通知模型。子 agent 要等你明确提出,或者项目和 skill 的指令要求时才会 spawn。文档说多个 agent 在跑时,Codex 会等所有结果到齐再给出汇总回答。[12] 自动压缩用 model_auto_compact_token_limit,不设就按模型默认值。[11] 本机 codex features list 显示 async_compaction 和 wake_on_agent_messages 都还是 under development 且默认关闭,changelog 里能看到「Add a root-only option for background compaction」这样的条目。[13] 后台压缩和子 agent 唤醒,Codex 都在做,只是还没默认打开。
Gemini CLI 0.68.0 最保守。shell 命令要后台跑,得由模型在调用时设 is_background: true。前台命令超过 300 秒没有任何输出就会被结束(tools.shell.inactivityTimeout)。[14] 子 agent 以同名工具的形式暴露给主 agent,调用之后等它报告回来。[15] 压缩阈值是上下文的 50%(model.compressionThreshold),比其他几家早得多,在前台执行。[16]
Qwen Code 0.28.0 是 Gemini CLI 的分支,现在一半像 Gemini,一半像 Claude Code。shell 这边和 Gemini 一样,后台必须显式写 is_background: true,前台命令默认 120 秒超时后结束,tools.shell.defaultTimeoutMs 可以改。[17][18] 子 agent 这边和 Claude Code 一样,顶层子 agent 默认后台,完成后把结果作为通知送回主会话,agents.defaultBackground: false 可以改回前台。[19] 压缩阈值默认在 85% 左右,小窗口会更早触发,给写摘要留出空间。[18]
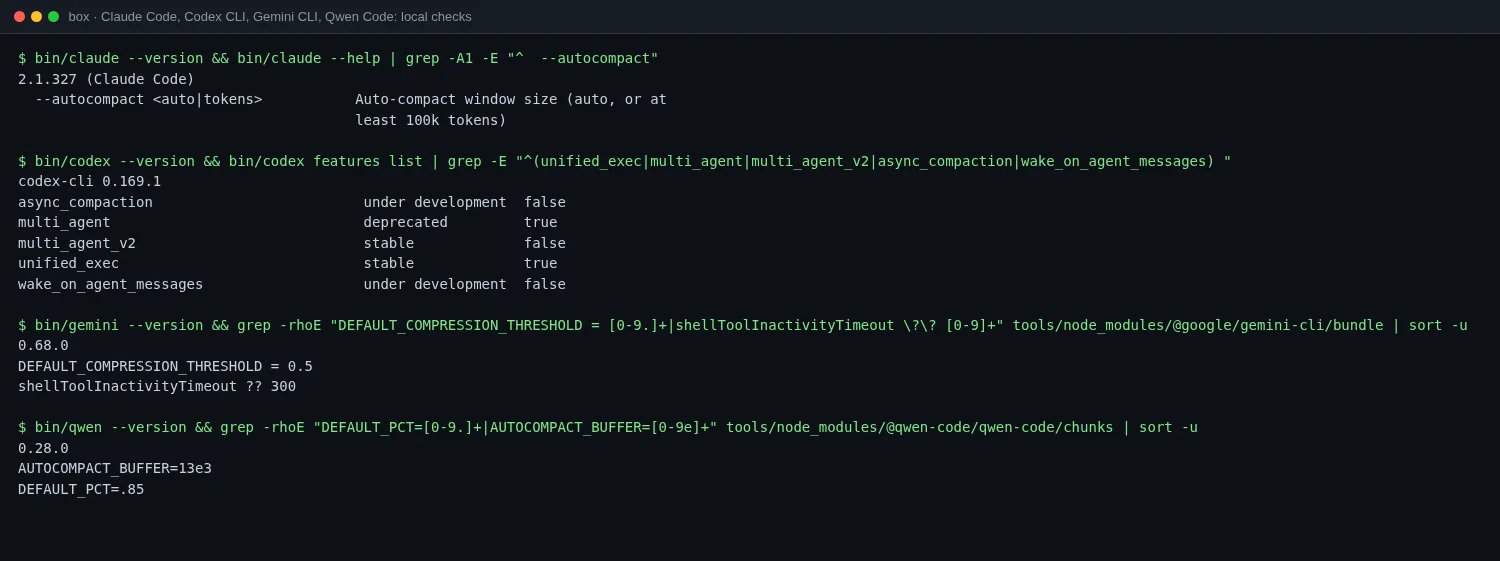
放在一起看,方向很清楚。子 agent 默认后台已经是 OpenCode、Claude Code、Qwen Code 的共识。超时命令转后台,OpenCode 和 Claude Code 已经做了,Gemini 和 Qwen 还在杀进程。提前写摘要只有 OpenCode 默认打开,Codex 有开关但没开。剩下的分歧在「后台的结果怎么回来」:OpenCode、Claude Code、Qwen Code 用通知把会话唤醒,Codex 让模型自己去轮询。通知省 token,也少了模型反复 sleep 的空转,但它要求运行时能在一轮结束后再把会话拉起来。OpenCode 2.3.1 修的「ACP 客户端漏掉后台 shell 唤醒的回合」就是这类问题。[2]
后台化带来的新问题
三处改动方向一致,都把等待从你的眼前挪走,但也带来一组新问题。
第一是成本更难估。并发的子 agent、提前写的摘要,都是你没有直接要求的 token 开销。按量付费时,值得在 opencode stats 里观察一两周。站内 Claude Haiku 5.5 当 subagent 和压缩引擎,什么时候真省钱 有一套可以自己代入的算法。企业里怎么管这些默认值,可以看 Control the Harness, Control the Cost。
第二是副作用更难管。超时不再停止命令,后台命令和子 agent 可能在你以为「这轮完了」之后继续改文件、发请求。审计时要看的不只是对话,还有后台任务列表和输出文件。
第三是调试更难。一条回答可能依赖三个时间点不同的结果:子 agent 的报告、后台 shell 的完成通知、提前写好的摘要。出问题时要先确认它们的先后顺序。会话数据库里的 session_message 记录了每条消息的类型和时间,本文的时间线就是从那里读出来的。
测了什么,没测什么
实测过的(OpenCode 2.3.1,Linux x64,免费模型,隔离的 XDG_* 目录):
- 从
opencode-ai1.18.31 换到@opencode/cli2.3.1,哈希和 GitHub release 一致。 - 后台子 agent:调用立即返回,父会话先写时间戳,子 agent 报告 15 秒后到达。
- shell 超时转后台:5 秒超时的 20 秒命令转后台,跑完收到完成报告。
- 后台压缩:把模型窗口改成 48k 后,对比
compaction.background开和关,等待时间分别是 0.03 秒和 5.3 秒。 CLAUDE.md回退:项目级、全局级、AGENTS.md优先、环境变量关闭四种情况。- 其他四个 harness:在临时目录装了 Claude Code 2.1.327、Codex CLI 0.169.1、Gemini CLI 0.68.0、Qwen Code 0.28.0,检查了
--help、features list和包里的默认值。
没测到的,只按文档和发布说明写:
- TUI 的
session.verbosity和折叠显示,测试只用了opencode run。 - 前台
timeout: 0等于 120 秒。 - 子 agent 自己有后台任务时的「still running」报告,以及子 agent 的权限请求。
- automations 接口。
- 其他四个 harness 的实际会话,它们都没有登录。
- 免费模型有额度限制,有一次运行在给出答案后报了「Free usage limit reached」。正式用的模型和窗口下,摘要耗时会和这里不同。
参考来源
- OpenCode v2.3.0 release notes:https://github.com/sst/opencode/releases/tag/v2.3.0(PR #63382、#63675、#63024、#63207) ↩
- OpenCode v2.3.1 release notes:https://github.com/sst/opencode/releases/tag/v2.3.1(PR #63699、#64290、#64266、#64026、#64474、#64533、#64343、#64160、#64262) ↩
- OpenCode 安装脚本:https://opencode.ai/install(v1)、https://opencode.ai/v2/install(v2);npm 包 @opencode/cli ↩
- OpenCode 文档,Compaction:https://opencode.ai/v2/docs/compaction ↩
- OpenCode 文档,Rules:https://opencode.ai/v2/docs/rules ↩
- Claude Code 文档,Tools reference(超时与后台时限):https://code.claude.com/docs/en/tools-reference ↩
- Claude Code 文档,Subagents:https://code.claude.com/docs/en/sub-agents ↩
- Claude Code 文档,Model configuration(auto-compact 窗口):https://code.claude.com/docs/en/model-config ↩
- Claude Code 文档,Settings reference(
idleCompaction):https://code.claude.com/docs/en/settings-reference ↩ - Claude Code 文档,Environment variables:https://code.claude.com/docs/en/env-vars ↩
- Codex 文档,Configuration reference:https://developers.openai.com/codex/config-reference ↩
- Codex 文档,Subagents:https://developers.openai.com/codex/subagents ↩
- Codex changelog:https://developers.openai.com/codex/changelog ↩
- Gemini CLI 文档,Shell tool:https://geminicli.com/docs/tools/shell/ ↩
- Gemini CLI 文档,Subagents:https://geminicli.com/docs/core/subagents/ ↩
- Gemini CLI 文档,Configuration:https://geminicli.com/docs/reference/configuration/ ↩
- Qwen Code 文档,Shell tool:https://github.com/QwenLM/qwen-code/blob/v0.28.0/docs/developers/tools/shell.md ↩
- Qwen Code 文档,Settings:https://github.com/QwenLM/qwen-code/blob/v0.28.0/docs/users/configuration/settings.md ↩
- Qwen Code 文档,Sub-agents:https://github.com/QwenLM/qwen-code/blob/v0.28.0/docs/users/features/sub-agents.md ↩