OpenCode 2.3.2 実地検証:GPT-6.2 は instructions をキャッシュしないので、system prompt は先頭の developer メッセージへ
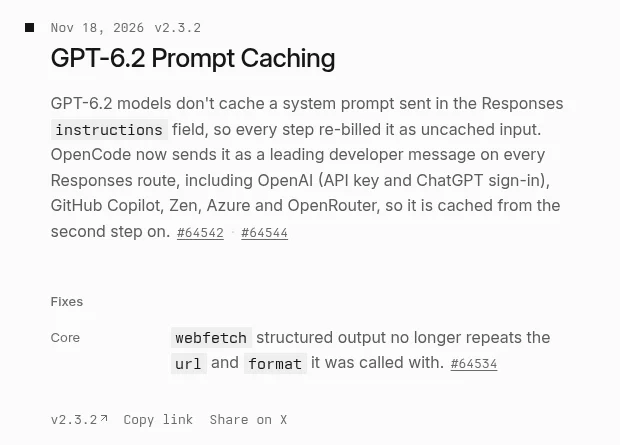
結論: GPT-6.2 から、Responses API はリクエストのトップレベルにある instructions を input の後ろに付け、キャッシュのブレークポイントの外に置くようになった。中身が毎回まったく同じでも、この部分はキャッシュなしの料金になる。[4][5] OpenCode は system prompt をずっと instructions に入れていたので、GPT-6.2 では毎ステップ 1 万トークンを超える system prompt に正規料金を払っていた。2.3.2(日本時間 11 月 18 日 10 時 35 分公開)はこれを input の最初の developer メッセージに移し、2 ステップ目からキャッシュに乗るようにした。GitHub Copilot の gpt-6.2-sol では、1 ステップあたりのキャッシュなし入力が 14,163 トークンから 3 に減った。[1][3]
| 状況 | やること |
|---|---|
| OpenCode で GPT-6.2 を使っている(API キー、ChatGPT サインイン、Copilot、Zen、Azure、OpenRouter) | 2.3.2 に上げる。opencode upgrade、npm i -g @opencode/cli@latest、curl -fsSL https://opencode.ai/v2/install | bash のどれか。設定の変更は不要。 |
自前のルーターを V1 の provider ブロックと "npm": "@ai-sdk/openai-compatible" で設定している | この経路は AI SDK を通るので今回の修正の対象外。V2 の providers ブロックに書き換え、package に @opencode/ai/providers/openai-compatible/responses を指定する。[10] |
| 間に LiteLLM のようなゲートウェイがあり、そこで Responses リクエストに変換している | ゲートウェイ側の修正も要る。LiteLLM は v1.108.13 や v1.110.2 などで直した。LiteLLM 経由で Claude Code から GPT-6.2 を呼んでいた場合も影響を受けていた。[8] |
| 自分のコードから Responses API を呼んでいる | 固定の system prompt は input 先頭の developer メッセージに入れる。instructions は「最後のターンで要約して」のような、そのリクエスト限りの指示だけに使う。 |
| GPT-6.1 以前のモデルを使っている | どちらの形でもキャッシュされる。上げても結果は変わらない。[2] |
プレフィックスキャッシュは完全に同じ先頭にしか効かない
モデルは入力を処理するとき、トークンごとに中間結果(KV キャッシュ)を計算する。次のリクエストの先頭がまったく同じなら、サーバーはその結果を使い回し、増えた部分だけを計算すればよい。使い回した部分はキャッシュ料金になる。GPT-6.2 Sol と Astra では、キャッシュ読み出しが通常入力の 0.05 倍、書き込みが 1.25 倍(30 分の有効期間)か 2.5 倍(12 時間)だ。[4] だからエージェントが毎ステップ送るリクエストは、先頭が長く安定しているほど安くなる。
「先頭が同じ」とは、描画後のトークン列が 1 つずつ一致するという意味で、意味が同じかどうかは関係ない。途中で 1 文字変えれば、そこから後ろは全部無効になる。OpenAI はリクエストの中にいくつかの「参照境界」を探し、長いものから順に、どのプレフィックスがすでにキャッシュにあるかを試す。GPT-5.6 以降の暗黙モードでは、その境界に、最新の対象メッセージの末尾、それより前の最大 20 個のメッセージ末尾、そして先頭に連続する developer メッセージ群の終わりが含まれる。[4] 最後の 1 つが肝心だ。system prompt が先頭の developer メッセージでありさえすれば、その後ろの会話が全部変わっても、この部分だけで当たる。
GPT-6.2 の instructions はちょうど反対側にある。ドキュメントによれば、GPT-6.2 以降のモデルはこれを input の後ろに付けるので、ターンごとに書き換えても前のキャッシュは壊れない。その代わり常にブレークポイントの外にあり、毎回キャッシュなしで課金され、明示的なブレークポイントも置けない。[4][5] 設計としては筋が通っている。instructions はもともと 1 回のリクエストにだけ効く指示のための場所だ。問題は、ほとんどのクライアントが system prompt を丸ごとここに入れていたことにある。GPT-6.1 までは developer メッセージとキャッシュの効き方が同じだったので、区別する理由が誰にもなかった。
エラーは何も出ない。リクエストは普通に成功し、請求だけが膨らむ。LiteLLM の振り返りは率直で、OpenAI が 11 月 17 日にドキュメントを更新したとき彼らのアラートは 1 つも鳴らず、18 日に顧客から「キャッシュが当たらない」と言われて気づいたという。[8] もう 1 つ紛らわしい点がある。OpenAI のキャッシュ診断(prompt_cache_options.comparison_response_id)は instructions のリクエストで cache_hit を返す一方、usage の cached_tokens と cache_write_tokens はどちらも 0 だった。[2][9] 請求を確かめるなら usage を信じること。
2.3.1 と 2.3.2 でリクエストの何が変わったか
OpenCode をローカルの mock サーバーに向け、モデルを openai/gpt-6.2-sol にして、ツール呼び出しを 1 回ずつ含む 2 ターンの会話を流すと、リクエストは次のようになる。
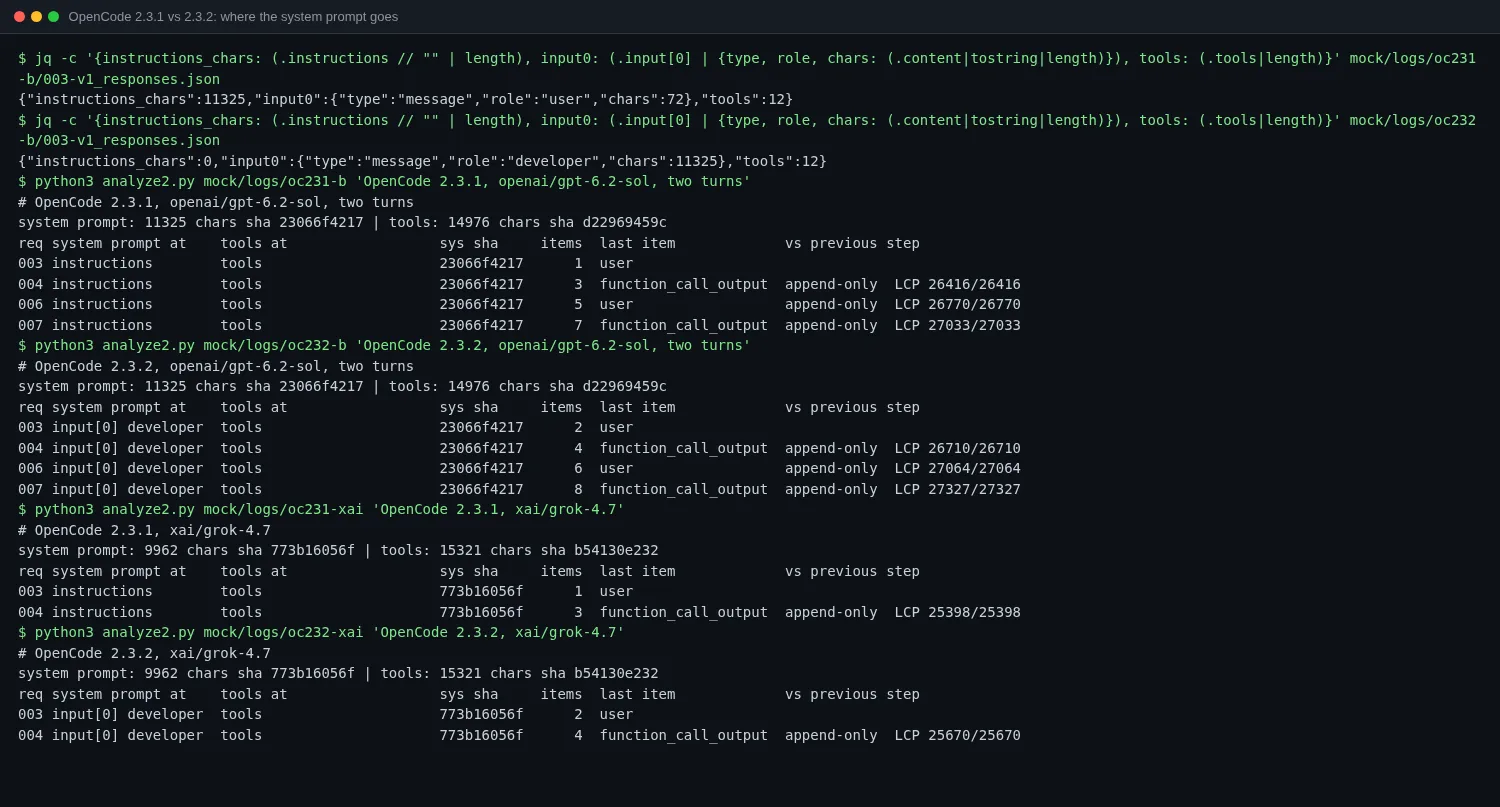
2.3.1 では instructions に 11,325 文字の system prompt が入り、input[0] はユーザーメッセージだ。2.3.2 には instructions がなく、input[0] が developer メッセージで、中身は同じ 11,325 文字、ハッシュも同じ。12 個のツール宣言(14,976 文字)は両バージョンでまったく同じで、引き続きトップレベルの tools にある。どのステップも前のリクエストに新しい項目を足しただけだ。tools、system prompt、input の順につなげて比べると、前のステップの全文が次のステップの先頭になっている。これも両バージョン共通だ。
つまり 2.3.2 が変えたのは 1 点だけで、system prompt の置き場所だ。テキストは 1 バイトも変わっていない。GPT-6.1 なら 2 つのリクエストのキャッシュの効き方は同じ。GPT-6.2 では前者が毎ステップ、この 11k 文字に正規料金を払う。
xai/grok-4.7 と、自前のルーター(V2 の providers ブロックで package に @opencode/ai/providers/openai-compatible/responses を指定)でも同じ比較をした。結果は同じで、2.3.1 は instructions、2.3.2 は先頭の developer メッセージだった。これは 2 つの PR の分担どおりだ。#64542 がまず OpenAI 自身の Responses 経路を直し、#64544 がその変更をすべての Responses 経路が共有する OpenResponses.lowerConversation に移した。Copilot、xAI、OpenRouter、Vercel AI Gateway、自前の OpenAI 互換サーバーもそれに従う。[2][3]
実際の請求は mock では測れないので、数字は PR 作者の実測による。ChatGPT サインイン、gpt-6.2-sol、1 セッションで短いプロンプト 3 つの場合、ステップごとのキャッシュなし入力は 16,969、16,992、14,457 から 16,969、352、121 になった。[2] API キーで直接送ると、instructions の形は 4 ステップともキャッシュ 0、developer メッセージの形は 2 ステップ目から 9,632、9,660、9,691 トークンがキャッシュに当たった。[2]
アップグレードしても得をしない設定が 2 つある。1 つは V1 の provider ブロックに "npm": "@ai-sdk/openai-compatible" を書いたもの。この経路は /chat/completions を呼び、system prompt は messages[0] なので、もともと instructions とは関係がない。もう 1 つは V1 ブロックに package を書きつつ npm も残しているもの。V2 は実行系を npm からしか取らず、package は無視される。#64783 のユーザーがまさにこれで、2.3.2 に上げても毎ラウンド 1 万から 2 万トークンがキャッシュなしのままだったが、V2 の書き方に変えると約 6k まで減った。[10]
{
  "providers": {
    "myrouter": {
      "package": "@opencode/ai/providers/openai-compatible/responses",
      "settings": { "baseURL": "https://router.example.com/v1", "apiKey": "{env:ROUTER_KEY}" },
      "models": { "gpt-sol": { "limit": { "context": 1050000, "output": 128000 }, "body": { "store": false } } }
    }
  }
}
圧縮のあと、プレフィックスはどれだけ残るか
キャッシュにとって一番の敵は圧縮だ。OpenAI のドキュメントも、要約、圧縮、切り詰めはプレフィックスを変えてキャッシュの再利用をリセットしうると書いている。[4] クライアントにできるのは、履歴だけを書き換え、前にある system prompt とツールには触らないことだ。
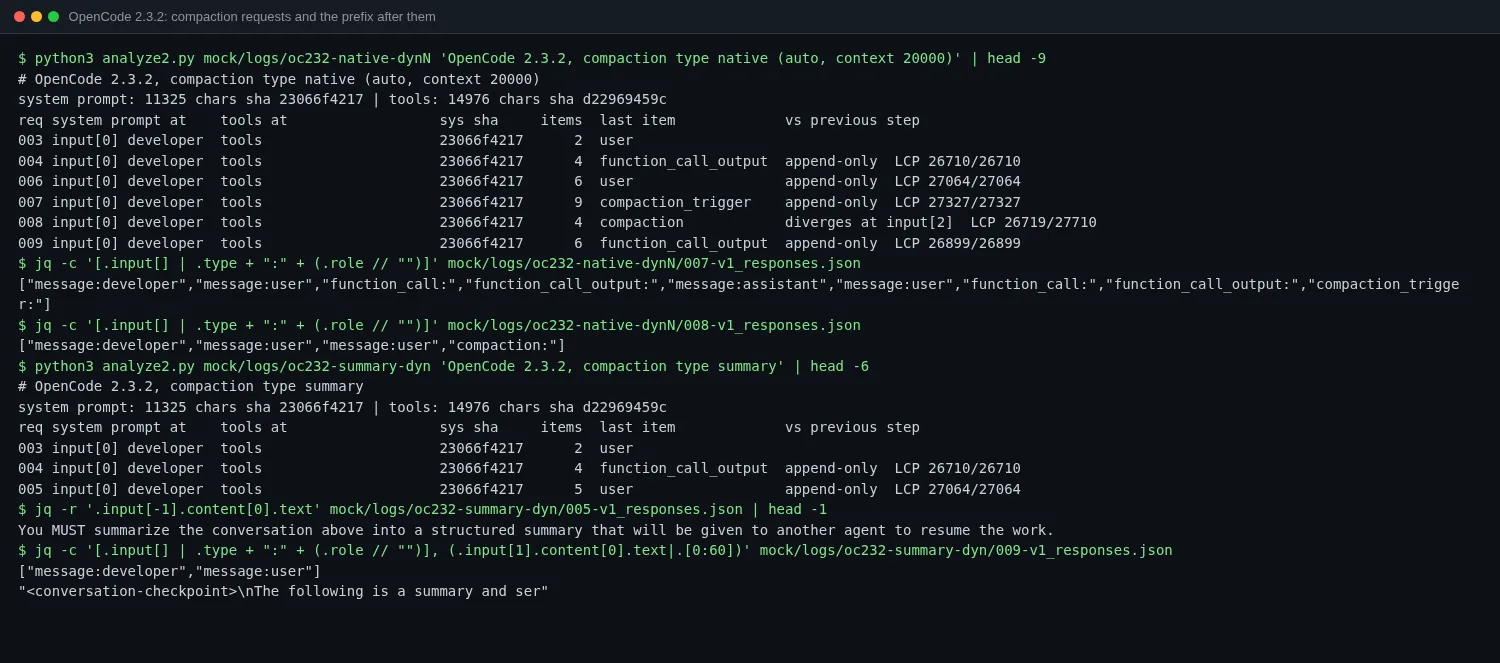
2.3.2 のコンテキストウィンドウを 20,000 にし、mock が返すトークン数を少しずつ増やすと、自動圧縮が走る。compaction.type が native のとき、OpenCode は別のリクエストを立てず、通常の /responses リクエストの末尾に compaction_trigger を付ける。前の内容はそのまま残るので、このステップも前のステップの延長だ。圧縮後の次のリクエストは [developer, 最初の user, user, compaction] になる。system prompt、ツール、最初のユーザーメッセージは残り、違いは input[2] から始まる。TUI で /compact と打っても同じ経路を通る。
summary のときは、要約を書かせるリクエストも完全なプレフィックスに「You MUST summarize the conversation above…」で始まるユーザーメッセージを足した形なので、前のキャッシュを使える。圧縮後に残るのは [developer, user "<conversation-checkpoint>…"] で、system prompt とツールは変わらない。2.3.1 も両モードで同じ形だが、system prompt はまだ instructions にある。
リリースノートには、/responses/compact も同じキャッシュ済みプレフィックスを読むようになったとある。[1] #64544 によると、gpt-6.2-sol で instructions 付きの compact リクエストはキャッシュ 0 トークン、developer メッセージにすると 3,190 のうち 2,962 を読んだ。[3] ローカルでの圧縮はどれもこのエンドポイントに届かなかったので、ここは直接は確認できていない。
ほかのツールはプレフィックスをどう並べるか
同じ mock に Codex CLI 0.171.0、Claude Code 2.1.330、Gemini CLI 0.70.0、Qwen Code 0.28.3 もつないだ。どれも system prompt を instructions には入れていないが、並べ方はそれぞれ違う。
| プロトコル | system prompt | ツール宣言 | キャッシュ指定 | 圧縮後のプレフィックス | |
|---|---|---|---|---|---|
| OpenCode 2.3.2 | Responses | input[0] の developer(11,325 文字) | トップレベル tools(12 個) | なし、暗黙の境界頼み | system とツールは不変、履歴を書き換え |
| Codex 0.171.0 | Responses | input[1..4] の developer 4 件 | input[0] の additional_tools | なし | 中身は同じ、項目 id はすべて新規 |
| Claude Code 2.1.330 | Messages | トップレベル system の 3 ブロック | トップレベル tools(12 個) | system[1]、system[2]、最後のメッセージ | system[0] の課金ヘッダーだけ変化 |
| Gemini CLI 0.70.0 | generateContent | トップレベル systemInstruction(30,747 文字) | トップレベル tools | なし、cachedContent も使わない | 未検証 |
| Qwen Code 0.28.3 | Chat Completions | messages[0] の system(22,432 文字) | トップレベル tools(10 個) | なし | 未検証 |
Codex は instructions を一切送らず、トップレベルの tools もない。incremental_tools が有効で、ツール宣言は input[0] の additional_tools 項目に入り、functions、clock、collaboration の 3 グループで計 26,071 文字。続いて developer メッセージが 4 件(1 件目は 26,194 文字)、環境情報を入れた user メッセージが 1 件、最後にユーザーの入力が来る。#64542 が書いている「ツールが先頭の additional_tools にあるなら、system prompt はその直後」という並びそのものだ。[2] 各ステップも codex exec resume も、前のリクエストに足していくだけだった。0.170.0 は GCP で、0.171.0 は Bedrock で、増分ツール宣言を既定で有効にした。0.171.0 は圧縮をまたいで有効な追加コンテキストも保つようになった。[11][12]
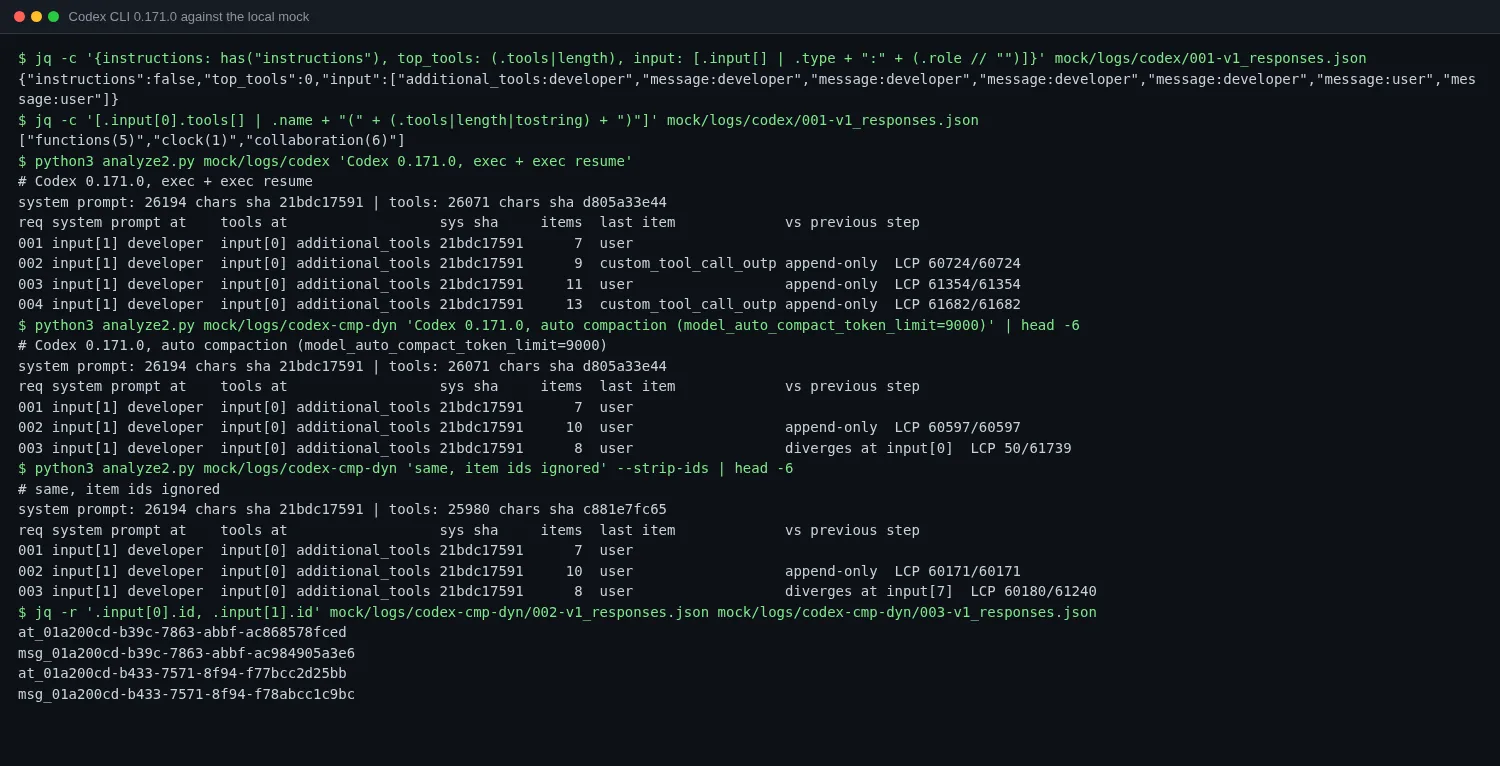
model_auto_compact_token_limit を 9,000 にして自動圧縮を起こすと、Codex は初期コンテキストを作り直した。ツールと developer メッセージのテキストは同一だが、各項目の id(at_…、msg_…)はすべて新しく発行される。id を無視して比べると、先頭 7 項目は完全に一致する。項目 id がモデルの見るトークン列に入るかどうかはローカルでは判断できない。入らないなら、圧縮後もプレフィックスはそのまま使える。なお OpenAI のドキュメントによると additional_tools 項目は prompt_cache_breakpoint を受け付けないので、ツールに明示的なブレークポイントを置くなら、その後ろの developer メッセージに置くことになる。[4]
Claude Code は Anthropic Messages を使う。Anthropic のキャッシュプレフィックスは tools、system、messages の順で固定され、ブレークポイントは最大 4 つ、各ブレークポイントから 20 ブロックさかのぼって探す。[6] Claude Code の system は 3 ブロックで、1 つ目は 74 文字の x-anthropic-billing-header: cc_version=2.1.330.581; cc_entrypoint=sdk-cli;、2 つ目は 62 文字の名乗り、3 つ目は 7,077 文字の本文だ。cache_control は 2 つ目と 3 つ目のブロックと最後のメッセージに付き、ツールには付かない。環境情報は system には入らず、最初のユーザーメッセージの後ろに role が system のメッセージ(9.4k 文字)として差し込まれ、リクエストには mid-conversation-tool-changes などの beta フラグが付く。作業ディレクトリやプラットフォームのような環境しだいの情報が、前の system prompt に触れないようにするためだ。
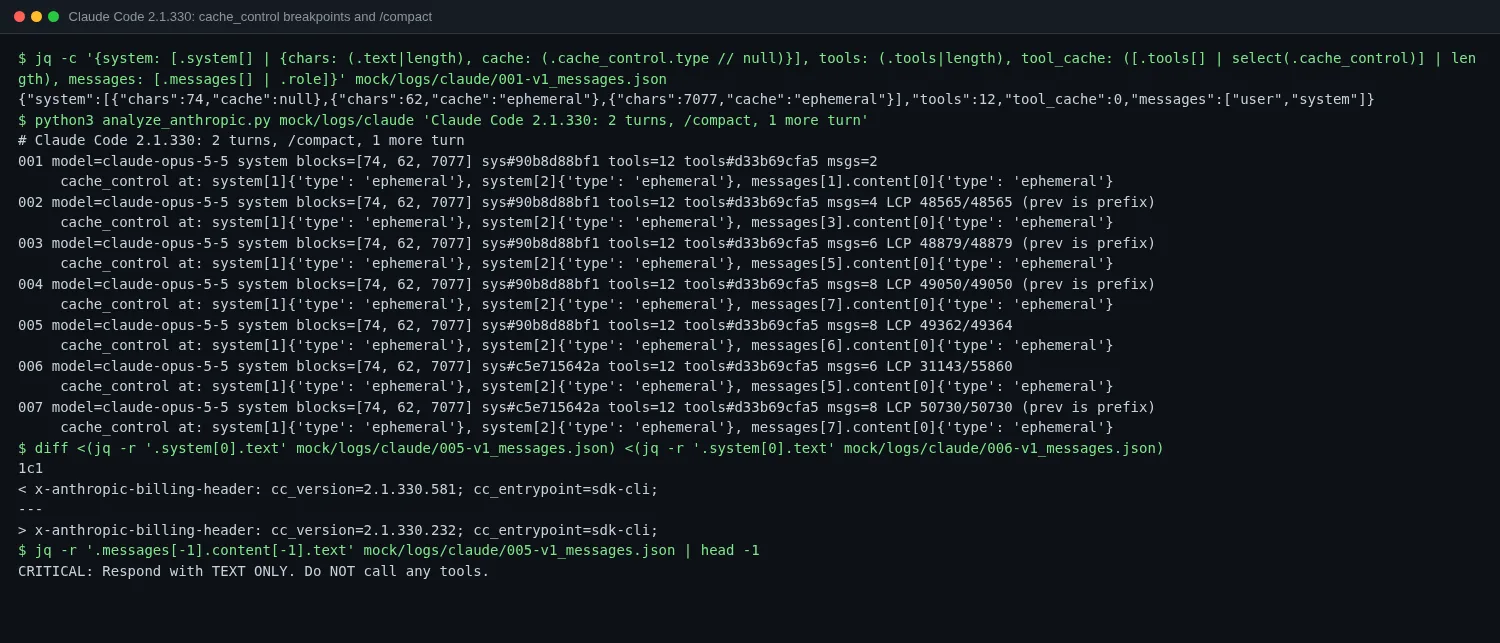
手動の /compact では、要約リクエストが最後のユーザーメッセージに「CRITICAL: Respond with TEXT ONLY…」を足し、プレフィックスは丸ごと残す。圧縮後もツールと system の本文は変わらない。変わったのは 1 つ目のブロックの課金ヘッダーの数字だけで、.581 から .232 になった。別々の 2 セッションでも同じ 2 つの値だった。自動圧縮も同じだ。2.1.328 で、自動圧縮が古い system prompt を使い回す問題が直り、今は /compact と同じように system prompt を組み直す。[13] この課金ヘッダーは system の一番前にある。これがキャッシュの比較対象のプレフィックスに入るかどうかは、実際のアカウントがないと分からない。
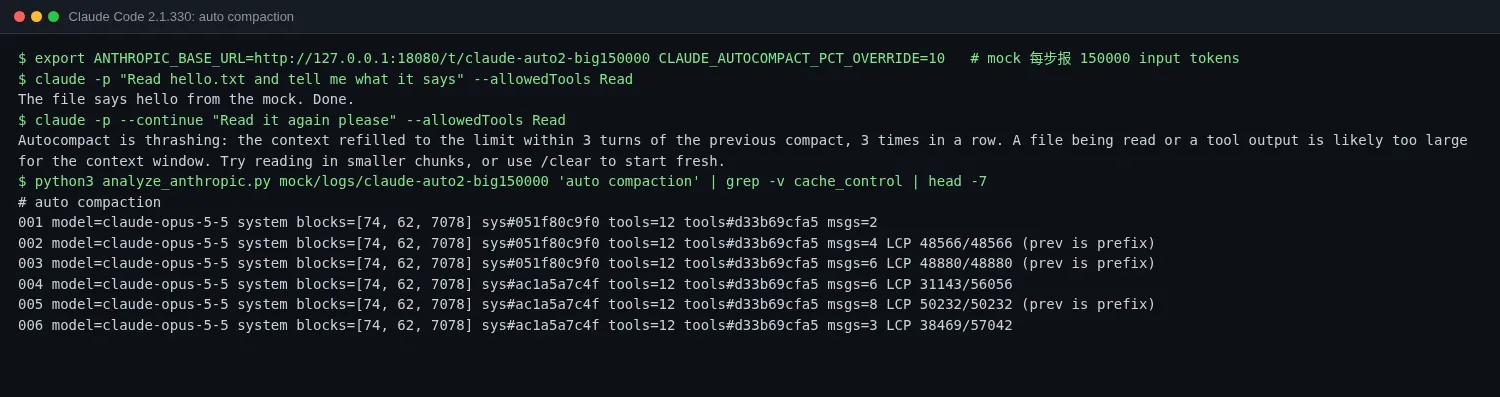
自動圧縮を試しているとき、ある警告にも出くわした。mock が毎ステップ 150,000 入力トークンを返し、CLAUDE_AUTOCOMPACT_PCT_OVERRIDE を 10 にすると、Claude Code は何度か続けて圧縮したあと「Autocompact is thrashing: the context refilled to the limit within 3 turns of the previous compact, 3 times in a row」と言って止まった。実際の作業でこれが出たら、たいていはファイルかツール出力が大きすぎる。
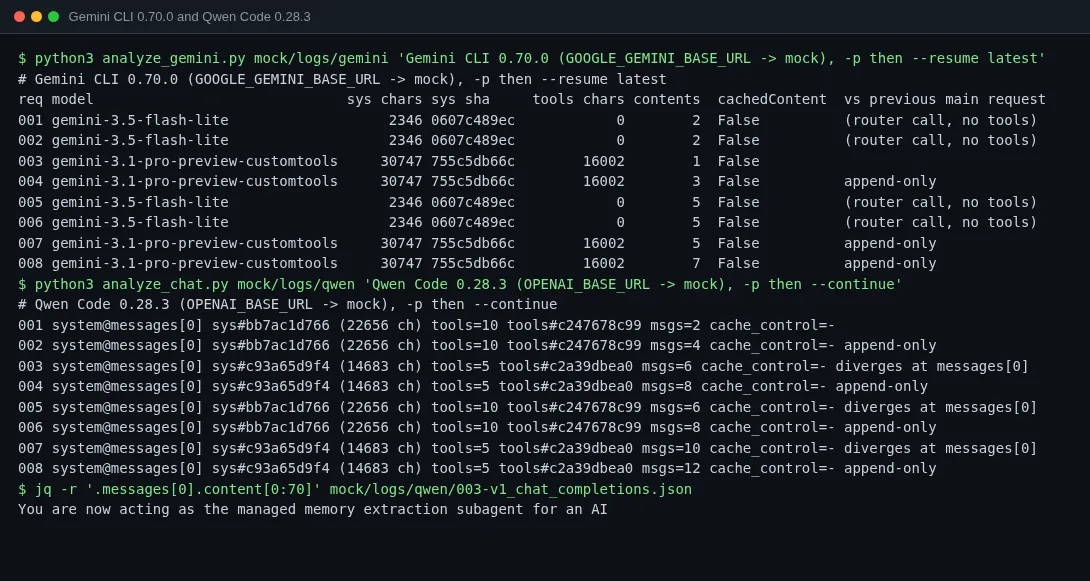
Gemini CLI は 30,747 文字の systemInstruction と 16,002 文字のツール宣言をトップレベルに置く。どちらも毎ステップ、--resume latest のあとも変わらず、contents は足されていくだけで、明示的な cachedContent は使わない。Gemini 2.5 から既定で有効な暗黙キャッシュに任せている。Google のドキュメントは大きな共通部分を先頭に置くよう勧めており、まさにその形だ。[7] また各ターンの前に gemini-3.5-flash-lite でルーティング判定を 2 回走らせる。こちらは system prompt が 2,346 文字でツールはなく、別のプレフィックスになる。
Qwen Code は Chat Completions を使う。system prompt は messages[0](22,432 文字)、ツール 10 個はトップレベルで、cache_control はどこにもない。キャッシュが効くかどうかは完全に接続先しだいだ。メインループは --continue のあとも足していくだけ。ただし毎ターンの終わりに「managed memory extraction」サブエージェントが走り、system prompt は 14,683 文字の別物、ツールは 5 個になる。この呼び出しは毎回最初から計算され、メインループのキャッシュは使えない。0.28.3 で加わった inject モードは、新しいメッセージを実行中のターンに届け、次のツール呼び出しの区切りで読ませる。これも書き換えではなく追加だ。[14]
Goose 1.60.1 は圧縮プロンプトから、Claude のモデルが拒否する <analysis> の下書き欄を外した。[15] 今回は検証していない。
エージェントを作るときにそのまま使えること
5 つを並べると、考え方は同じだ。変わらないものを前に、変わるものを後ろに置き、圧縮では履歴だけを書き換える。OpenCode 2.3.2 と Codex は先頭の developer メッセージ、Claude Code は system ブロックと明示的なブレークポイント、Gemini はトップレベルのフィールドを使う。どれも同じ区間のプレフィックスを、それぞれの API が用意した手段で守っている。
自分でエージェントを書くなら、次の 3 つはそのまま持っていける。1 つ目、GPT-6.2 では長い system prompt を instructions に入れない。エラーの出ない退行なので、usage.cached_tokens を見ていないと気づけない。2 つ目、日付、作業ディレクトリ、git の状態など、リクエストごとに変わりうる情報は system prompt に混ぜない。Claude Code は最初のユーザーメッセージの後ろの system メッセージに、Codex は別の user メッセージに入れている。どちらも前の部分をそのまま保つためだ。3 つ目、タイトル生成、ルーティング、記憶の抽出といった脇の呼び出しは、それぞれ別のプレフィックスを持つ。回数が多ければ、それだけで確認する価値のある出費になる。
前回は OpenCode 2.3 がサブエージェント、タイムアウトしたコマンド、圧縮をバックグラウンドに移した話 を書いた。圧縮がそもそも得かどうかは When Claude Haiku 5.5 Actually Saves Money as a Subagent or Compaction Engine(英語) の計算で確かめられる。チーム単位でコーディングエージェントの出費をどう抑えるかは Control the Harness, Control the Cost(英語) を、Claude Code のコアループの全体像は エージェント・ハーネス・パターン を参照してほしい。
検証したこと、していないこと
検証したこと(Linux x64、すべての CLI をローカルの mock サーバーに向け、実アカウントは一切使っていない):
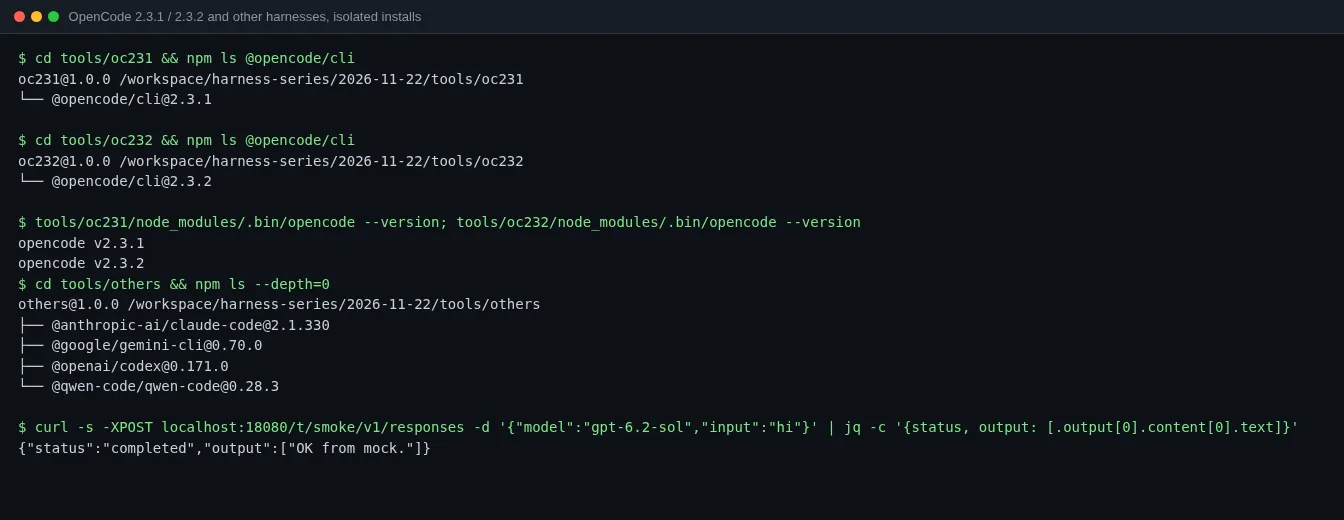
- OpenCode 2.3.1 と 2.3.2:
openai/gpt-6.2-sol、xai/grok-4.7、自前の Responses ルーターの 3 経路での system prompt の位置とステップごとのプレフィックス。V1 のproviderブロックと OpenRouter が Chat Completions を通るケース。nativeとsummaryの自動圧縮。TUI での手動/compact。 - Codex CLI 0.171.0:カスタム provider(
wire_api = "responses")でexec、exec resume、自動圧縮 1 回。 - Claude Code 2.1.330:2 ターン、手動
/compact、自動圧縮。 - Gemini CLI 0.70.0 と Qwen Code 0.28.3:1 ターンとセッション再開。
検証していないこと:
- 実際の課金とキャッシュヒット。mock で見えるのはリクエストの形だけで、本文のトークン数やヒット数はすべて PR、issue、公式ドキュメントによる。
/responses/compactエンドポイントと、Copilot、Zen、Azure の実際の経路。OpenCode 組み込みの OpenRouter provider はローカルでは Chat Completions を通ったが、普段 Responses を使うかどうかは確認できていない。- GCP と Bedrock での Codex の増分ツール宣言、Codex の項目 id がキャッシュに影響するかどうか。
- Claude Code の課金ヘッダーがキャッシュのプレフィックスに入るかどうか。
- Gemini CLI と Qwen Code の圧縮、Qwen の inject モード。
- Goose 1.60.2、Aider 0.86.0、Kimi CLI 1.52.0、Cursor CLI、Amp は今回動かしていない。
参考資料
- OpenCode v2.3.2 changelog:https://opencode.ai/changelog/v2.3.2、GitHub release:https://github.com/anomalyco/opencode/releases/tag/v2.3.2 ↩
- OpenCode PR #64542、send the OpenAI system prompt as a developer message:https://github.com/anomalyco/opencode/pull/64542 ↩
- OpenCode PR #64544、send the system prompt as a developer message on every Responses route:https://github.com/anomalyco/opencode/pull/64544 ↩
- OpenAI ドキュメント、Prompt caching:https://developers.openai.com/api/docs/guides/prompt-caching ↩
- OpenAI ドキュメント、Using GPT-6.2:https://developers.openai.com/api/docs/guides/latest-model ↩
- Anthropic ドキュメント、Prompt caching:https://platform.claude.com/docs/en/build-with-claude/prompt-caching ↩
- Google ドキュメント、Gemini API context caching:https://ai.google.dev/gemini-api/docs/caching ↩
- LiteLLM、Cost Update: OpenAI’s GPT-6.2 caching change may increase input costs:https://docs.litellm.ai/blog/gpt-6-2-instructions-caching-incident ↩
- openai/codex issue #62312:https://github.com/openai/codex/issues/62312 ↩
- OpenCode issue #64783:https://github.com/anomalyco/opencode/issues/64783 ↩
- Codex rust-v0.170.0 リリースノート:https://github.com/openai/codex/releases/tag/rust-v0.170.0 ↩
- Codex rust-v0.171.0 リリースノート:https://github.com/openai/codex/releases/tag/rust-v0.171.0 ↩
- Claude Code v2.1.328 〜 v2.1.330 リリースノート:https://github.com/anthropics/claude-code/releases/tag/v2.1.328、https://github.com/anthropics/claude-code/releases/tag/v2.1.330 ↩
- Qwen Code v0.28.3 リリースノート:https://github.com/QwenLM/qwen-code/releases/tag/v0.28.3 ↩
- Goose v1.60.1 リリースノート:https://github.com/block/goose/releases/tag/v1.60.1 ↩