16GB 显存能替 Claude Code 吗:Qwen3.8 本地 coding agent 的显存分档、量化与 harness 接法(2026)
上个月 r/LocalLLM 有个帖子问得很直接:刚买了 RTX 5080,16GB 显存,正在做季度订阅盘点,想退掉 Claude Pro,问有没有本地模型能顶上 Claude Code。[1] 他补了两句很关键的背景:平时主要拿 Claude 当「会回话的小黄鸭」,讨论思路、问实现方向,真正让它动手的只有 CMake 这类搭脚手架的杂活;而且他不打算为了这件事去买 90 级显卡。
这个问题在 Qwen3.8 发布以后变得值得认真回答。Qwen3.8-27B 的模型卡上,SWE-bench Pro 写的是 61.7,评测用的正是 Claude Code harness;同表里 Opus 4.6 Max 是官方公布的 53.4。[2] 随后放出的 Qwen3.8-Flash-Next 是一个 125B 总参、每 token 只激活 6B 的 MoE,论坛上很快有人在 12GB、16GB 的卡上把它跑起来了。[3][4] 但「榜单分数接近」和「能替掉每天用的 coding agent」之间隔着好几层:模型放不放得下、上下文开多大、每次工具调用后要等多久、工具调用会不会悄悄坏掉、harness 接上去以后哪些功能会失灵。
这篇把过去三周读到的模型卡、官方接入文档、几份认真做了对照测试的 GitHub 报告和一批论坛实测帖放在一起,按显存分档讲清楚:什么配置能用、慢在哪、坏在哪,最后给一张决策表和一份「什么时候留在 API」的清单。和站内文章的关系:Agent Harness 模式讲 Claude Code 主循环怎么转,本文讨论的是把这个循环底下的模型换成本地的会发生什么;Pi 1.0是本文会提到的那类精简 harness;订阅额度怎么算见 Claude Code 额度怎么算;按 token 计费的便宜云端模型可以对照 DeepSeek Flash 的成本账;开源权重旗舰的自托管门槛见 Mistral Large 4 与 2026 开源旗舰。
先说清楚证据的成色:模型卡里的分数是厂商自报;论坛帖子是个人在自己机器上测的,硬件、构建版本、量化都不一样,文中会注明是论坛帖或帖主自述,只当量级参考;标「我的估算」的是我按公开参数自己算的。
先说结论:替的是哪一部分
把「替 Claude Code」拆开看,其实是三种很不一样的用法:
| 用法 | 对模型和硬件的要求 | 本地能不能顶上 |
|---|---|---|
| 讨论思路、读代码、写小段脚手架(上面那位帖主的用法) | 上下文 16K–64K 够用,单轮等十几秒能接受 | 16GB 卡跑 27B 的 4bit 量化基本可以 |
| 单个 agent 长会话:读仓库、改代码、跑测试、反复重发上下文 | 上下文 64K–128K 以上,每次工具调用后的首 token 等待要短,工具调用格式必须稳 | 24–32GB 以上才比较舒服;16GB 要靠 MoE 卸载和一堆调参 |
| 多 agent 并行、子任务扇出、长时间无人值守 | 并发、prefix cache、长上下文预填充速度都要够 | 单张消费卡基本不行,要 96GB 级显卡、DGX Spark 或多卡 |
一句话版本:**第一种现在就能替;第二种在 24GB 以上、配置对的前提下能替一大半;第三种还是留在 API,或者做成「云端规划、本地执行」的混合。**下面逐层展开为什么。
两个模型:27B 稠密和 Flash-Next MoE 不是一类东西
Qwen3.8-27B 是稠密模型,27B 参数每个 token 全部参与计算。它的 64 层按「3 层 Gated DeltaNet(一种线性注意力)+1 层门控注意力」重复 16 组,原生上下文 262,144,可外推到 100 万;默认开思考,reasoning_effort 默认是 xhigh,许可证是 Apache 2.0。[2] 模型卡给的编码分数:Terminal Bench 2.1 是 73.0(Opus 4.6 Max 为 78.2),SWE-bench Pro 61.7,DeepSWE 1.1 是 42.2。[2]
Qwen3.8-Flash-Next 是 Qwen 说的「Qwen4 架构的实验预览」:125B 总参、6B 激活,另外还有 51B 的 n-gram 嵌入表和 4B 的 MTP(多 token 预测)头;注意力换成了 Gated DeltaNet 加 Qwen Sparse Attention,专家 512 个、每 token 激活 10 个路由专家加 1 个共享专家。[3] 它的许可证不是 Apache,而是 qwen-community-1.0。分数上 Flash-Next 比 27B 高一截:DeepSWE 1.1 是 58.7 对 42.2,Toolathlon(真实工具调用)73.5 对 67.1,SWE-bench Pro 62.5 对 61.7。[3]
两件事要先放在心里。第一,这些分数是在 Claude Code harness、256K 上下文、temperature 1.0 下测的,[2] 而你在 16GB 卡上跑的往往是 4bit 量化、64K 上下文,条件根本不一样。第二,两个模型吃硬件的方式完全不同:稠密模型每生成一个 token 要把全部权重读一遍,速度基本由显存带宽决定,权重必须尽量待在显存里;MoE 每个 token 只碰一小部分专家,冷门专家可以放到内存甚至 SSD。lukaLLM 的对照测试里,Flash-Next 那张 51B 参数的 n-gram 表放在系统内存时解码 108.5 tok/s,挪进显存反而降到 1.95 tok/s,慢了 55.6 倍——因为这张表是按地址取几行,不做矩阵乘,按作者的解释,放在 GPU 上时解码每一步都要多付一次 CPU 与 GPU 之间的往返开销。[5] 所以「显存小只能跑小模型」这条老经验,在 Flash-Next 这里不成立,它更看内存有多大。
图:稠密模型每个 token 读全部权重;MoE 只激活一小部分专家,冷专家和 n-gram 表可以放进内存。数据来自[3][5]。
社区微调也多:ThinkingCap、Swift 这些版本在论坛里讨论很热,有人提醒 ThinkingCap 的 3.8 版许可证跟之前不一样了;[6] 还有面向 agent 编码的 Qwen3.8-27B-pi(「按投入程度排序的推理」,我只看到发布标题,没看到正文)。[7] 选微调版之前先看许可证,再看它在你自己的 harness 里表现如何,别只看帖子标题。
按显存分档:每一档实际能跑成什么样
27B 的账:权重加 KV cache
Unsloth 的 GGUF 文件大小可以直接拿来算:Q4_K_M 15.33 GiB,IQ4_XS 13.27 GiB,Q3_K_XL 12.24 GiB,Q5_K_M 18.41 GiB,Q6_K 20.47 GiB,Q8_0 27.05 GiB;视觉部分 mmproj 另要约 0.86 GiB。[8]
KV cache 按模型卡结构估(我的估算):只有 16 层门控注意力需要 KV,每层 4 个 KV 头、头维 256,于是 f16 下每 token 约 64 KiB,128K 上下文约 8 GiB;换成 q8_0 约 4.25 GiB,64K 上下文约 2.1 GiB。DeltaNet 层只有固定大小的状态,不随上下文增长。这就是 27B 在长上下文下比传统稠密模型省显存的原因,但对 16GB 卡还是很紧:Q4_K_M 权重本身就 15.33 GiB,没地方放 KV。
图:27B 各档显存账。权重取 Unsloth GGUF 文件大小[8],KV cache 为上文按模型卡结构的估算(q8_0);未计视觉部分(约 0.86 GiB)和运行时开销。
论坛实测基本对得上这笔账:
- 16GB:有人用 IQ4_XS、65K 上下文、q8 KV,关掉 MTP、视觉部分放到 CPU,解码约 30 tok/s,他自己说「能接受,但只是做 harness 活的底线」,还在纠结 Q3 量化安不安全。[9] 另一位 5070 Ti 加 64GB 内存,Q4 在 65K 上下文跑到 33–40 tok/s,用 llama.cpp 和 LM Studio 都上不去 40。[10]
- 24GB(两张 3060):Q4_K_M、50K 上下文,实际使用解码 43–50 tok/s,帖主的结论是「主要问题是上下文太短,撑不住长 agent 会话」。[11]
- 48GB(5090 加 4070 Ti Super):INT8 权重、262K 上下文、FP8 KV,用 vLLM 跑。预填充从 2K 时的 2,922 tok/s 降到 260K 时的 1,596 tok/s,首 token 等待从 0.7 秒涨到 163 秒;后续轮次命中 prefix cache,260K 下首 token 只要 1.3 秒。[12]
- 96GB(RTX PRO 6000):FP8 加 vLLM,几位开发者共用一张卡跑 coding agent,第一周处理了 20 亿 token,每人 60–88 tok/s,KV 峰值占用 38.6%,帖主强调还没摸到瓶颈。[13]
- 还有一个极端例子:矿卡 CMP 170HX(40GB)超频后跑 27B,W4A16 加 FP8 KV、132K 上下文,帖主自述 225 t/s。[14] 只有一个人报、还超了频,当作上限参考就好。
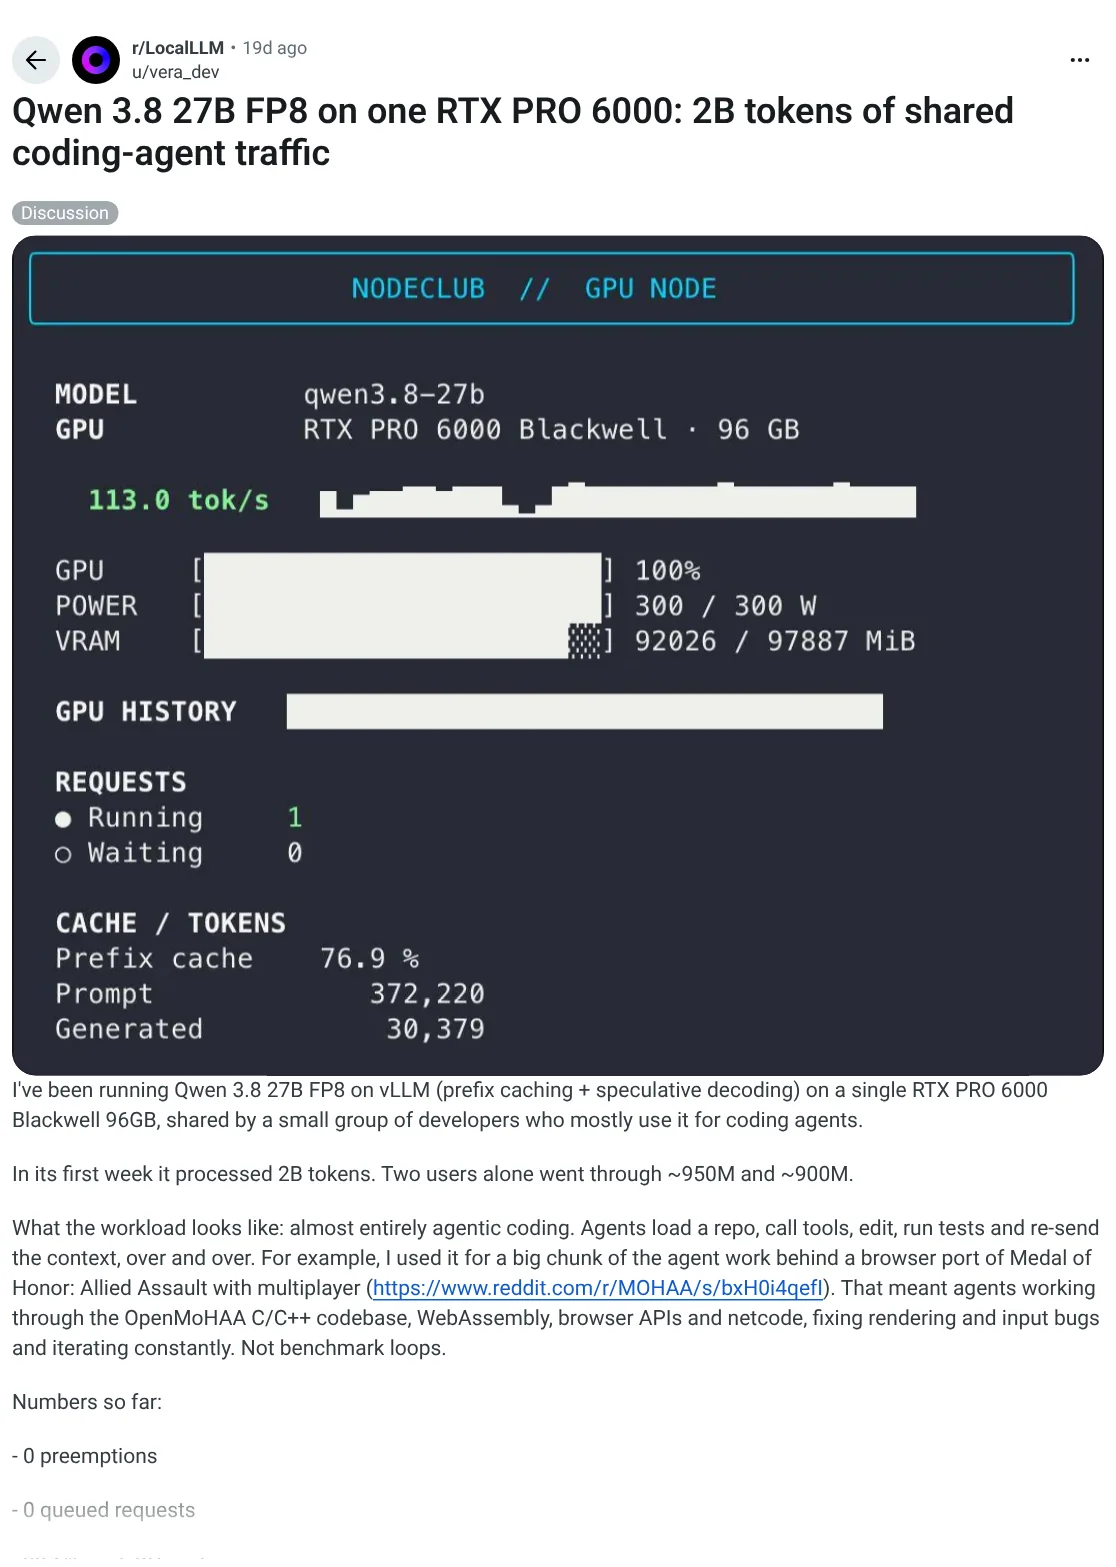
截图:共享 RTX PRO 6000 的帖子,监控面板里 prefix cache 命中 76.9%(r/LocalLLM 原帖,2026-10 截取)[13]
Flash-Next 的账:显卡买速度,内存决定能不能跑
lukaLLM 在一张 96GB RTX PRO 6000 上用软件限制可用显存,模拟不同档位(llama.cpp,UD-IQ4_XS,87.2 GiB 的文件,机器有 91 GiB 可用内存):[5]
| 可用显存 | 放进内存的专家层 | 2K 预填充 tok/s | 2K 解码 tok/s | 长上下文解码 |
|---|---|---|---|---|
| 无 GPU | 全部 | 183 | 8.3 | — |
| 8 GiB | 48/48 | 232 | 35.7 | 最多 16K |
| 16 GiB | 45/48 | 249 | 37.9 | 20.6 @ 123K |
| 24 GiB | 42/48 | 260 | 39.0 | 14.9 @ 245K |
| 32 GiB | 36/48 | 292 | 42.2 | 15.4 @ 245K |
| 48 GiB | 23/48 | 747 | 51.7 | 17.0 @ 245K |
| 96 GiB | 0/48 | 1,955 | 109.1 | 21.6 @ 245K |
他自己写明了局限:限制显存只模拟了容量,没模拟带宽,24GB 那一行会高估真 3090。[5] 但趋势很清楚:从 8GB 到 32GB,解码只从 35.7 涨到 42.2,预填充也没怎么动;真正的跳跃发生在专家能大部分进显存之后。作者的原话是:显卡买的是读提示的速度,内存决定模型能不能跑。他还把内存也限制在 64GB,模拟「4090 加 64GB 内存」这一档,约 34 tok/s。[5]
几份单机实测:
- 16GB(4080 + 64GB 内存):AtomicChat 的 AD-4.27bpw Q4_K_M 量化,加 Unsloth 的共享 MTP 头,自己编译带 MTP 补丁的 llama.cpp 分支,131K 上下文、q8 KV,解码 16.5 tok/s、预填充 350 tok/s。服务时常驻内存 50–55 GB,作者说 64GB 是下限。[15][16]
- 12GB(5070 Ti 笔记本 + 64GB 内存):用专门为这个模型写的 Strata 引擎跑 ISTA-DASLab 的 IQ3_XXS,43K 上下文时 51 t/s,同一个量化在原版 llama.cpp 上只有 23 t/s;占用 11GB 显存、56GB 内存(含系统占用)。帖主也提醒,这个引擎只为这一个模型写,只认 ISTA-DASLab 的几种 GGUF。[4] 项目页写的门槛是 12GB 以上显存、32GB 以上内存。[17]
- 16GB + 32GB 内存 + SSD:InferredThoughts 把 119 GiB 的 NVFP4 模型大部分放在 SSD 上按需读专家,解码 9–10 tok/s,但 5.5K 提示的预填充只有 49.2 tok/s;工具调用作者自己说「还有 bug」,目前只支持 RTX 50 系、只支持贪心解码。[18]
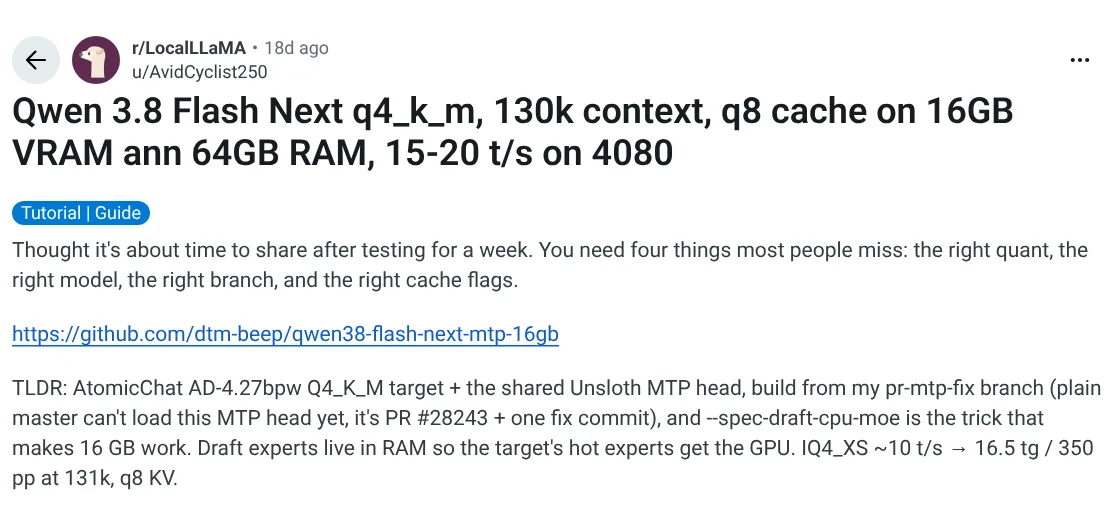
截图:16GB 4080 跑 Flash-Next 的帖子,TLDR 里列出量化、MTP 分支和 —spec-draft-cpu-moe(r/LocalLLaMA 原帖,2026-10 截取)[15]
Apple Silicon 和其它统一内存机器
Mac 的优势是内存大、带宽不低,劣势是软件经常只为新芯片优化。有人把只支持 M3 以上的 Splash 引擎移植到 2021 年的 M1 Max(64GB),27B 4bit 在短提示基准上平均 39 tok/s;但在真实的 opencode 会话里(上下文从 30K 涨到 89K,43 分钟 25 个请求),解码掉到 19–36 tok/s,32K 提示的首 token 要等 290 秒,帖主算下来「约一半时间花在每次工具调用后等第一个 token」,尽管 95% 的提示 token 都命中了 prefix cache。[19] Simon Willison 在 128GB 的 M5 Max 上用 LM Studio 跑 17GB 的 Q4_K_M。[20]
Flash-Next 方面,MoEspresso 在 32GB 的 M1 Max 上靠 IQ2_K 量化和「优先选已在内存里的专家」的偏置跑到 12–15 tok/s,前提是别开浏览器之类吃内存的程序;评论区有人报告速度更低,作者说会再查。[21] 256GB 的 M5 Ultra 上,Flash-Next 预填充约 4,200 tok/s 且基本线性,200K 提示 47.1 秒读完,解码 59–74 tok/s。[22]
AMD Strix Halo 是另一条路:在 160K 上下文下,社区分支 Gufo 跑 Flash-Next 是 1,227 tok/s 预填充、22 tok/s 解码,原版 llama.cpp 只有 113 和 7。[23] 同一台机器换个推理引擎,预填充差出十倍,这一点后面还会反复出现。
DGX Spark
NVIDIA 官方规格:GB10 芯片,128GB LPDDR5x 统一内存,带宽 273 GB/s,FP4 算力最高 1 PFLOP,官方说可推理最大 200B 参数的模型。[24] MiaAI-Lab 的单机方案用 TensorFold 引擎跑 Flash-Next,262K 窗口、FP8 KV,单请求解码 64.4 tok/s,首 token 98 ms,4K–32K 提示的预填充约 2,500–2,600 tok/s,8 路并发合计约 200 tok/s。[25] 但它用的检查点把每 token 专家从 10 个砍到 5 个,作者自己写明通用能力在其测试里低约 10%(46.6–47.6 对 51.8),工具使用没变。[25] 论坛上有人让 Flash-Next 给自己 DGX Spark 上的 harness 写工具(我只取到标题,正文没取到),[26] 这类「本地模型给本地 harness 写配套」的玩法,Spark 这种内存大、能长期开着的机器最合适。
量化和 KV cache:省下来的显存从哪来,代价落在哪
几条在多份报告里互相印证的经验:
- Q4 是默认起点,Q3 及以下要自己验。 dtm 的 16GB 方案说他选的 Q4_K_M 比 IQ4_XS 更快也更好,跟 BF16 比 KL 散度 0.0842、首选 token 一致率 89.5%(作者自测)。[16] lukaLLM 则明说他只比了速度,没测量化后的质量。[5] 3bit 的说法差距更大:有帖子转述 ISTA-DASLab 称其 IQ3_S「在编码基准上恢复了原模型的表现」,这是二手说法。[4]
- KV 用 q8_0 基本安全,别单独把 V 降到 q4_0。 dtm 在 131K 下用 q8_0/q8_0,KV 约 3.2 GB;他专门提醒别为了省显存把 V 设成 q4_0,因为没有对应的 FlashAttention 核,每步解码都会转回 f16。[16] llama.cpp 的
--cache-type-k/--cache-type-v默认都是 f16。[27] - NVFP4 是 Blackwell 的专属红利。 SSD 流式那个引擎就是靠 FP4×FP4 直接在 tensor core 上算,不用先解包;它目前也只支持 RTX 50 系(Blackwell)。[18] DGX Spark 宣传的 1 PFLOP 也是 FP4 口径。[24]
- 砍专家、降激活也是一种量化。 TensorFold 那个 5 专家检查点就是例子:速度换来了,通用能力掉了约一成。[25]
- 投机解码(MTP)要看专家放在哪。 lukaLLM 测到 MTP 只有在专家全在显存时才有 1.61 倍收益,一旦卸载专家反而只剩 0.29–0.38 倍;[5] 但 dtm 换了量化、加上 MTP,并用
--spec-draft-cpu-moe把草稿模型的专家放到内存,在 16GB 上整体从约 10 tok/s 提到 16.5;他的 A/B 里草稿整个放显存反而更慢(15.4 对 16.5)。[16] 两份报告不算矛盾,说明结果取决于构建和草稿放在哪,得在自己机器上测。dtm 给了一条实用判据:草稿接受率低于 0.30 就关掉 MTP。[16] - prefix cache 的上限设错会静默失效。 dtm 发现
--cache-ram必须大于会话的提示状态,否则每次都跳过缓存、日志里只有一行提示;设对以后,每轮重发提示从 150 秒降到约 12 秒。[16]
上下文和吞吐:agent 慢在读提示,不在出字
聊天时看解码速度就够了,coding agent 不行。agent 每调用一次工具,就要把系统提示、仓库上下文和历史重新发一遍,真正决定体感的是预填充速度和 prefix cache 命中率。上面几组数放在一起看就很明显:M1 Max 的会话一半时间在等首 token;[19] 48GB 双卡在 260K 下冷启动首 token 要 163 秒;[12] SSD 流式方案预填充 49.2 tok/s,照这个速度,一个 30K token 的冷上下文要读约 10 分钟(我的算术:30,000 ÷ 49.2 ≈ 610 秒)。[18] 论坛上也有人专门发帖,请大家晒「harness 做压缩以后、冷预填充 128K」的速度,因为几乎没人报这个数。[28]
图:agent 每轮先预填充再解码。上面几组实测首 token 等待,冷启动与命中 prefix cache 差一到两个数量级。
推理强度是另一个暗坑。Qwen3.8 默认 xhigh。Simon Willison 第一次用 LM Studio 跑 27B,就撞上了 LM Studio 默认 8,192 的上下文上限——思考把 token 全用光了;放开到 262,144 以后,一个画图任务用了 22,276 个推理 token、21 分钟,关掉推理只要 137 秒。他的建议是先从 low 或不推理开始。[20] 但反过来也有代价:模型卡写明,多轮 agent 任务里降低推理强度不一定缩短总时间,分析不够会导致更多失败和重试;[2] Simon 另一个实验里,27B 关掉推理做大数加法正确率只有 23.57%,开 medium 推理后 169 题对了 167 题。[29] M5 Ultra 那份测试里,模型也出现过把 8K 预算全花在隐藏推理上、可见输出为零的情况,加到 16K 才答出来。[22]
还有一个反直觉的现场:有人在双 5090 上让 27B 修 bug,5–10 分钟搞定;同一任务给 Flash-Next 用了 2.5 小时,改完代码以后又跑了两个小时测试才停。[30] 单个案例说明不了模型高下,但提醒你:分数更高的模型,配上不合适的推理强度和停止条件,任务总时长可能差一个数量级。
接进 harness:Claude Code、Codex、OpenCode 怎么接
推理引擎这一层,四个常见选择的对外接口差别不小:
| 运行时 | 对外接口 | 要注意的默认值 |
|---|---|---|
llama.cpp llama-server | OpenAI 兼容接口,另有 Anthropic 兼容的 /v1/messages;工具调用要开 --jinja | 官方说不强求与 Anthropic 规范完全兼容;认不出模板时退回通用工具调用格式,更费 token[27][31] |
| LM Studio | /v1/messages 给 Claude Code,/v1/responses 给 Codex,默认端口 1234 | 建议上下文开到约 25K 以上[32][33] |
| Ollama | Anthropic 兼容接口,ollama launch claude 一键拉起 | 显存低于 24 GiB 时默认上下文只有 4K,官方建议 coding 工具至少 64K[34][35] |
| vLLM / SGLang | OpenAI 兼容服务,可开 prefix caching | 模型卡推荐生产和高吞吐场景用它们[2];多人共用一张卡的例子见上文[13] |
Claude Code 走 ANTHROPIC_BASE_URL 指向本地服务,用 ANTHROPIC_AUTH_TOKEN 填一个占位 token。Ollama 和 LM Studio 的文档都给了现成的环境变量写法。[34][32] 但要知道三件事。第一,Anthropic 文档明说不支持通过网关把 Claude Code 路由到非 Claude 模型,[36] 出了问题只能自己查。第二,对认不出的模型 ID,Claude Code 默认按 200K 窗口算,[37] 它要到接近 200K 才主动压缩,而你本地服务端可能在 64K 就开始拒绝请求;应当用 CLAUDE_CODE_MAX_CONTEXT_TOKENS 把真实窗口告诉它。[38] 第三,对陌生 ID 它会照发当前 Claude 模型才有的字段,比如自适应思考和 effort;上游不认 effort 时它会去掉重试,[37] 但别的字段要看你的服务端怎么处理。
Codex 有现成的 --oss 模式,用 oss_provider 选 Ollama 或 LM Studio;没设置时交互模式会问,codex exec 会直接报错。[39] LM Studio 那边走 /v1/responses,可以 codex --oss -m <模型名> 指定模型。[33] 想接 llama.cpp 或 vLLM,就自己写一个 model_providers 条目,填 base_url。[39]
OpenCode 这类第三方 harness 用 @ai-sdk/openai-compatible 配一个本地 provider,记得在 limit.context 里写上真实窗口,让它知道还剩多少上下文。文档里还专门有一句:工具调用不灵时,先把 Ollama 的 num_ctx 调到 16K–32K。[40] 论坛上这类求助很常见,比如有人在 VS Code 的 Roo 插件里接 Ollama 一直不通;[41] 我的建议是先查上下文长度和接口地址。
工具调用会怎么坏:七种常见故障
- 上下文被静默截断。 Ollama 小显存默认 4K、LM Studio 默认 8,192,[35][20] 系统提示加工具定义就塞满了,模型看不到工具说明,于是乱调或不调。
- 聊天模板和解析器不匹配。 llama.cpp 认不出模板时会退回通用格式,[31] 推理内容和工具调用可能混在正文里;不开
--jinja时工具调用直接不可用。[27] - 速度很好看,其实一行代码没写。 lukaLLM 的报告里,有三次早期测试报出 158、98、105 tok/s 的漂亮速度,检查输出才发现模型只吐了工具调用语法,没写任何代码。[5] 所以他的测试会检查有没有「没有执行器的工具调用、空壳回答、截断」。
- 参数类型被改。 TensorFold 专门写了一个
toolcheck.py,检查数组参数回来时还是不是 JSON 数组。[25] 这种检查值得每个本地服务都跑一遍。 - 推理吃掉了输出预算。 xhigh 下推理 token 远多于答案,[20] 预算一紧就出现「只想不答」。[22]
- 新引擎、分支构建本身不稳。 16GB 方案依赖的 MTP 补丁还没进 llama.cpp 主干;[16] SSD 流式引擎自述工具调用有 bug;[18] 论坛上也有人拿 GLM 5.3 Flash 举例,发布一个月后 llama.cpp 主干还不支持,大家只好去用各种分支。[42]
- harness 对窗口的认知和服务端不一致。 就是上面 Claude Code 默认按 200K 算的问题,[37] 表现是会话进行到一半突然报错或丢上下文。
成本:本地什么时候划算
有一组难得的同题对比:同一个一句话需求(一个页面里五个物理场景),帖主所在团队用自家的 Atomic Agent 跑三种配置。[43]
| 配置 | 花费 | 用时 | 做对的场景 |
|---|---|---|---|
| 只用 Sonnet 5.5(云端) | $1.83 | 9 分钟 | 4/5 |
| Sonnet 规划、本地 Qwen 3.8 27B 写代码 | $0.67 | 85 分钟 | 2/5 |
| 只用本地 27B(单张 3090,Q4) | $0 | 26 分钟 | 1/5 |
反过来让 Qwen 规划、Sonnet 写代码,拿到 4/5、14 分钟,但比纯 Sonnet 还贵,因为每个云端 worker 都要重读上下文。[43] 这只是一个任务、一个团队的测试,结论却很典型:本地省的是钱,付出的是时间和一部分质量。
另一个容易被忽略的变化是用法本身。那张共享 RTX PRO 6000 的帖主观察到,不按 token 付费以后,大家不再裁剪上下文、不再提前掐掉跑偏的任务,其中两个人一周分别用掉约 9.5 亿和 9 亿 token。[13] 本地算力是固定成本,摊得越满越划算;但如果你一个月只用几天,硬件钱很难省回来。硬件价格只有论坛报价可参考:有人报 128GB 的 Strix Halo 3,149 美元、加一张 R9700 合计约 5,000 美元;[44] 也有人在欧洲看到两张 64GB 的 CMP 170HX 要 6,000–7,000 美元。[45]
还有一条账单规则跟混合用法有关:Claude Code 走网关并使用网关凭据时,请求不再带订阅登录,订阅额度也不适用;网关后面如果接的是付费上游,就按 token 计费给凭据所有者。[36] 想「复杂活用订阅、简单活走本地」,最好用两个独立配置切换,别混在一个环境里。
真实的长期替换报告也有:有人在 128GB 的 M1 Ultra 上用 opencode 加「Qwen 3.8 Next」(帖主的叫法,应该就是 Flash-Next)替了 Claude 四五天,主要做调研和业务类任务,感觉「没少什么」,但承认没 Claude 快,多 agent 工作流可能还会回云端。[46] 另一位从 35B 换到 Flash-Next 又换回 35B(他在自己的小应用里内嵌了 AI,应用本身就是 harness),结论是在一个小领域、工具受限的场景里,harness 搭对了,小模型也一样能干活。[47] 也有「27B 好到我不再用 API」这样的帖子标题(正文我没取到)。[48]
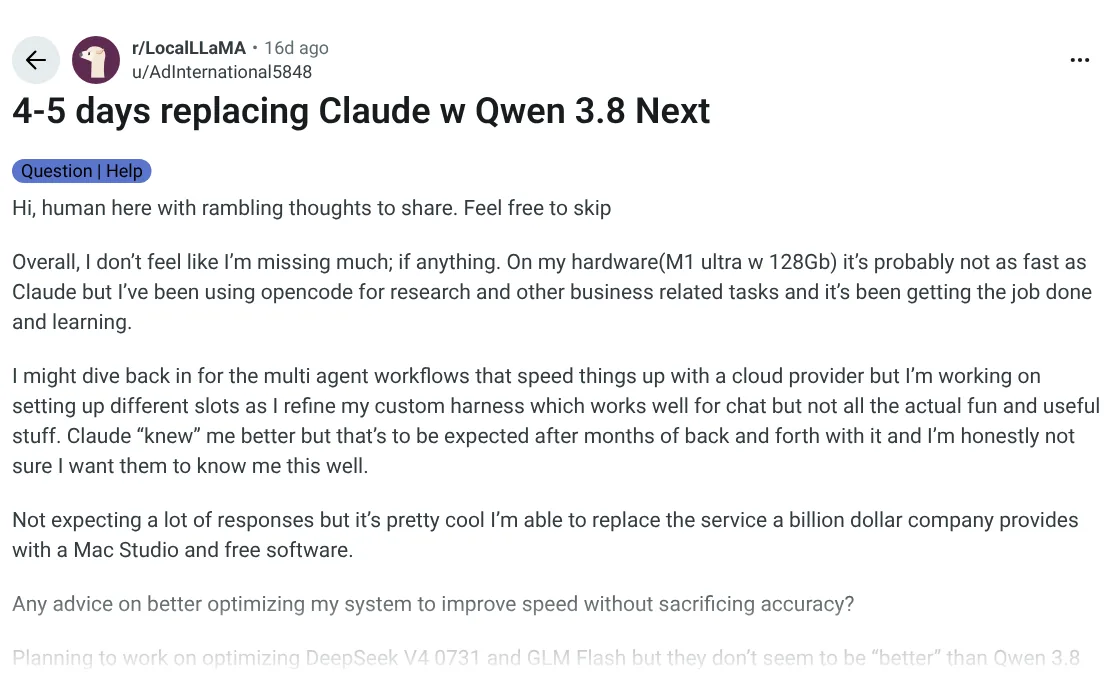
截图:M1 Ultra 128GB 上用 opencode 替 Claude 四五天的帖子(r/LocalLLaMA 原帖,2026-10 截取)[46]
决策表和清单
| 你的情况 | 建议 |
|---|---|
| 16GB 显卡,主要拿来讨论和写小段代码 | 27B IQ4_XS、q8 KV、上下文 32K–64K,推理开 low/medium;订阅可以降档,但先别全退 |
| 12GB 显卡 | 27B 只能用 IQ3_XXS(10.18 GiB)这一级且上下文很短;内存有 64GB 的话,Flash-Next 加专用引擎反而更实际 |
| 16GB 显卡、64GB 以上内存,想跑单 agent 长会话 | 试 Flash-Next 加专家卸载(llama.cpp 分支或 Strata),接受 15–50 tok/s 和较慢的冷预填充 |
| 24–32GB 单卡 | 27B Q4_K_M 加 q8 KV,按我的估算 128K 上下文放得下(Q5 要缩上下文);我的判断是这是目前最省心的组合 |
| 48GB 以上、96GB 卡、DGX Spark、大内存 Mac | 可以认真考虑替掉日常 agent;用 vLLM/SGLang 或专用引擎,打开 prefix cache |
| 多 agent 并行、无人值守长任务、对正确率要求高 | 留在 API,或者云端规划、本地执行,按任务测成本 |
动手前和动手后各过一遍:
- 先写下你真实的用法属于上面三种里的哪一种,别按榜单分数做决定。
- 按「权重 + KV + 视觉部分 + 余量」算显存;MoE 再算一遍内存,内存不够就别碰。
- 把服务端上下文、harness 里声明的窗口(Claude Code 用
CLAUDE_CODE_MAX_CONTEXT_TOKENS,OpenCode 用limit.context)设成同一个数。 - 检查 Ollama/LM Studio 的默认上下文,至少 64K 再接 coding agent。
- llama.cpp 开
--jinja,看日志里聊天格式是不是「Generic」。 - 跑一次工具调用自检:数组参数、多工具、长输出,确认格式没被改。
- 测速时测冷预填充和首 token 等待,别只看解码 tok/s;同时检查输出里是否真有代码。
- 推理强度从 low/medium 起步,在你的任务上比较「总完成时间」而不是单轮时间。
- 开 MTP 前后各记一次接受率,低于 0.30 就关。
- 量化低于 4bit 时,用自己仓库里的几个真实任务做回归,别只信别人的基准。
- 保留一个云端出口:碰到多文件重构、陌生代码库、需要并行子任务时切回去。
结论
回到开头那位 16GB 帖主:他的用法正好落在本地已经能顶上的那一类,27B 的 4bit 量化加 32K–64K 上下文就够用,订阅可以先降档观察一个月。真正难替的是长会话、多 agent 和无人值守的那部分,瓶颈不在模型分数,而在预填充速度、上下文长度和工具调用的稳定性,这三样都和硬件、引擎、harness 配置绑在一起。Flash-Next 这类「专家放内存」的架构把门槛从显存挪到了内存,这是今年本地 coding agent 最大的变化;但它对引擎的依赖也更重,同一台机器换个引擎能差出十倍。在这件事上,与其问「哪个模型最强」,不如先问「我的哪一类任务,在我的机器上,冷启动要等多久、工具调用错几次」。
参考来源
- r/LocalLLM,u/Crastinating_Pro,《Are there any models that I can use with a 16GB GPU that might be able to replace claude code?》(论坛帖):https://www.reddit.com/r/LocalLLM/comments/1woikg7/are_there_any_models_that_i_can_use_with_a_16gb/ ↩
- Qwen,Qwen3.8-27B 模型卡(Hugging Face):https://huggingface.co/Qwen/Qwen3.8-27B ↩
- Qwen,Qwen3.8-Flash-Next 模型卡(Hugging Face):https://huggingface.co/Qwen/Qwen3.8-Flash-Next ↩
- r/LocalLLaMA,u/MLDataScientist,《Qwen3.8 flash next ISTA-DASLab GGUF 50t/s TG and 1500t/s PP with 12GB VRAM and 64GB RAM Laptop on ‘Strata’ engine》(论坛帖):https://www.reddit.com/r/LocalLLaMA/comments/1wtv43r/qwen38_flash_next_istadaslab_gguf_50ts_tg_and/ ↩
- lukaLLM,Qwen3.8-Flash-Next-VRAM-Benchmark,README(RTX PRO 6000 上的分档与引擎对照报告):https://github.com/lukaLLM/Qwen3.8-Flash-Next-VRAM-Benchmark ↩
- r/LocalLLM,u/newtonapple,《ThinkingCap Qwen3.8-27B has been released》(论坛帖):https://www.reddit.com/r/LocalLLM/comments/1wolg9w/thinkingcap_qwen3827b_has_been_released/ ↩
- r/LocalLLaMA,u/paf1138,《Qwen3.8-27B-pi: Effort-Ordered Reasoning for Agentic Coding》(论坛帖,仅标题):https://www.reddit.com/r/LocalLLaMA/comments/1wufzrh/qwen3827bpi_effortordered_reasoning_for_agentic/ ↩
- Unsloth,Qwen3.8-27B-GGUF 文件列表(Hugging Face):https://huggingface.co/unsloth/Qwen3.8-27B-GGUF ↩
- r/LocalLLaMA,u/Adventurous-Gold6413,《Which of the 16gb VRAM qwen3.8 27b’s is the best?》(论坛帖):https://www.reddit.com/r/LocalLLaMA/comments/1wrgk8z/which_of_the_16gb_vram_qwen38_27bs_is_the_best/ ↩
- r/LocalLLM,u/Tight_Commercial7,《5070 ti + 64 ram Qwen 3.8 27b》(论坛帖):https://www.reddit.com/r/LocalLLM/comments/1woatkk/5070_ti_64_ram_qwen_38_27b/ ↩
- r/LocalLLaMA,u/jacek2023,《Qwen3.8-27B Q4_K_M on 2x3060》(论坛帖):https://www.reddit.com/r/LocalLLaMA/comments/1wqjr3f/qwen3827b_q4_k_m_on_2x3060/ ↩
- r/LocalLLaMA,u/Fz1zz,《Qwen3.8-27B FP8 dual GPUs》(论坛帖):https://www.reddit.com/r/LocalLLaMA/comments/1wrhmdn/qwen3827b_fp8_dual_gpus/ ↩
- r/LocalLLM,u/vera_dev,《Qwen 3.8 27B FP8 on one RTX PRO 6000: 2B tokens of shared coding-agent traffic》(论坛帖):https://www.reddit.com/r/LocalLLM/comments/1wo5552/qwen_38_27b_fp8_on_one_rtx_pro_6000_2b_tokens_of/ ↩
- r/LocalLLM,u/Feralzi,《Qwen 3.8 27B reaching 225 t/s on 132k context on CMP 170HX》(论坛帖):https://www.reddit.com/r/LocalLLM/comments/1wojbs4/qwen_38_27b_reaching_225_ts_on_132k_context_on/ ↩
- r/LocalLLaMA,u/AvidCyclist250,《Qwen 3.8 Flash Next q4_k_m, 130k context, q8 cache on 16GB VRAM and 64GB RAM, 15-20 t/s on 4080》(论坛帖):https://www.reddit.com/r/LocalLLaMA/comments/1wom3fe/qwen_38_flash_next_q4_k_m_130k_context_q8_cache/ ↩
- dtm-beep,qwen38-flash-next-mtp-16gb,README:https://github.com/dtm-beep/qwen38-flash-next-mtp-16gb ↩
- Niko1221,Strata,README:https://github.com/Niko1221/Strata ↩
- r/LocalLLaMA,u/TypicalPudding6190,《Qwen3.8-Flash-Next 177B NVFP4(119GiB): SSD streaming at 9-10 tok/s on one 16 GB RTX 5060 Ti + 32 GB RAM》(论坛帖):https://www.reddit.com/r/LocalLLaMA/comments/1wrxap8/qwen38flashnext_177b_nvfp4119gib_ssd_streaming_at/ ↩
- r/LocalLLM,u/Erp4759,《You can now run Qwen3.8-27B on a 2021 M1 Max at 39 tok/s》(论坛帖):https://www.reddit.com/r/LocalLLM/comments/1woq7cd/you_can_now_run_qwen3827b_on_a_2021_m1_max_at_39/ ↩
- Simon Willison,《Qwen 3.8 27B is excellent, but it defaults to wildly overthinking things》:https://simonwillison.net/2026/Aug/16/qwen-38-27b/ ↩
- r/LocalLLaMA,u/marcobaldo,《Qwen3.8-Flash-Next (125B) at 12-15 tok/s on a 2021 32GB M1 Max》(论坛帖):https://www.reddit.com/r/LocalLLaMA/comments/1wrqql8/qwen38flashnext_125b_at_1215_toks_on_a_2021_32gb/ ↩
- r/LocalLLaMA,u/nonlinearsystems,《M5 Ultra - Qwen3.8 Flash Next vs Laguna S 2.1》(论坛帖):https://www.reddit.com/r/LocalLLaMA/comments/1wugx2e/m5_ultra_qwen38_flash_next_vs_laguna_s_21/ ↩
- r/LocalLLaMA,u/fallingdowndizzyvr,《What runs Qwen 3.8 Flash Next faster? Strix Halo or a Pile of GPUs》(论坛帖):https://www.reddit.com/r/LocalLLaMA/comments/1wufk3y/what_runs_qwen_38_flash_next_faster_strix_halo_or/ ↩
- NVIDIA,DGX Spark 产品页与规格:https://www.nvidia.com/en-us/products/workstations/dgx-spark/ ↩
- MiaAI-Lab,Qwen3.8-Flash-Next-Single-DGX-Spark-TensorFold,README:https://github.com/MiaAI-Lab/Qwen3.8-Flash-Next-Single-DGX-Spark-TensorFold ↩
- r/LocalLLM,《I let Qwen3.8-Flash-Next write all of code for a tool that i plan to use in my harness on a DGX Spark》(论坛帖,仅标题):https://www.reddit.com/r/LocalLLM/comments/1wnwmkm/i_let_qwen38flashnext_write_all_of_code_for_a/ ↩
- ggml-org/llama.cpp,llama-server README:https://github.com/ggml-org/llama.cpp/blob/master/tools/server/README.md ↩
- r/LocalLLaMA,u/Express_Quail_1493,《Qwen3.8FlashNext Please Share Cold prefill at compaction 128k》(论坛帖):https://www.reddit.com/r/LocalLLaMA/comments/1wrul9r/qwen38flashnext_please_share_cold_prefill_at/ ↩
- Simon Willison,《Qwen3.8 27B addition in words》:https://simonwillison.net/2026/Oct/4/qwen38-addition-in-words/ ↩
- r/LocalLLaMA,u/poofph,《Qwen 3.8 27B vs Qwen 3.8 Flash Next and time to complete a coding task.》(论坛帖):https://www.reddit.com/r/LocalLLaMA/comments/1wrs2ii/qwen_38_27b_vs_qwen_38_flash_next_and_time_to/ ↩
- ggml-org/llama.cpp,Function Calling 文档:https://github.com/ggml-org/llama.cpp/blob/master/docs/function-calling.md ↩
- LM Studio 文档,Claude Code 集成:https://lmstudio.ai/docs/integrations/claude-code ↩
- LM Studio 文档,Codex 集成:https://lmstudio.ai/docs/integrations/codex ↩
- Ollama 文档,Claude Code 集成:https://docs.ollama.com/integrations/claude-code ↩
- Ollama 文档,Context length:https://docs.ollama.com/context-length ↩
- Claude Code 文档,Other LLM gateways:https://code.claude.com/docs/en/llm-gateway ↩
- Claude Code 文档,Gateway compatibility guide:https://code.claude.com/docs/en/llm-gateway-protocol ↩
- Claude Code 文档,Model configuration(Correct the window for a gateway or custom model ID):https://code.claude.com/docs/en/model-config ↩
- OpenAI Codex 文档,Advanced configuration(OSS mode、model providers):https://developers.openai.com/codex/config-advanced ↩
- OpenCode 文档,Providers:https://opencode.ai/docs/providers/ ↩
- r/LocalLLM,u/papayax999,《Having trouble getting ollama to connect with my roo on visual code》(论坛帖):https://www.reddit.com/r/LocalLLM/comments/1wosld4/having_trouble_getting_ollama_to_connect_with_my/ ↩
- r/LocalLLaMA,u/silenceimpaired,《Llama.cpp and new model releases …or why Great is the enemy of Good in the LLM world》(论坛帖):https://www.reddit.com/r/LocalLLaMA/comments/1wrj2r5/llamacpp_and_new_model_releases_or_why_great_is/ ↩
- r/ClaudeAI,u/GapNew4766,《Sonnet 5.5 orchestrated a local Qwen 3.8 27B!》(论坛帖,作者团队开发 Atomic Agent):https://www.reddit.com/r/ClaudeAI/comments/1wswkeq/sonnet_55_orchestrated_a_local_qwen_38_27b/ ↩
- r/LocalLLaMA,u/darklordfireape,《Update: Strix Halo + R9700 with llama-halo-hybrid - now beats DGX Spark》(论坛帖):https://www.reddit.com/r/LocalLLaMA/comments/1wuet5g/update_strix_halo_r9700_with_llamahalohybrid_now/ ↩
- r/LocalLLaMA,u/eribob,《Worth going from Qwen3.8 27B to flash next or maaybe deepseek v4 flash?》(论坛帖):https://www.reddit.com/r/LocalLLaMA/comments/1wrkle9/worth_going_from_qwen38_27b_to_flash_next_or/ ↩
- r/LocalLLaMA,u/AdInternational5848,《4-5 days replacing Claude w Qwen 3.8 Next》(论坛帖):https://www.reddit.com/r/LocalLLaMA/comments/1wq7e74/45_days_replacing_claude_w_qwen_38_next/ ↩
- r/LocalLLM,u/eightone-81,《Full circle from 35b to flash next and back to 35》(论坛帖):https://www.reddit.com/r/LocalLLM/comments/1wou38l/full_circle_from_35b_to_flash_next_and_back_to_35/ ↩
- r/LocalLLaMA,《Qwen-3.8-27B is good enough that I stopped using API》(论坛帖,仅标题):https://www.reddit.com/r/LocalLLaMA/comments/1wp0z3i/qwen3827b_is_good_enough_that_i_stopped_using_api/ ↩