Chatbot Arena 为什么会把「新版打赢旧版」算得太保守:Luce 公理、近亲模型与 Bradley–Terry 排名偏差
每次有实验室发新版本,社交媒体上总会出现同一类截图:新版在 LMArena 上比旧版高了多少分,换算成胜率是多少。大家默认这个胜率是榜单「算出来」的可靠数字。一篇十月中旬挂上 arXiv 的论文说,这个数字恰好是榜单最不擅长的那一类:同一家族的近亲模型之间,实际投票比分数暗示的更一边倒,而榜单会把它们的对决胜率系统性地往五五开压。[1]
我读完的判断是:总排名你可以照旧看,但「新版打赢旧版」这种说法要自己打个折扣,而且折扣的方向是反直觉的。榜单不是高估了新版,是低估了近亲之间的差距。更值得注意的是,同一个「一个模型一个分」的假设也坐在大多数奖励模型底下,论文对这一点只提出了假设,没有给出证据,这个边界后面会讲清楚。
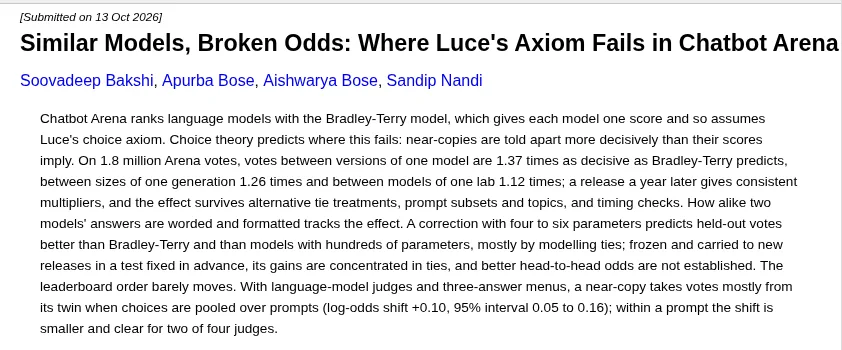
截图:论文摘要页,2026-10-13 提交(arXiv,2026-10-19 截取)[1]
一个分数背后藏着一条很强的承诺
Chatbot Arena 的做法大家都熟:用户提一个问题,两个匿名模型各答一份,用户投票选更好的,也可以选平局或者「都不好」。[2] 榜单把这些两两对决喂给 Bradley–Terry 模型(下文简称 BT),给每个模型估一个分数,模型 i 赢模型 j 的对数几率就是两人分数之差。[2]
一个模型只有一个分数,这件事本身就是承诺。A 常赢 B、B 常赢 C,那么 A 赢 C 的几率已经被前两组分数决定了,哪怕 A 和 C 从来没碰过面。论文把这叫「乘积规则」:对数几率沿着任意一条链可以相加。它是 Luce 选择公理在两两比较上的样子。[1]
选择理论在六十多年前就知道这条公理会在哪里断。经典反例是两份几乎一样的唱片录音,后来被改写成「红巴士和蓝巴士」:两个几乎相同的选项,人只会盯着它们不同的那几个细节比,于是更好的那个赢得比它的整体吸引力暗示的更频繁;而它们任何一个对上完全不同类型的选项,就变成口味问题了。[1] 近亲之间分得更清楚,一个选项一个分数装不下这件事。
语言模型恰好成群结队地出现:同一模型的不同日期版本,同一代的不同尺寸,同一实验室的前后几代。这些正是实验室发版时最关心的对比,也正是经典理论说「一个分数」会失效的地方。论文要测的就是它到底失没失效。
机制:在分差前面乘一个「果断系数」
作者的改动很小。原来的 BT 是对数几率等于分差;现在在分差前面乘一个系数 k,k 只取决于这对模型是什么关系:同一模型不同版本、同代不同尺寸、同实验室、或者无关。无关模型作为基准,k 固定为 1。k 大于 1,说明这对模型之间的投票比分差暗示的更一边倒。[1]
这里有一个容易误读的地方:k 乘的是对数几率,不是概率。k 等于 1.37 时,BT 预测的 55% 会变成大约 57%,70% 会变成大约 76%。[1] 所以这不是「近亲对决胜率被低估了三成多」,而是分差越大,修正量越大,在接近五五开的地方修正很小。
图:按模型关系拆开的果断系数与 95% 区间(数字来自论文第 5 节,2024 年对战日志,弃平局,每对至少 50 张非平局票)[1]
为什么近亲会更果断?论文给了一个 Thurstone 式的读法:如果每个模型的「效用」是分数加噪声,两个模型的噪声相关度越高,它们差值的方差就越小,同样的分差就会转换成更确定的胜负。[1] 近亲共享训练数据和调优流程,大部分小毛病是一样的,比较只落在少数不同的细节上。如果假设无关模型之间噪声不相关,1.37、1.26、1.12 对应的噪声相关度是 0.47、0.37 和 0.20;考虑到无关模型其实也共享很多东西,作者把基准相关度设成 0.3 再算一遍,得到 0.63、0.56 和 0.44。[1] 这些都是下限,不是精确测量。
还有一个结构上的好处。论文指出,当一个菜单里只有同一个「巢」里的两个选项时,嵌套 logit 恰好退化成这个乘了 k 的 BT,k 是最小共同巢的不相似度的倒数。[1] 于是三类关系的系数应该满足一个顺序:版本 ≥ 尺寸 ≥ 实验室 ≥ 1。实测结果正好落在这个顺序上,这比单纯「三个数都大于 1」更有说服力。
证据有多硬:分开看哪部分站得住
我把论文的证据分成三层看,因为它们强弱差别很大。
第一层,近亲更果断这件事本身,证据扎实。 主数据是截至 2024 年 8 月的公开 Arena 对战日志:1,799,991 张匿名票,129 个模型,时间跨度 2023 年 4 月到 2024 年 8 月。[1] 在每对至少 50 张非平局票的 2,650 对、114 万张票上,似然比统计量对 BT 是 177.6(3 个自由度)。按整个模型家族重抽样,版本对的区间是 1.20 到 1.76;任意去掉一个家族,三个系数分别落在 1.34–1.43、1.22–1.29、1.04–1.15。[1] 投票相对二项分布有过度离散(每自由度 Pearson 卡方 1.71),除掉这个因子以后似然比还有 104。[1]
更让我信服的是「无模型检查」。对每对至少有三个共同对手的模型,作者拿两人的直接对决对数几率,和通过共同对手间接推出来的对数几率比。两者用的是不相交的票。如果 BT 成立,直接对间接的斜率应该是 1。无关模型的斜率是 0.99,同实验室 1.10,同代尺寸 1.23,同模型版本 1.28。[1] 这个检查不依赖作者的参数化,结论方向一样。论文还给了一个具体例子:按分数,yi-large-preview 对 yi-large 应该有 55% 的胜率,但在 229 张分出胜负的直接对决里它赢了 65%。[1]
稳健性检查也做得很全,我挑几个值得记住的:按周给每个模型单独估分,系数是 1.36、1.23、1.13;去掉每个模型上线后的前四周,版本效应反而变大到 1.64;在 14 天内先后上线的无关模型对作为安慰剂,系数是 0.99。[1] 这几条基本排除了「新模型上线初期集中和前代对打」造成的假象。
第二层,平局怎么算会改变结论的大小。 近亲不光更果断,也更常平局:版本对 44% 的票是平局,尺寸对 43%,无关对 35%。[1] 论文的说法是近亲要么被判平局,要么被判得很果断。这带来一个实际问题:Arena 自己的惯例是把平局算半场胜,用这个规则重算,系数降到 1.19、1.10、1.06;用 Davidson 模型保留所有平局,是 1.21、1.23、1.13。[1] 尺寸和实验室效应在各种平局规则下都稳,版本效应随规则变化比较大。所以如果有人跟你说「近亲胜率要乘 1.37」,你得追问一句平局是怎么处理的。
第三层,修正能不能搬到新数据上,目前没有定论。 作者做了一个事先承诺的迁移测试:在 2024 年日志上学到修正,冻结,搬到 2025 年的新版本上预测近亲对决。主要指标是胜率对数损失的增益,结果是 +0.14 毫奈特(区间 -2.92 到 +1.68),三结果损失增益 +9.7(区间 -0.5 到 +19.3),都包含零,测试结论是「不确定」。[1] 冻结的系数还往往矫正过头,校准斜率掉到 0.88 到 0.95。[1] 作者在附录里花了很大篇幅诊断原因,结论是估分噪声基本可以排除,联合估计和版本间的变化各贡献一点,但都没到显著。
我对这一层的看法是:作者很诚实地把它标成了没成立,读者也应该照这个口径用。「近亲被低估」是观察到的事实;「拿一组固定系数去修正未来的榜单」现在还不能做。
总排名几乎不动,偏差落在你最关心的那个数上
这是整篇论文里最有用的一个结论,也最容易被标题党忽略。
图:修正对整张榜单和对近亲胜率的不同影响(数字来自论文第 5、6.1、8 节)[1]
在 2024 年日志上,用关系修正重新估分,和原始分数的秩相关是 0.9999,模型平均移动 2.2 个 Elo 点,最多移动 8 点;按 Arena 的名次口径最多变 3 位,没有任何一对近亲调换顺序。原因很简单:大约 89% 的票发生在无关模型之间,近亲对决在总票数里只是一小块。[1] 2025 年的数据用相似度修正,个别模型会移动最多 21 个 Elo 点,移得最多的是那些回答风格和谁都不像的模型。[1]
但近亲之间的对决几率是另一回事。在 2024 年留出票上,BT 给出的近亲胜率在对数几率尺度上比实际「太接近五五开」约 9%;如果只用无关模型之间的票来估分,偏差是 3% 到 11%。[1] 作者的原话是,这些正是实验室在问「新版本是否打赢旧版本」时会读的数字。
所以读榜的时候,我会把两类问题分开:「现在最强的是哪几个」照旧看总榜;「某家新版比旧版强多少」不要直接拿榜单分差换算胜率,那个换算会把真实差距说小。方向上,新版更强时它实际赢得更多,新版更弱时它实际输得更多。
回答长得像,才是更直接的解释
论文第 5.2 节做了一件我觉得很聪明的事:不用家族标签,直接测两个模型回答之间的相似度,看它能不能预测果断程度。相似度分几种:措辞(TF-IDF 余弦)、语义(句向量余弦)、格式(标题、列表、加粗、代码块、表格、段落、表情和长度这些计数之间的距离),以及长度差。[1]
近亲确实写得像:在措辞相似度上,版本对比平均水平高 2.4 到 3.0 个标准差,尺寸对 1.5 到 1.7,同实验室 0.8 到 0.9;措辞越像的对,平局也越多(相关 0.36 到 0.43)。[1] 在 2025 年的 140k 数据上,单靠措辞相似度就能预测果断程度,每个标准差 ×1.12,似然比 66.9,加上家族标签以后只多 0.8,家族标签几乎没剩下什么可说的。语义相似度的预测力弱得多,读完整回答也不比只读开头强。[1]
2024 年的 100k 数据结论不同:格式是最好的单一指标,列表结构贡献最大,家族标签在任何文本指标之上都还有额外信息。[1] 两份数据在「表面相似度能不能完全解释家族效应」上意见不一,但在排序上一致:表面相似比语义相似更能预测果断程度。作者也明确说,这是相关,不是因果,相似度更像一个被部分测到的中介变量。
这一节让我重新想了一下 LMArena 自己的风格控制。2024 年 8 月,LMSYS 在 BT 回归里加了回答长度、标题数、加粗数、列表数四个风格特征,发现长度是主导因素,加了控制以后 GPT-4o-mini 和 Grok-2-mini 掉到大多数前沿模型后面,Claude 3.5 Sonnet、Opus 和 Llama-3.1-405B 上升明显。[3]
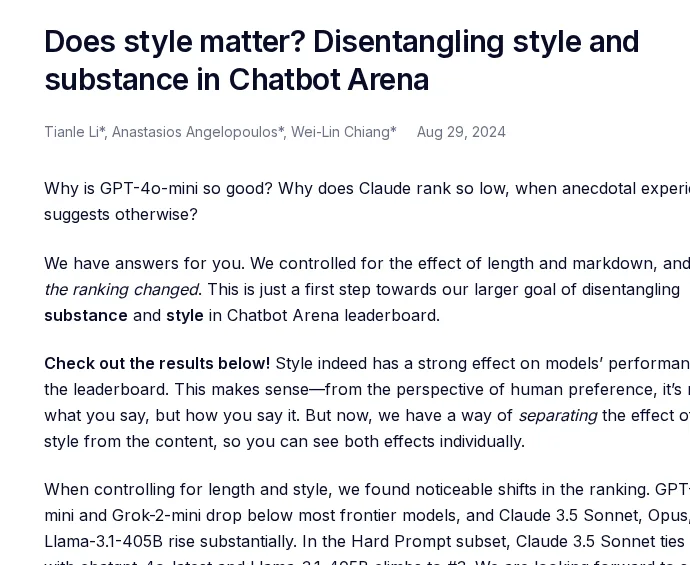
截图:LMSYS 风格控制博客开头(2024-08-29 发布,2026-10-19 截取)[3]
两者看着都在处理「格式」,作用的位置不一样。风格控制是给每场对决加一个平移项:长的一方多拿一点分,从模型分数里扣出来。新论文的修正是改尺度:两个回答越像,同样的分差转换成越确定的胜负。[1] 论文自己也点了这个区别。风格控制解决的是「用户偏爱长回答」,修正不了「近亲对决的胜率被压向五五开」,反过来也一样。如果你在自建评测里只做了长度控制,近亲问题还在。
和「排行榜幻觉」放在一起读
去年 Cohere Labs 等机构的《The Leaderboard Illusion》从另一个角度批评 Arena:少数提供方可以私下测试很多变体,只公布最好的分数;专有模型被抽样的次数更多,被下架的更少;他们统计到 Meta 在 Llama 4 发布前一个月私测了 27 个变体。[4] 用两个完全相同的 Aya-Vision-8B 检查点提交,最后分数是 1052 和 1069,中间夹了 4 个模型。[4]
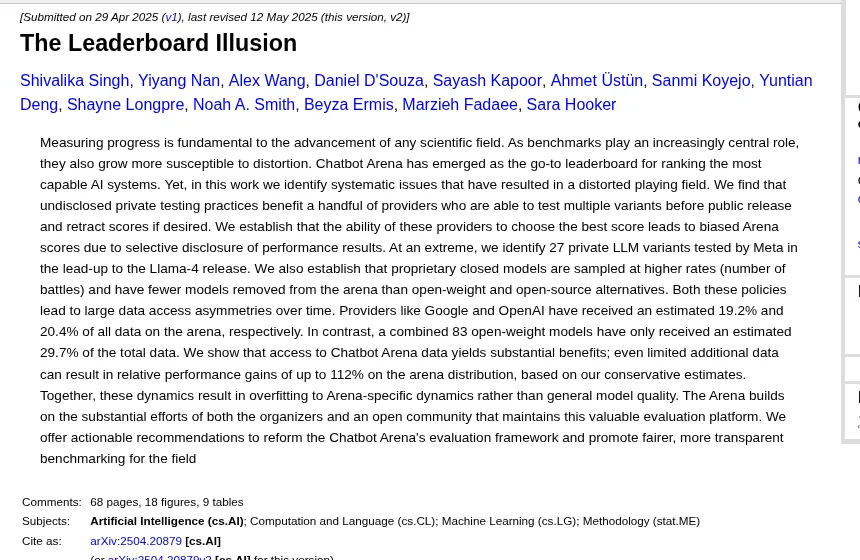
截图:《The Leaderboard Illusion》摘要页(arXiv,v2 2025-05-12,2026-10-19 截取)[4]
这两篇讲的是不同的病。排行榜幻觉讲的是抽样和披露:谁上场、上场多少次、谁的成绩能撤回,这些都会让 BT 的无偏抽样假设失效。[4] 新论文讲的是模型本身的形式:就算抽样完全公平,一个模型一个分数也装不下近亲之间的结构。[1] 新论文专门检查了上线期的抽样会不会造成它看到的效应,结论是没有迹象。[1]
我觉得把两篇连起来读有一个很实际的推论。私测多个变体再挑最好的,这些变体彼此恰好是最近的近亲。按新论文的结论,它们之间的对决会特别果断,两个几乎一样的检查点也能拉开差距;按排行榜幻觉的结论,挑最大值本身就会把分数往上推。两件事叠在一起,「最好的那个私测变体」既容易被挑出来,又容易被高估。这个推论两篇论文都没有直接测,算是我自己的读法。
三选一的实验:红巴士在模型裁判身上出现了一半
Arena 永远只给两个回答,所以它的数据测不了 Luce 公理最核心的那句话:选项之间的几率不受菜单上其他选项影响。作者用语言模型当裁判,自己控制菜单。[1]
图:三答案菜单实验的设计与结果(数字来自论文第 7 节和附录 H)[1]
设计是这样的:八个便宜模型回答 200 条随机抽取的英文 Arena 提示,组成两对版本(Llama 3.1/3.3 70B、Mistral Small 3.1/3.2)和两对尺寸(Llama 3.1 8B/70B、Qwen3 14B/32B)。四个来自不同实验室的裁判(Claude Haiku 5.5、GPT-4.1 nano、Gemini 2.5 Flash-Lite、DeepSeek V3.2)看提示和两到三个匿名回答,回复一个字母,总共 138,400 次判断。[1] 关键比较是:菜单里放 S₁、它的近亲 S₂ 和外人 T,对比把 S₂ 换成第三家实验室的 U,外人对 S₁ 的几率变了多少。Luce 公理说不该变。
跨提示汇总时,四个裁判平均变化 +0.10(区间 0.05 到 0.16),64 个设计里 51 个大于零:加进一个近亲,票主要从它的双胞胎那里流走。[1] 但在同一个提示内部比较,变化只有 +0.03(区间 -0.03 到 0.09),只有 GPT-4.1 nano 和 DeepSeek V3.2 各 +0.12 显著。[1] 作者的解释是,近亲在同样的提示上一起强、一起弱(跨提示胜率相关 0.35、0.27、0.25,无关对 0.09),汇总时提示之间的异质性贡献了一部分效应。人类数据上,PRISM 里只有 Claude 2.0/2.1 这一对显示出明显的红巴士效应。[1]
所以这一节我只记一个结论:多答案评测不能简单把「选中率」当成 Luce 意义上的强度,至少汇总层面会被近亲稀释。至于单个裁判在单个提示上是不是真的违反 Luce,证据只有一半。
奖励模型那一段,要按假设来读
论文讨论部分把话题引到 RLHF:大多数奖励模型用的也是 BT 似然,偏好对里经常是同一个策略的两次采样,这是最近的近亲。如果近亲效应在那里也成立,DPO 用一个统一的 β 去拟合偏好对,在这类对上学到的奖励差会大 k 倍,一个按相似度缩放的 β 能把它们放回同一个尺度。[1]
这是个很有意思的想法,但作者在引言和讨论里都说得很清楚:Arena 是跨提示给一个模型打分,奖励模型是给定提示给一个回答打分,Arena 的证据不能证明奖励模型里的单一温度设错了,他们只把它当作假设。[1] 我会按同样的口径用:值得在自己的偏好数据上做一次检查,但不要据此去改训练配方。
在自己的数据上复现无模型检查
如果你维护着一个内部的两两评测(很多团队用它挑提示词版本、挑微调检查点),这篇论文里最值得照搬的不是修正模型,而是那个无模型检查,因为它不需要你相信任何参数化。做法是:
- 先给每对模型打上关系标签,在看任何投票之前就定下来。比如同一检查点的不同步数算「版本」,同一配方的不同尺寸算「尺寸」,其他算「无关」。
- 对每对至少有三个共同对手的模型,算直接对决的对数几率,再用共同对手间接推一个对数几率,按方差倒数加权平均。两者用的票不要重叠。[1]
- 按关系分组,做直接对间接的过原点回归。无关组的斜率应该接近 1;如果你的近亲组明显大于 1,说明你的榜单也在把近亲差距说小。
论文提醒过一个陷阱:近亲往往分差更小,而在分差很小的那一段,即使无关模型的斜率也略高于 1(最接近的五分之一里是 1.08)。所以比较之前,要把无关组按近亲组的分差分布重新加权,作者这样做以后无关组回到 0.98 到 1.00。[1] 不做这一步,你会把「分差小」误读成「关系近」。
读榜和自建评测,可以直接拿走的做法
把这篇论文压成可以执行的几条:
- 看总榜照旧。 修正对整体排序影响极小,前几名是谁不会因为这篇论文改变。[1]
- 读「新版比旧版强多少」时,别用分差换算胜率。 榜单会把近亲差距说小;如果手边有两版之间的直接对决票,优先看直接对决,并问清平局怎么算。
- 自建两两评测时,把平局单独建模。 论文的修正里大部分增益来自平局项,近亲平局率明显更高,把平局算半场胜会同时抹掉果断度和平局率两个信号。[1]
- 记录回答相似度。 措辞相似度是最便宜、预测力最强的协变量;在 140k 数据上它几乎吸收了家族标签的作用。[1] 140k 数据集本身就带了长度和 markdown 计数这些风格元数据,可以直接拿来做实验。[5]
- 风格控制和尺度修正不是一回事。 长度控制改的是平移,近亲问题改的是尺度,两个都要考虑。[3][1]
- 固定系数不要搬到新榜单上直接用。 冻结迁移测试没有成立,校准还会矫正过头;每次用新数据重新估。[1]
站内之前写过 agent 评测为什么多加任务修不好排行榜,那篇讲的是任务层面的噪声;Mercor 劳动指数讲的是基准覆盖面和真实工作的距离;CheatBench讲的是被测对象自己去钻空子。这篇补的是另一块:就算题目、覆盖面、被测对象都没问题,聚合打分的统计模型本身也会在特定的地方失真,而那个地方正好是发版公告最爱引用的数字。
参考来源
- Soovadeep Bakshi, Apurba Bose, Aishwarya Bose, Sandip Nandi,《Similar Models, Broken Odds: Where Luce’s Axiom Fails in Chatbot Arena》,arXiv:2610.19095:https://arxiv.org/abs/2610.19095 ↩
- Wei-Lin Chiang 等,《Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference》,arXiv:2403.04132:https://arxiv.org/abs/2403.04132 ↩
- Tianle Li, Anastasios Angelopoulos, Wei-Lin Chiang,《Does style matter? Disentangling style and substance in Chatbot Arena》,LMSYS 博客:https://lmsys.org/blog/2024-08-28-style-control/ ↩
- Shivalika Singh 等,《The Leaderboard Illusion》,arXiv:2504.20879:https://arxiv.org/abs/2504.20879 ↩
- LMArena,arena-human-preference-140k 数据集(Hugging Face):https://huggingface.co/datasets/lmarena-ai/arena-human-preference-140k ↩