Coding agent 产出更多代码,不等于产出更多软件(2026)
公司里上了 coding agent 之后,仪表盘最先亮起来的往往是代码量:行数、提交、PR 数量一起往上走。直觉也跟着走,写得更快,软件就该出得更快。哈佛大学的 Fiona Chen 与 James Stratton 用 Jellyfish 汇总的工程数据把这条直觉拆开了:引入 AI coding agent 之后,代码产量显著上升,但按 Issue 和 Epic 计的软件交付并没有跟着上升,多出来的效率被下游的评审环节吞掉了。[1]
这篇把那份研究放到 2026 年 10 月前后几条同时发生的现场里看。QGIS 社区把 AI 贡献政策改成「不允许」,同一周 Linus Torvalds 却公开用 Claude Code 写内核补丁。Rich Hickey 说 LLM 不是工具而是自动化,Diomidis Spinellis 则认为思考迟早会变成一种爱好。DHH 让 agent 把 Campfire 重写成 Rust,结果在重压下只送达约 1% 的通知。这些事情背后是同一条机制:写的一端变宽了,审的一端变长了,而责任落在谁身上,决定了治理该怎么选。
站内 「做完了」怎么验收 讲的是单次完成声称的证据链,烧钱的三种习惯 讲的是轨迹层面的重复花费。本文讲组织层:度量什么、谁来审、什么时候开闸、什么时候关闸。
数字先摆清楚:涨的是代码,不是交付
研究覆盖 2021 年到 2026 年 3 月,700 多家软件公司、70 多万名员工、约 3 亿条工作事件(提交、PR 等),外加这些公司的 Issue 管理数据。研究者用直接测得的 AI 使用量和 GitHub 活动,判断每家公司从哪个时间点开始引入 AI 编码助手或 coding agent,再做双重差分回归,比较引入前后、早引入与晚引入公司之间的差别。[1] 主结果如下:
| 指标 | 引入 agent 后的平均变化 |
|---|---|
| 代码总行数 | +30% |
| 提交次数 | +20% |
| Pull Request 数 | +23% |
| PR 提交到合并的评审耗时 | +49% |
| 被要求修改的 PR 占比 | 约翻倍 |
| 每个 PR 的评论数 | +35% |
| 做代码评审的员工占比 | +14% |
| Issue / Epic 解决率 | 无统计显著变化 |
写的一端扩了,审的一端拖了,交付几乎不动,这就是生产率悖论在数据里的样子。有人会怀疑是不是票被切碎了,解决率才看起来没变。研究者查过这一点,引入前后 Issue 的规模和复杂度没有出现「成分变化」,所以这个解释站不住。[1]
图:写侧指标上升、评审负担上升,Issue / Epic 解决率几乎不动。数据来自 Chen & Stratton,经 Ars Technica 报道。[1]
截图:Ars Technica 对 Chen & Stratton 研究的报道标题与导语(2026-10-09)。[1]
截至 2026 年 3 月,样本里约 95% 的公司已经部署过某种 coding agent,约 80% 用过某种 AI 代码评审,但 agent 只贡献了约 23.3% 的评审评论和约 10.8% 的 PR,绝大部分评审仍然是人在扛。[1] 也就是说,**把审查也交给同类模型,目前还补不上写代码扩出来的缺口。**就业方面,研究者在对照 LinkedIn 数据之后,没法把显著的人员变化归因到 AI;公司既没有因为代码变多而少雇人,也没有因此多交付软件。[1]
我的判断很直接:如果团队的 KPI 还停在「本周多合了多少行、多少 PR」,你奖励的是管道最宽的那一段,而不是软件是否真的往前走了。度量应该跟着瓶颈走。
这份数据能说明什么,不能说明什么
先把边界说清楚,免得把平均值读成定律。
第一,这是 700 多家公司的平均效应。双重差分能告诉你「引入 agent 的公司在评审上平均多花了多少时间」,但它不告诉你某个团队一定会这样。总有团队审得快、交付也涨了,也有团队更糟。平均值的价值在于,它说明「写得快就会交付快」不是默认结果,你得拿自己的数据证明。
第二,数据截止到 2026 年 3 月。此后几个月里模型和 agent 都有明显更新,许多公司也还在摸索什么任务适合交给 agent。[1] 评审负担有可能随着经验积累下降,也可能随着 agent 并行开 PR 变多而继续上升。两个方向都说得通,所以我更愿意把它当成一个当前状态的读数,而不是终局。
第三,研究同时涵盖了「辅助补全」的编码助手和「自己写、自己提交」的 coding agent,表里那组数字说的是 agent 引入后的变化。[1] 补全工具让人写得快一点,代码仍然大体经过作者自己的脑子;agent 一次交出一整个 PR,作者对其中每一行的理解程度差得多。后者给评审带来的压力更大,这正好和机制对得上。
机制:瓶颈从打字挪到了信任
Coding agent 改变的不是「会不会写」,而是「谁、以什么速度写出可提交的东西」。人类作者通常一边写一边做一层自我审查,写不清楚的地方自己会卡住。agent 不会卡,它可以连续开好几个 PR,把本该在写作阶段完成的自我审查推给后面的评审者。结果就是评审队列变长、要求返工的比例升高、评论变多,研究里的 +49%、约翻倍和 +35% 正是这条机制留下的读数。[1]
图:写侧变宽、审侧变长;AI 评审尚未替代人审成为主通道。[1]
这也解释了「本地做过了」和「合进主干」之间的落差。站内讨论过假完成、回执、独立重跑:agent 说测试过了,不等于合并后系统仍然正确。[2] 组织层面是同一个问题放大了:局部加速不等于全局吞吐。Jira 上的 Epic 不动,不是因为工程师变懒,而是因为可合并的信任没有跟着代码量一起扩容。
评审者到底在审什么
如果 agent 写的代码大多能跑,评审为什么还会慢这么多?Piotr Sarnacki 拆 DHH 的 Campfire 重写,给了一个很具体的答案。[8] DHH 不想读写 Rust,于是让 agent 把 Campfire 从 Rails 重写成 Rust,之后又加了 Elixir 和 Go 版本。Sarnacki 的观察是:提示写得不够具体的时候,很多决定等于掷硬币,因为它们本来就没有唯一正确答案。要不要保持向后兼容?延迟优先还是吞吐优先?高负载下系统能用多少内存?崩溃后丢掉新消息通知能不能接受?你可能没想过这些问题,但 agent 实现的时候会把它们一一默默回答掉。[8]
于是 Rust 版去掉了 CSRF token 好让缓存更简单,把 Redis 换成了进程内队列;Elixir 版则更贴近原来的 Rails。两个版本对兼容性的取舍根本不同,拿它们比语言快慢几乎没有意义。[8] 再往下看,Rust 版有些数据库操作和锁在异步任务里阻塞运行;在协作式调度下,一个任务不让出,同一个工作线程上的其他任务就只能干等。压测里,Rust 版在重负载下的新消息通知送达率只有约 1%,原因是广播通道容量被设成了 256,接收端跟不上就被判定落后。把容量改成 16384,送达率能从约 14% 升到约 90%,但最坏的送达延迟也从 11 秒涨到 130 秒以上。[8] 哪个更好,要看你宁可让慢客户端断线重连,还是让它等三分钟。这是产品决定,不是语法问题。
图:提示里没回答的问题,会在实现里被默认回答;评审要把这些默认值一一找出来。[8]
截图:Piotr Sarnacki《I’m sorry, but you still have to think》开头,讨论 DHH 让 agent 重写 Campfire(2026-10-11)。[8]
这个例子把哈佛数据里的 +49% 讲成了一件能摸到的事。评审者面对 agent 的 PR,要做的不只是看代码对不对,还要把一串没人拍过板的默认值挖出来,再判断每个默认值是否符合产品意图。人写的代码,这些决定往往在写之前就讨论过,或者作者能当场解释;agent 写的代码,评审者常常是第一个意识到「这里其实有个决定」的人。审查的工作量就这样从「核对」变成了「补设计」。
还有一层成本。轨迹研究显示,agent 的很多花费发生在重复检索、相似脚本、空转重跑测试这类看起来合理的动作上。[3] 这些动作又会制造更多 diff,更多需要人看的表面工作。代码量上涨和评审变慢,往往是同一条管道里前后两段的症状。
维护者分叉:QGIS 关闸,Torvalds 亲自用
同一周前后,开源世界给出了两种几乎相反的治理答案。
QGIS 在 QEP428 里把 AI 政策改成严格的「不允许」,PR #387 于 2026-10-07 合并。[4] 维护者写得很直白:外部贡献者用 AI,会给本就吃紧的评审带宽施加难以承受的压力。AI 产出的速度高于人能认真审完的速度,结果要么是未审 PR 越堆越多,要么是审查质量下降。自由软件社区建立在人与人的网络上,组织愿意信任并回馈的,是能贡献、能被雇来做支持与培训的人,所以他们要先保住欢迎人类贡献的带宽。[4] 提案作者强调这不是永久禁令,而是先把门关上,以后按具体用例逐步放开;执行靠贡献者的诚信,因为「你自己知道是不是自己写的」,而不是靠扫描仓库的检测器。[4]
Linus Torvalds 则在自己的 torvalds/linux.git 里开了分支 noref-filemap-read-with-llm,用 Claude Code 推动「从 page cache 读取时不持有 folio 引用」的改动,目标是缓解多线程对同一文件做小块读取时的 folio 引用计数争用。[5] 他在补丁说明里写明:代码、测试程序、所列审查以及封面信的初稿,都是在他的指挥下由 Claude Code 完成的,测量在他自己的机器上跑。[5]
图:QGIS 用关闸保护评审带宽;Torvalds 在本人指挥与验收下使用 Claude Code。[4][5]
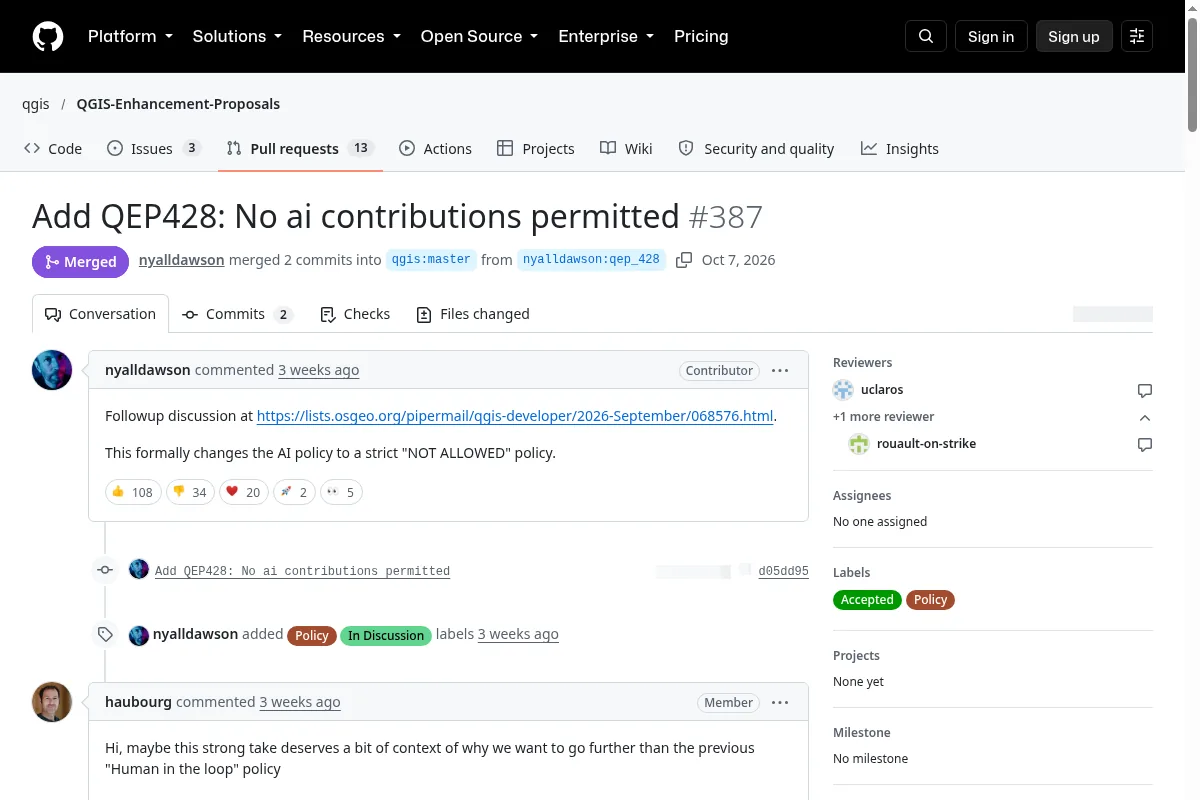
截图:QGIS Enhancement Proposals #387(QEP428)已合并,政策改为不允许 AI 贡献。[4]
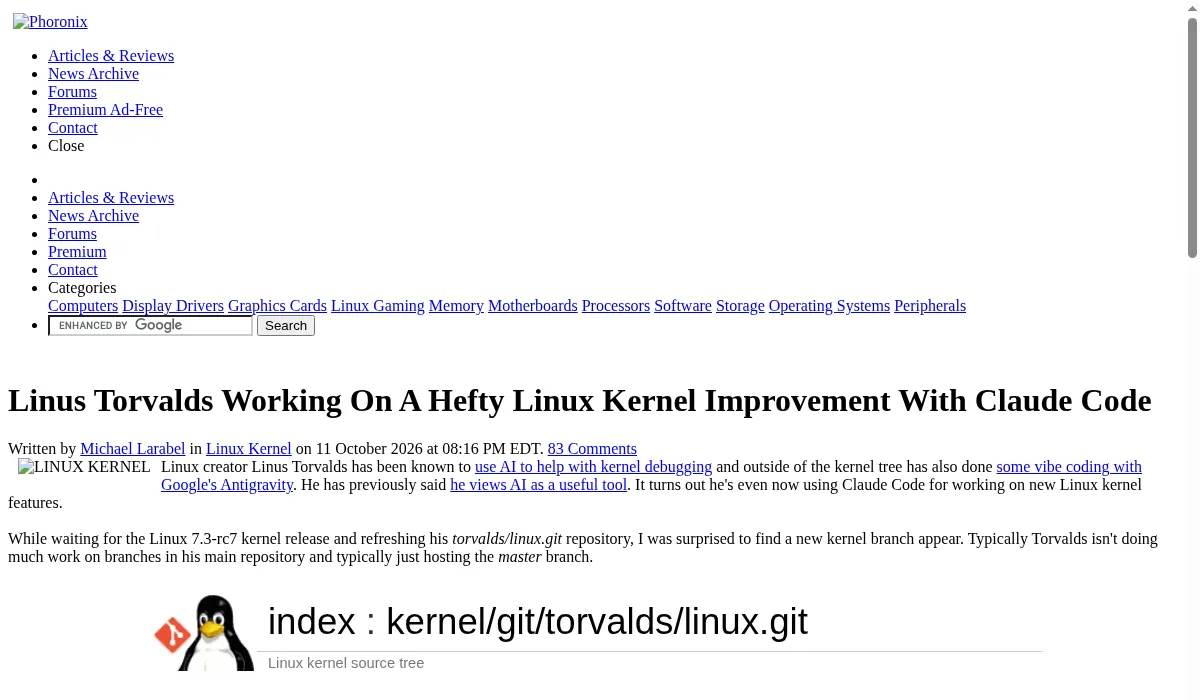
截图:Phoronix 报道 Torvalds 仓库出现 noref-filemap-read-with-llm 分支。[5]
这两种选择并不互相抵消。QGIS 面对的是陌生人贡献加上有限维护者的带宽危机,和哈佛研究里「评审变长」是同一类约束,只不过开源项目没有编制预算去加评审人手。Torvalds 面对的是本人负责的单个高杠杆改动:他指挥、他验收、他公开声明 LLM 参与的范围,瓶颈仍在他身上,变的只是打字和起草的速度。
所以「Torvalds 都在用」不能当成公司全面放开 agent 开 PR 的许可证。他没有把内核评审外包给一群陌生贡献者的 agent,他是给自己加了一个打字很快的助手,而审查和担保仍然由全世界最熟悉这块代码的人亲自完成。把这个案例搬到一个 200 人的工程团队里,真正该复制的是「谁指挥谁担保」的结构,而不是「用了 Claude Code」这个表面事实。
QGIS 的选择也不该被读成「反技术」。一个靠志愿者维护的项目,评审时间是最稀缺的资源,任何把评审成本推高的东西都要先证明自己值得。QGIS 只是比大多数公司更早承认了这一点:他们没有预算假装管道无限宽。
认知外包:工具和自动化不是一回事
度量和治理之外,还有一层更难写进 KPI 的问题:人在这条管道里还留下什么能力。
Rich Hickey 在 2026-10-12 的短文里把话说得很死:LLM 不是工具,而是自动化。[6] 工具是你握在手里、带着连续控制和感官反馈去驾驭的东西,用工具会积累关于世界和任务的专长。自动化则是它自己干活,你几乎不直接控制。他拿得来速(drive-thru)打比方,那是让你不必做饭的自动化;LLM 是让你不必写代码、把写代码让渡出去的自动化。你发出请求,它自行行动,这个请求和执行的循环既不是驾驭,也没有连续反馈。[6] 用自动化去读论文、写文章,你错过的不只是几段摘要,还有学习怎么论证、怎么注意到边角、怎么判断该信任或怀疑哪些作者,以及怎么思考。[6]
Diomidis Spinellis 把时间轴拉得更长。他认为今天的大部分认知工作会被 AI 接管,人类思考会越来越像狩猎、书法、木工、骑马,从谋生需要变成可以选择的爱好。[7] 他并不是在庆祝。他给的准备建议是跟上并利用 AI 的进展,同时建立工作之外仍然有意义的生活;他自己的挑战是从「靠思考谋生」转向「让思考成为值得过的人生的一部分」。[7]
这两段话听起来像哲学,伯克利参与的一项研究给了它一个可测的版本。研究团队在线招募了 1,222 名参与者做随机对照实验:一组做 15 道基础分数题时旁边开着 ChatGPT,可以求助甚至直接要答案,另一组独立完成。有 AI 的一组一开始更准;做到第 12 题时研究者把 AI 拿走,这一组几乎立刻做不对了,跳题和放弃的比例明显上升。换成 SAT 阅读理解题,结果相同。[9] 研究者的结论是,仅仅依赖 AI 大约 10 分钟,就会明显削弱人在难题上坚持下去的能力。[9]
截图:UC Berkeley Research 对该随机对照研究的报道(2026-10-09)。[9]
分数题不是代码评审,这项实验也不能直接外推到资深工程师。但它指向的方向和哈佛数据接得上。评审是整条管道里最需要「坚持读完一段难懂代码」的环节;如果团队里越来越多的人习惯了请求一下就拿到答案,愿意并且能够把一个 agent PR 从头审到尾的人会变少,而他们恰恰是交付的上限。
Hickey 的区分还能帮你读懂 Torvalds 的例子。关键不在「用没用 LLM」,而在他是否仍然握着意图、核对结果、承担合并责任。那更像是自动化被放在他的控制回路里,而不是把方向盘交给一个请求队列。同样用 Claude Code,一个人在里面学到东西、一个人在里面退化,差别在于回路的另一端是谁在看。
团队决策框架:先量交付,再放开写的一端
把上面几条收成能执行的顺序。我不建议一上来就争论「禁不禁 agent」,更稳的做法是先改度量,再按责任结构选治理。
1. 换主指标
把主看板从行数、提交、PR 数量换成和软件前进对齐的量:在约定质量门槛下关闭的 Issue 与 Epic、生产事故率、评审排队时长、合并后回滚次数,以及「单独跑能过、合并后挂掉」的比例。哈佛研究里没变的那一行(Issue / Epic 解决率)才是你该盯住的出口,涨的那几行最多当辅助表。[1]
2. 按责任结构分闸,不要全员一套政策
| 场景 | 更接近 | 建议 |
|---|---|---|
| 核心维护者本人指挥、本人验收的高杠杆改动 | Torvalds 模式 | 允许 agent 起草;公开声明参与范围;先写验收标准再开写 |
| 陌生人或大量外部贡献涌入、评审席位固定 | QGIS 模式 | 限制或暂停 AI 代码贡献,先保人类贡献通道 |
| 内部团队、有编制可以加评审 | 研究里的多数公司 | 可以扩写的一端,但必须同步扩审的一端(人时、门禁、独立重跑),否则交付不会动 |
| 探索、原型、一次性脚本 | 低风险场景 | 默认放开;合入主干前换人审或换环境验证 |
3. 先扩审的一端,再扩写的一端
研究显示,评审耗时和返工上升是吸收效率的主要机制,而 AI 评审目前只覆盖一小部分评论和 PR。[1] 实务上,合并前的独立重跑、回执(命令、exit code、commit 哈希)、针对「做完了」的验收清单,比再加一个同类模型扮演的「AI reviewer」更接近真正的审查扩容。[2] 如果加人时、加门禁都做不到,就应该像 QGIS 一样限制入口,而不是假装管道无限宽。
4. 把隐含决定写进任务说明
Campfire 的例子说明,评审时间有很大一块花在找出没人拍板的默认值上。[8] 与其让评审者事后挖,不如在派活时把关键约束写进任务说明:兼容性要求、延迟和吞吐的优先级、内存上限、失败时是丢弃还是排队。写不出来的,说明这张票本身还没想清楚,交给 agent 只会把问题推迟到评审阶段,而且更贵。
5. 保护还能审的人
Hickey、Spinellis 和伯克利的实验提醒的是能力折旧。团队至少要保留一部分必须由人读完、由人讲清设计取舍的任务。这不是仪式,而是维持评审能力的训练量。把所有读和写都交给请求与执行的循环,短期仪表盘很好看,半年后你可能找不到够格的审稿人。
6. 用实验窗口说话,不用口号
选一条业务线做 4 到 6 周对照:同一类 Epic,一组按旧流程,一组放开 agent 开 PR,两边用同一套交付指标和评审耗时。如果代码量涨了、交付不动、评审变长,你得到的结论不是「AI 没用」,而是「瓶颈在审」,这和 Chen 与 Stratton 的平均图像一致。[1] 有了这个读数,你才能决定是加审查人手、改门禁,还是收紧哪些票允许 agent 写。反过来,如果交付确实涨了,也要回头看是哪类任务涨的,把那类任务的做法推广,而不是推广「用 agent」这个笼统动作。
结语:软件的上限是信任的吞吐量
Coding agent 很擅长把「可以提交的文本」变多。软件往前走依赖的是另一条窄得多的通道:有人理解这次改动,愿意为它担保,并能证明它在合并后的系统里仍然成立。哈佛的数据说明,平均来看这条通道还没被扩开;QGIS 选择先保护通道不被冲垮;Torvalds 选择在自己仍然握着方向盘的时候加快打字;Sarnacki 的拆解说明,通道里流过的不只是代码,还有一串没人拍板的决定;Hickey、Spinellis 和伯克利的实验提醒你,长期把思考外包出去,通道另一端能看懂代码的人会变少。
所以别再用「本周多写了多少代码」来庆祝 agent 落地。换一个更短的问题:这周多关掉了多少真该关的票,评审队列是变短了还是变长了? 答得清楚,你的治理自然会靠向表格里的某一行;答不清楚,你多半还在优化管道里最宽、也最不值钱的那一段。
参考来源
- Kyle Orland,《AI coding agents generate more code, but not more software》,Ars Technica,2026-10-09(报道 Fiona Chen 与 James Stratton 基于 Jellyfish 数据的研究):https://arstechnica.com/ai/2026/10/ai-coding-agents-generate-more-code-but-not-more-software/ ↩
- 站内:coding agent「做完了」怎么验收 ↩
- 站内:Coding Agent 烧钱的三种习惯 ↩
- QGIS Enhancement Proposals #387,Add QEP428: No ai contributions permitted(已合并):https://github.com/qgis/QGIS-Enhancement-Proposals/pull/387 ↩
- Michael Larabel,《Linus Torvalds Working On A Hefty Linux Kernel Improvement With Claude Code》,Phoronix:https://www.phoronix.com/news/Linus-Torvalds-Claude-Code ↩
- Rich Hickey,《‘AI’ is Not a Tool》,LinkedIn Pulse,2026-10-12:https://www.linkedin.com/pulse/ai-tool-rich-hickey-kjl8e ↩
- Diomidis Spinellis,《Thinking will become a hobby》,2026-10-08:https://www.spinellis.gr/blog/20261008/ ↩
- Piotr Sarnacki,《I’m sorry, but you still have to think》,2026-10-11:https://itsallaboutthebit.com/i-am-sorry-but-you-still-have-to-think/ ↩
- Jason Pohl,《Using AI for Just 10 Minutes Erodes Your Ability to Persist at Hard Things》,UC Berkeley Research,2026-10-09:https://vcresearch.berkeley.edu/news/using-ai-just-10-minutes-erodes-your-ability-persist-hard-things ↩