陶哲轩博客《我们到底为什么要做这些》:AI 会解题以后,数学家为什么还要做数学
10 月 15 日,陶哲轩(Terence Tao)的博客 What’s new 发了一篇客座文,题目是《Why are we even doing all this?》(我们到底为什么要做这些?)。作者是理论粒子物理学家 Rikab Gambhir,陶哲轩在文首加了一行编者按。[1] 陶哲轩说这段时间他把博客的大部分版面交给了客座作者,[18] 他自己的看法主要发在 Mathstodon 上。所以这篇文章要和他过去六周的帖子对照着读:客座文把问题问得很刺耳,陶哲轩给的是一套可以拿去改评价制度的回答。
同一天,Derek Thompson 发了《I Know Why the Mathematicians Weep》,Hacker News 上的讨论帖到 10 月 18 日有 391 分、669 条评论;[2][5] Simons 基金会宣布和 Anthropic、OpenAI 投入 1500 万美元帮数学界适应 AI。[3] 同一周 arXiv 上,35 位作者公布了 TheoPhysEval:50 道没发表过的研究级理论物理题,表现最好的 agent 解出了 49 道。[4]
站内上一篇《Lean 编译通过,到底证明了什么》问的是「AI 证明了 X」时有多少东西真被机器查过。这一篇往前走一步:就算结果全对,数学家为什么还要自己做数学,这个职业和机构该怎么调整。我的回答是:「我们负责解决难题」这套对外说法被 AI 打穿了,撑得住的是「我们负责产出理解,并培养懂这些东西的人」。下面按能力、意义、机构三层来说。
AI 现在能做到哪:TheoPhysEval 量的是「转曲柄」的活
TheoPhysEval 向各领域专家征题,最后收了 11 个主题,要求有三条:和当前研究相关;答案容易验证、很难猜;答案在已发表文献里查不到。论文自己说,这些是「转曲柄」(turn-the-crank)型的研究题,用已知技术把一个已有结果推广一步,答案严格说是新的,有时还能发表,但谈不上开创性。[4] 常见的出题方式是专家把自己近期论文里的计算改几个参数,别人要先找到原论文、读懂、重建计算,再改到新参数上。以「黑弦 Page 时间」那道题为例,原论文作者之一 Suvrat Raju 改写计算用了大约一天;在现代 agent 出现之前,能做这题的只有少数专家,还要花好几天。[4]
为了不用 LLM 当裁判,作者把所有符号答案都转成了数值,给相关和无关的物理量都赋上具体数,最后只比浮点结果。评测分两条赛道:「现实赛道」允许联网搜索和本地工具,「隔离赛道」断网。每题给 2 个 vCPU、4GB 内存,8 小时没出结果算零分,每个 agent 只跑一遍。[4]
现实赛道上,Codex 里的 GPT-6-Astra 解出 49/50,Claude Code 里的 Opus 5.5 解出 46,Antigravity 里的 Gemini 3.8 Flash 解出 34,Codex 里的 DeepSeek-V4.1-Flash 解出 27,Claude Code 里的 GLM 5.3 解出 21;隔离赛道上 Astra 和 Opus 都是 46,Gemini 31、GLM 26、DeepSeek 25。Astra 跑完现实赛道全部 50 题的 API 花费是 116.28 美元,平均每题不到 3 美元。[4] 两个细节比总分更说明问题。一是 Astra 起初被判错的几道题,复核后发现错在专家的参考答案。二是断网后准确率几乎不变,而有些题不查背景论文,人连符号都看不懂;作者据此认为,前沿模型已经记住了理论物理文献的很大一部分。[4]
图:TheoPhysEval 的出题与评测流程,以及五个 agent 在两条赛道上的解题数。数据来自[4]。
所有模型都没解出的只有一道反问题:从一条曲线反推生成它的自治微分方程。[4] 论文更重要的是自己划的边界。具体计算往往要到研究很晚的阶段才出现;在作者的经验里,现在的 agent 不擅长在原题太难时换一个相关、更简单又同样有意思的题,也没有物理学家那种「什么问题有意思」的品味,让它们出新题时,会过度关注人觉得无趣的细节。他们引了「闭嘴,计算」(shut up and calculate)这句老话,说物理学家今后可能得「停下来,想一想」。[4]
数学这边也是同一个量级:OpenAI 说 10 月 6 日那批结果平均每个用掉的算力,约等于三小时 ChatGPT Pro 思考。[16] Anthropic 10 月 16 日的文章是另一类例子:内部模型不到半小时就找出了 NIST P-192 到 P-521 五条曲线种子的来历,它们是 C 库随机数生成器 lrand48 用 1997 至 1998 年的 Unix 时间戳初始化后的输出。[15] 困扰密码学界二十多年的疑问,答案是「只是时间戳」,价值几乎全在答案本身。
能力端我这样概括:只要问题已经说清楚、答案能机械核对,AI 已经追上甚至超过了顶尖专家,单题成本按美元算。它还没覆盖的是问题出现之前的那一段,包括选什么题、题选错了怎么换、什么东西值得算。
一篇反讽文问出的问题
Gambhir 的文章通篇说反话。开头仿写「起初他们来抓……」那首诗,轮到物理学家时「其实挺酷的,他们给了我免费 token,答应替我解决整个领域」。正文说 OpenAI 实现了每个数学家的童年梦想:一台冷冰冰的企业机器人烧掉一片雨林,整理出 700 条几乎读不懂、「也许」为真的事实,给 IPO 造势。[1]
反话底下的论点很具体。他借博尔赫斯的巴别图书馆说,按 2026 年的标准,那座收藏一切可能之书的图书馆会是史上最成功的研究机构。OpenAI 的「效率提升」在于只生成看起来对的东西,把确认对错、弄懂内容这份不体面也不赚钱的活外包给整个数学界,而这份活过去归写论文的人自己。[1] 他说,过去科学家能解决多少问题,受限于他们能理解多少答案;现在这个瓶颈被移除了,「我们没能理解的科学事实,从此没有理论上限」。[1] 结尾那句不再反讽:记住你当初为什么选择科学和数学。
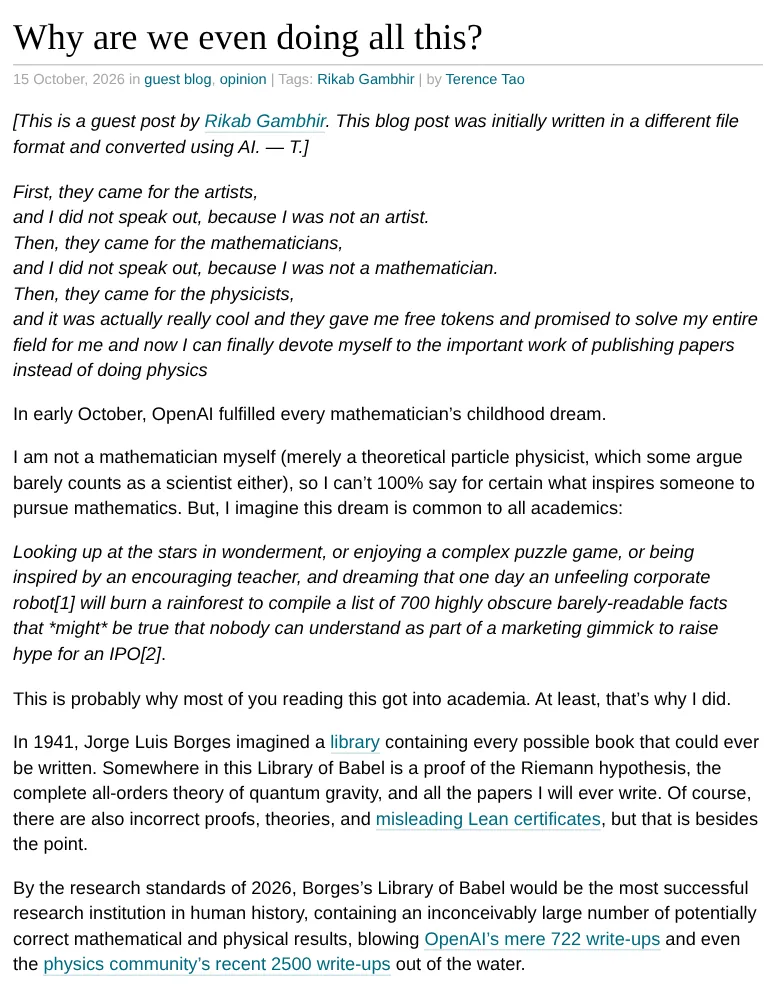
截图:陶哲轩博客上的客座文,标题下是陶哲轩的编者按,正文提到「OpenAI 区区 722 份稿件」(What’s new 原文,2026-10 截取)[1]
评论区更有用,有人提出了最难回答的问题。署名 BE 的读者说文章既没正面回答标题,也没回答「我们凭什么为此拿工资」:你享受数学,还想拿报酬和地位,就得说清它最终为了什么。[1] Lior Silberman 的回复更务实:社会付钱让他证定理,所以个人乐趣要排在数学的社会价值之后;如果以后证定理不再划算,他得找别的理由,比如发展和传播数学理解,把它用到数学以外。[1] 也有人不同意前提。mitchellporter 认为那些稿件难读但有实质内容;真正的问题是,还没人知道怎么把能按需做研究级数学的非人实体放进现有的数学实践。[1]
这篇反讽文回答了「我为什么做」,答案是好奇、理解和创造的乐趣,却没回答「社会为什么付钱」。后者才是职业层面的问题,陶哲轩过去几周写的正是对它的回答。
陶哲轩自己的回答:好问题是会被采空的资源
9 月初,陶哲轩在 Mathstodon 上写了一串帖子,核心是区分两个问题:「X 的答案是什么?」和「研究 X 能学到什么?」。后者包括:主要困难在哪,要发明什么新技术,现有技术为什么不够,X 和别的课题有什么联系,自然的后续问题是什么。过去这两个问题高度一致,因为解难题唯一可行的路,就是先回答这些子问题。现在有人把强大的 AI 工具对准 X、又没有专家把关,两者就开始背离,甚至负相关:继续朝「得到答案」优化,反而会减少洞见,因为答案会污染后续推理、拉低信噪比、削弱继续分析的动力。[7]
他拿自己参与的等式理论项目(ETP)举例。这个项目用几个月解决了 2,200 多万个泛代数蕴涵关系,并在 Lean 里形式化。有几处蕴涵卡了他们很久,逼出了构造无限反例的新技术,后来自动定理证明器发现它们其实有很小的有限反例。要是有限反例先被找到,那些更有意思的方法可能就不会出现。他的说法是,数学史上第一次,纯数学里的开放问题被当成不可再生资源来开采;开采得粗糙,数学得到的净收益会少得多。[8]
开放问题明明随手就能造出无数个,比如算 π 的第 10^10^10 位,为什么会稀缺?他的解释是,大多数问题不值得关注,判断哪个值得研究,靠的是对一个领域「难度地形」的熟悉:哪些用已知方法很容易,哪些费点力能解,哪些做不动。AI 把这片地形压得最平,AI 公司又不公开负面结果,没人知道能解和不能解的边界在哪。所以现在稀缺的是「找到一个好问题」本身;只要传出有人在做某个问题,就可能招来大量算力抢先把它压平,人们于是不再公开有前途的方向。[9]
9 月 10 日的帖子谈这个职业怎么向外界介绍自己。他说许多人被数学吸引,是因为能把孩子般的好奇心用在正经事上;但为了让出钱的大人满意,数学家常常淡化这一面,强调「解决指定的开放问题」这种硬目标。过去这种体面的说法行得通,因为人类解题时总会同时用上孩子和大人的两套本事;现在 AI 可以直接瞄准名义目标:「旗子拿到了,球进了,问题解决了;代价是该学到的东西、该得到的洞见、该结成的合作和该找到的新目标。」[11]
我认为这是整场讨论最关键的一段,它回答了 BE 的问题。数学界对资助方讲的「我们解决难题」本来只说了一半,另一半是解题过程留下的技术、联系和人。AI 把前一半做得很便宜,后一半就得明说出来。10 月 7 日的「Math 2.0」四连帖就是在做这件事:Math 1.0 看重第一个解出开放问题,哪怕解法起初没人懂;Math 2.0 要把单纯的解题挪出中心,更全面地衡量数学进展,例如提高讲解(exposition)、社群建设和开辟新方向的地位,数学界也要明确重估教育、发表和晋升的标准。[6]
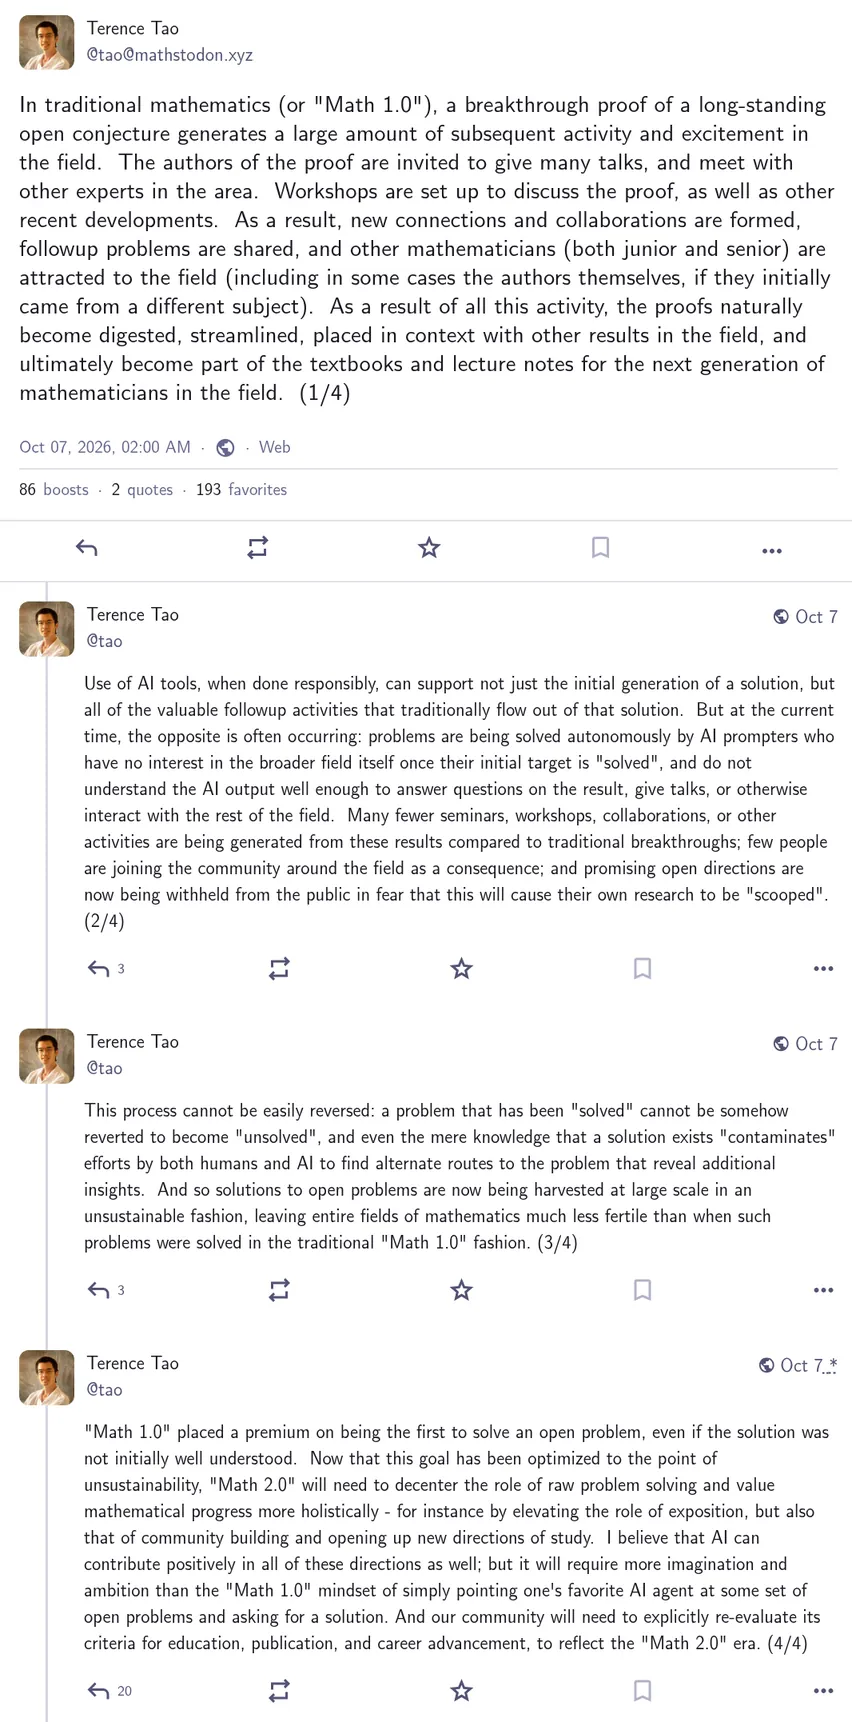
截图:陶哲轩在 Mathstodon 上的「Math 2.0」四连帖,从 Math 1.0 的突破如何被消化,讲到 AI 解题为何让领域变得贫瘠(Mathstodon 原帖,2026-10 截取)[6]
他还拿素数间隙问题推演过另一条时间线:假如 2005 年就有追逐基准的 AI 公司,界值很快会停在三位数,问题被当作「饱和」,没人消化那些结果,后来成为教科书方法的 Maynard 筛法也许不会出现。他强调,界值本身没多少内在价值,价值在于改进它的研究揭示了什么。[10]
Thompson:手艺还在,对话断了
Thompson 从眼泪写起。2022 年菲尔兹奖得主 Hugo Duminil-Copin 在 OpenAI 10 月发布之后说:「周二晚上我哭了,把女儿都吵醒了。他们把我的研究领域毁了。」康奈尔大学的 Steven Strogatz 说,同行在用「他们在露天开采我们的学科」这样的说法。[2]
Thompson 的框架是:科学既是一门手艺,一种观察世界、提出问题的方式,也是一场对话,牛顿说「站在巨人的肩上」,费曼说科学是「相信专家是无知的」,讲的都是和其他发现者的关系。Strogatz 跟他讲了阿基米德写给埃拉托色尼的一句话:将来不会缺少发现者,来给我们分到的这些定理再添新的。他说,他觉得阿基米德是在写信给他。[2] Thompson 认为,OpenAI 一次结束几百场寻宝,在手艺这条轴上很成功,却打断了延续千年的对话。他最后反问:如果 OpenAI 是对的,数学本来就主要是寻宝,而不是一场感受和发现同样重要的对话呢?[2]
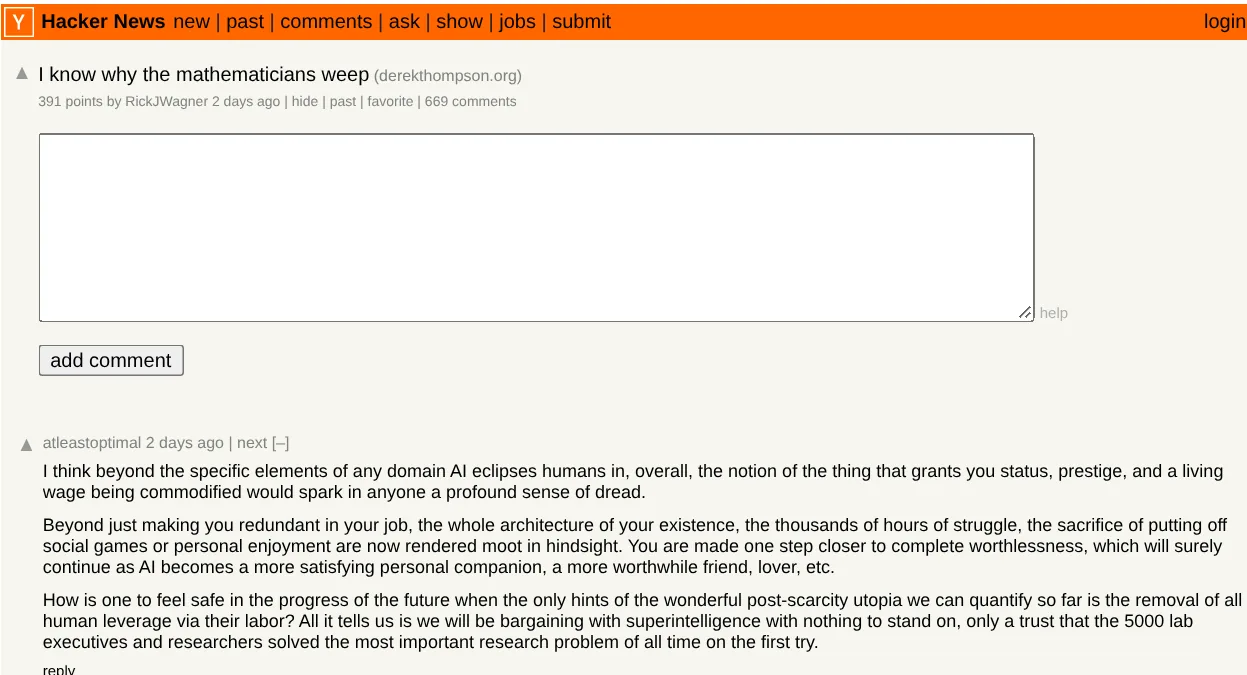
截图:Hacker News 上 Thompson 文章的讨论帖与排在最前的评论(HN 原帖,2026-10-18 截取)[5]
HN 上的讨论转向了劳动市场。排在最前的评论说,给你带来地位和收入的东西一旦被商品化,谁都会恐惧。[5] 一位软件工程师说他很难同情数学家,毕竟大学没有因此解雇数学家;也有人指出,大量数学家本来就在不稳定岗位上,或早已转行做软件和精算,这些岗位同样在被替代。[5]
我同意 Thompson 抓住了「对话」这个词,但他把它讲得太像情感问题。陶哲轩对 Math 1.0 的描述说明,对话本身就是技术传给下一代的方式:突破之后的讲座、工作坊和合作,正是证明被消化、精简、放进领域脉络、最后写进教材的过程。[6] 打断对话,损失的不只是情感上的联系,还有新方法进入教材的那条路。至于劳动市场,TheoPhysEval 的作者说得更具体:受冲击最直接的是刚入门的人。这类题过去适合当新研究者的入门项目,既训练能力又能拿到原创结果;现在再这样布置已不合适,除非大家都清楚目的只是把题做一遍。[4]
机构在做什么:1500 万美元买的是「消化」
Simons 基金会的新闻稿说,基金会、Anthropic 和 OpenAI 合计投入 1500 万美元的资金和资源,由基金会管理,包括公开征集提案,资助工作坊等项目,帮研究者评估 AI 辅助结果、学习新工具、共同制定使用 AI 的标准;两家公司还会给受资助者提供工具和算力,范围延伸到其他基础科学。[3] 基金会主席 David Spergel 说,要把数学看作「不是一堆证明和定理,而是由人的好奇心推动的集体理解」;这些工具怎么评估和使用,应由数学界主导,而不是某一家公司或机构。[3] 基金会早年还资助过 Lean 证明助手的开发。[3]
陶哲轩抱怨的正是 AI 结果带来的研讨会、工作坊和合作太少,[6] 这笔钱资助的恰好是「消化」这一层。连同这几周的其他动作,机构层的反应大致分四类:
- 立规矩。 普林斯顿高等研究院主持的数学与人工智能咨询组(AGMAI)有九位成员,独立于 AI 公司、不收报酬、只提建议。[20] 首批 25 位菲尔兹奖得主(页面现列 28 位)9 月 11 日联署《AI 在数学中的严重错位》,说解题只是通往概念理解的工具和替代指标,忘了这一点,工具就会反过来损害真正的目标。[13] 人类数学协会(AHM)更进一步,呼吁数学家停止与 OpenAI 合作。[19]
- 出钱消化。 除了 Simons 这笔钱,OpenAI 在 10 月 6 日的发布文里也说会资助一系列围绕理解 AI 结果的工作坊、会议和专项计划。[16]
- 自建工具。 陶哲轩参与的 SAIR Open Math OS 10 月 16 日软上线,托管 DeepSeek V4.1 Flash 等开放模型(他说比前沿落后约一年),以团队账户为主,成员互相能看到提示词。[17]
- 记录人的贡献。 Deanna Needell 和 Hayden Schaeffer 在陶哲轩博客上征集数学家在这波 AI 预印本里做过什么,比如早期结果、核对论证、联系文献。[21]
图:能力、意义、机构三层各自已经有了什么、还缺什么。来源见[1][3][6][13][15][17][20]。
这笔钱方向是对的,它付的正是 Gambhir 说被外包出去的那份活;[1] 但出钱的两家公司,正是让消化成本暴涨的一方。Sophie Huiberts 在陶哲轩博客上写道,证明定理就要对学科负责,至少说明哪些步骤是新想法;而 OpenAI 把 372 个结果切成 719 份 PDF,不做恰当署名,这些 PDF 是内部基准测试排出的「废气」。[14] 这个批评是否公允评论区争议很大,但生成结果和消化结果的确实已是两拨人。1500 万美元能办很多工作坊,却碰不到陶哲轩列的最后一条,教育、发表和晋升标准,[6] 那只能由院系、期刊和资助机构自己改。
还有公平问题。TheoPhysEval 的作者担心,理论物理一向花钱少、相对平等,更难的问题会需要更多资源。[4] 他们的数据量出了差距:SAIR 托管的 DeepSeek-V4.1-Flash 在现实赛道解出 27/50,Astra 是 49/50。[4][17] 社区工具能解决协作问题,暂时补不上能力差距。
我的判断:哪些工作会被稀释,哪些更值钱
我用两个问题给一项数学工作定位。第一,它的价值主要在答案本身,还是在求解过程留下的东西,包括技术、联系、新问题和懂行的人?第二,结果能不能机械核对,比如给出数值答案或 Lean 证明?两个问题交叉,得到四种情况。
图:按「价值在答案还是过程」和「能否机械核对」给数学工作定位,例子来自[4][8][9][15]。
- 价值在答案、能机械核对:ECDSA 的种子、TheoPhysEval 这类转曲柄计算、把某个界值再压低一点。AI 在这里最强,人的边际价值被稀释得最快,「我能把这个算出来」作为职业信号会迅速贬值。
- 价值在答案、难以核对:没有形式化的长证明,以及陈述本身写得很长的形式化。价值转到核对上,站内 Lean 那篇讲的陈述忠实问题都落在这一格,能读懂、能挑错的专家会比以前更稀缺。
- 价值在过程、能机械核对:学生的训练题、ETP 那样的大规模项目。题目 AI 能解,但做题的人和探索顺序有价值。该改的是布置和评价方式,比如明说这是训练,或者像 ETP 的教训那样先让人探索,再放开自动化。[8]
- 价值在过程、难以核对:选题、判断难度地形、讲解和消化、带学生、把新方法放进文献脉络。这一格更重要,因为它是另外三格的上游:AI 解得越多,越需要有人决定解什么,并把解出来的东西变成别人能用的理解。
照这个框架,会被稀释的有:抢先发表的优先权、改几个参数就成文的论文、把解题能力当作招生的主要信号。会更值钱的有:挑问题的品味(agent 目前缺的正是这个)、把难读的结果讲明白、核对陈述、公开负面结果和难度地图,以及署名和传承。[4][9]
还有一点不太好听。这个框架对年长、有终身教职的数学家更友好,因为品味和判断力是多年转曲柄攒出来的。如果入门题都交给 AI,下一代的品味从哪里长出来,是这场转型里最没人回答的问题。TheoPhysEval 作者建议的「明确只是为了把题做一遍」是个起点,[4] 但要学生明知 AI 能给答案还花几天自己算,评价制度就得给这几天记分。
给几类人的具体建议
- 研究生和博士后:继续做转曲柄的题,但别指望它当成果;把时间花在读原始文献、追问为什么这样算、写出别人能读懂的讲解上。把一个难读的 AI 结果讲清楚,比改一个参数更能证明你的能力。
- 导师和院系:把入门项目改成「先自己做,再和 agent 的解对照」,把讲解、综述和形式化陈述审查算进考核;招聘评议时多问一句「这个人提出过什么好问题」。[6]
- 期刊和资助机构:给消化型的工作单独的发表通道和资助名目;要求 AI 参与的结果写明人做了什么、模型做了什么,[21] 并鼓励公开负面结果。
- AI 实验室:公开失败的尝试和求解过程,和领域专家一起写稿,别只发结果清单。陶哲轩提过一个新比赛:不比谁先宣布解出未解问题,比谁先宣布一个新的数学洞见。[12]
结语
回到标题的问题。Gambhir 的答案是好奇和理解的乐趣,这是个人层面的真话。陶哲轩的答案在职业层面:数学的价值从来不只在答案,更在研究问题时留下的技术、联系和人;AI 让两者分开以后,数学界得把后一半明说出来,并且据此改评价标准。[6][7][11] Thompson 写出了真实的悲伤,但悲伤不构成论证;Simons 的 1500 万美元说明机构已承认消化要花钱。剩下的问题落在院系和期刊身上:它们愿不愿意给「理解」记分。
参考来源
- Rikab Gambhir,《Why are we even doing all this?》,Terence Tao 博客 What’s new 客座文及评论区,2026-10-15:https://terrytao.wordpress.com/2026/10/15/why-are-we-even-doing-all-this/ ↩
- Derek Thompson,《I Know Why the Mathematicians Weep》,2026-10-15:https://www.derekthompson.org/p/i-know-why-the-mathematicians-weep ↩
- Simons Foundation 新闻稿(1500 万美元计划),2026-10-15:https://www.simonsfoundation.org/news/simons-foundation-launches-15m-effort-to-help-mathematicians-navigate-ai-era/ ↩
- A. Ramesh Chandra 等(含 Suvrat Raju、Praneeth Netrapalli),《TheoPhysEval: Assessing AI agents at autonomous theoretical physics problem solving》,arXiv:2610.16733:https://arxiv.org/abs/2610.16733 ↩
- Hacker News,《I know why the mathematicians weep》讨论帖(2026-10-18 查看时 391 分、669 条评论):https://news.ycombinator.com/item?id=50103630 ↩
- Terence Tao,Mathstodon「Math 2.0」四连帖,2026-10-07(北京时间):https://mathstodon.xyz/@tao/117395267721642920 ↩
- Terence Tao,Mathstodon「What can be learned from studying X?」三连帖,2026-09-04(北京时间):https://mathstodon.xyz/@tao/117208617602946453 ↩
- Terence Tao,Mathstodon ETP 三连帖,2026-09-08(北京时间):https://mathstodon.xyz/@tao/117230983266837293 ↩
- Terence Tao,Mathstodon 难度地形四连帖,2026-09-09(北京时间):https://mathstodon.xyz/@tao/117237320796901560 ↩
- Terence Tao,Mathstodon 素数间隙八连帖,2026-09-06(北京时间):https://mathstodon.xyz/@tao/117219548485446992 ↩
- Terence Tao,Mathstodon「体面说法」三连帖,2026-09-10(北京时间):https://mathstodon.xyz/@tao/117244102901892965 ↩
- Terence Tao,Mathstodon「新比赛」帖,2026-09-06(北京时间):https://mathstodon.xyz/@tao/117221032761877425 ↩
- 《A Severe Misalignment of AI in Mathematics》,菲尔兹奖得主联署声明,2026-09-11:https://mathandai.org/ ↩
- Sophie Huiberts,《This is normal bad work》,Terence Tao 博客客座文及评论区,2026-10-12:https://terrytao.wordpress.com/2026/10/12/this-is-normal-bad-work/ ↩
- Anthropic,《Claude reveals ECDSA curve origins》,2026-10-16:https://www.anthropic.com/research/ecdsa-curve-origins ↩
- OpenAI,《Sharing AI progress in mathematics》,2026-10-06:https://openai.com/index/sharing-ai-progress-in-mathematics/ ↩
- Terence Tao,《SAIR Open Math OS released》,2026-10-16:https://terrytao.wordpress.com/2026/10/16/sair-open-math-os-released/ ↩
- Terence Tao,《Some of my recent talks and interviews》,2026-10-17:https://terrytao.wordpress.com/2026/10/17/some-of-my-recent-talks-and-interviews/ ↩
- Association for Human Mathematics,《AHM Statement on OpenAI’s October 6 Release of Mathematical Documents》,Terence Tao 博客转载,2026-10-07:https://terrytao.wordpress.com/2026/10/07/ahm-statement-on-openais-october-6-release-of-mathematical-documents/ ↩
- Advisory Group on Mathematics and Artificial Intelligence,《Announcing the Advisory Group on Mathematics and Artificial Intelligence》,Terence Tao 博客客座文,2026-09-21:https://terrytao.wordpress.com/2026/09/21/advisory-group-on-mathematics-and-artificial-intelligence/ ↩
- Deanna Needell、Hayden Schaeffer,《Call for stories: human–AI collaboration in recent mathematics》,Terence Tao 博客客座文,2026-10-14:https://terrytao.wordpress.com/2026/10/14/call-for-stories-human-ai-collaboration-in-recent-mathematics/ ↩
- 站内:《OpenAI 数学撤稿周:Lean 编译通过,到底证明了什么》:/cn/blog/ai-math-verification-lean-faithfulness/