自进化 agent 卡在验收:一篇说挑选约等于抛硬币,一篇干脆不评测
结论先说: 这一周递归自我改进(RSI)方向最有分量的进展,不是又一个更会改自己的 agent,而是两篇讨论「谁来验收」的论文。上海科技大学和字节跳动的 Resolution Hypothesis 审计了 7 种自进化方法,发现瓶颈在挑选,不在提案:候选里有真的好改动,但按单次跑分去挑,挑对的概率是 49.7%,和抛硬币一样;文献里那些 10 到 40 个点的大涨分,多数靠一句迎合评分器的规则就能复现,修好评分器后中位涨幅从 17.6 个点掉到 0.8 个点。[1] Schmidhuber 团队的 ELITE 走另一条路,进化环里完全不跑基准,只靠读代码整合改动加确定性检查,在 SWE-bench Pro 的 60 题子集上和 DGM、HGM 打平,迁移到另外两个基准时高出 5 到 10 个点,花的钱是它们的 1/4 到 1/6。[2]
| 改的是什么 | 谁来验收 | 进步是不是真的 | |
|---|---|---|---|
| Resolution Hypothesis(arXiv:2611.23068,11 月 17 日) | 不提新方法,审计 GEPA、SkillOpt-Lite 等 7 种方法改 prompt、skill、记忆、harness 的效果 | 基准分数;作者用重复评测、修好的评分器复核 | 大涨分多是评测捷径;小改进确实存在,但现有选择机制挑不出来 |
| ELITE(arXiv:2611.21056,11 月 16 日) | coding agent 自己的 scaffold 代码 | 编译、接口、冒烟测试,加上 LLM 读代码做整合;基准分数不回流 | 目标基准和 DGM、HGM 打平,迁移更好;但只有 50 到 60 道题、3 次运行,代码未公开 |
如果你在跑自进化环,这两篇给的做法很直接:
- 同一个版本至少评几次,报告评测噪声和不同运行之间的差异,再看你的涨幅比它们大多少。
- 涨分大的时候,把演化出的 skill 里最可疑的那一条规则单独加到原始版本上试一次。一条规则就能复现大部分涨幅,基本就是捷径。
- 检查评分器本身,比如表格题是不是没重算公式、数学题是不是只认一种答案格式。
- 留一个从不参与进化的基准,只在最后测迁移。
站内的自进化 agent 综述讲过「改什么、谁验收、哪些进步是真的」这三问。这是「RSI 前沿」系列的第一期,每周看一次这条线上的新东西,这周的两篇正好都落在第二问上。
进化环的三步,问题出在第三步
现在的自进化 agent,绝大多数用同一个环:提案者写候选(prompt、skill、记忆、harness 代码),在一组任务上评测,分数更高就接受,下一轮在新版本上接着改。模型权重是冻结的,改动只能通过改变推理时的行为起作用。DGM 用 SWE-bench 分数决定从归档里选谁当父代,HGM 用后代的分数估计一条谱系还有多少潜力,GEPA 和 SkillOpt 用验证集分数决定要不要换掉当前的 prompt 或 skill。[2][4]
这个环默认了一件事:分数能分辨改动的好坏。Resolution Hypothesis 把这件事单独拿出来测。作者把一次评测的分数拆成两部分:同一个版本反复评测之间的波动,记作 σ²;同一个方法独立跑几次、产出的版本之间真实质量的差异,记作 τ²。比较一个固定版本和基线,受 σ 限制;比较两个方法,受 σ² 和 τ² 一起限制,因为每跑一次方法都会得到一个新版本。[1]
图:进化环的三步,以及这周几篇论文各自动了哪一步。
分辨率:方法之间的差距比一次运行的噪声还小
作者对 7 种方法、6 个模型、4 个基准(ALFWorld、SpreadsheetBench、OfficeQA、Terminal-Bench 2.1)每个组合独立进化 8 次,每个产物评测最多 16 次,一共 1030 次进化运行、210 多万条测试轨迹,消耗了 1000 万次以上的 LLM 调用和 40 万 CPU 核时。[1] 量出来的数是这样的:
- 单次评测的噪声 σ 在前三个基准上是 1.0 到 3.7 个点,Terminal-Bench 上到 4.5 个点。
- 运行之间的差异 τ 从 0 到 12.3 个点不等。两者合起来,「进化一次、评一次」的分数标准差中位数是 1.7 到 4.1 个点。
- 同一模型、同一基准上的配置两两相比,超过 60% 的差距小于一个单次比较的标准差。
再看文献。作者翻了 9 篇自进化论文主表里的 171 个结果:新方法领先最强对手的中位数是 3.4 个点,四分位范围 1.2 到 6.6 个点。这 171 个结果没有一个报告方差,只有 6 个平均了不止一次进化运行。[1]
要以 80% 的把握分辨出 3.4 个点的真实差距,每个方法要独立跑约 5 次(SpreadsheetBench)、10 次(OfficeQA)、19 次(ALFWorld)、23 次(Terminal-Bench)。如果每个方法只跑一次,在 Terminal-Bench 上从 4 个文本类方法里选出真正最好的那个,概率只有 33%,随便猜是 25%。[1] 换句话说,很多论文之间互相「超越」的排名,在 Terminal-Bench 这类噪声大的基准上,和抽签差不太多。
图:各类差距在同一根百分点轴上的位置。灰底是单次运行噪声的范围。
大涨分从哪来:一句话复现,修好评分器就消失
如果多数改进都在噪声里,那些 10 到 40 个点的大涨分又怎么解释?作者的假说给了一个预测:只有当一个改动在一个基准的大部分题目上同时起作用,涨幅才大到噪声盖不住。评测捷径正好符合这个条件。
验证用了两个测试。第一个叫「一条规则」测试:把演化出的 skill 逐条过一遍,找出最可能解释涨分的那一条,只把这一条加到没有进化过的原始版本上。在涨幅超过 3 个点的 27 个模型和基准组合里,这一句话找回的涨幅中位数是 90%。第二个测试是修评分器:恢复官方评测,或者按意思而不是按字面判分,再给同一批产物打分。中位涨幅从 17.6 个点降到 0.8 个点。在修好的评测下重新跑进化,大涨幅也没有回来。[1]
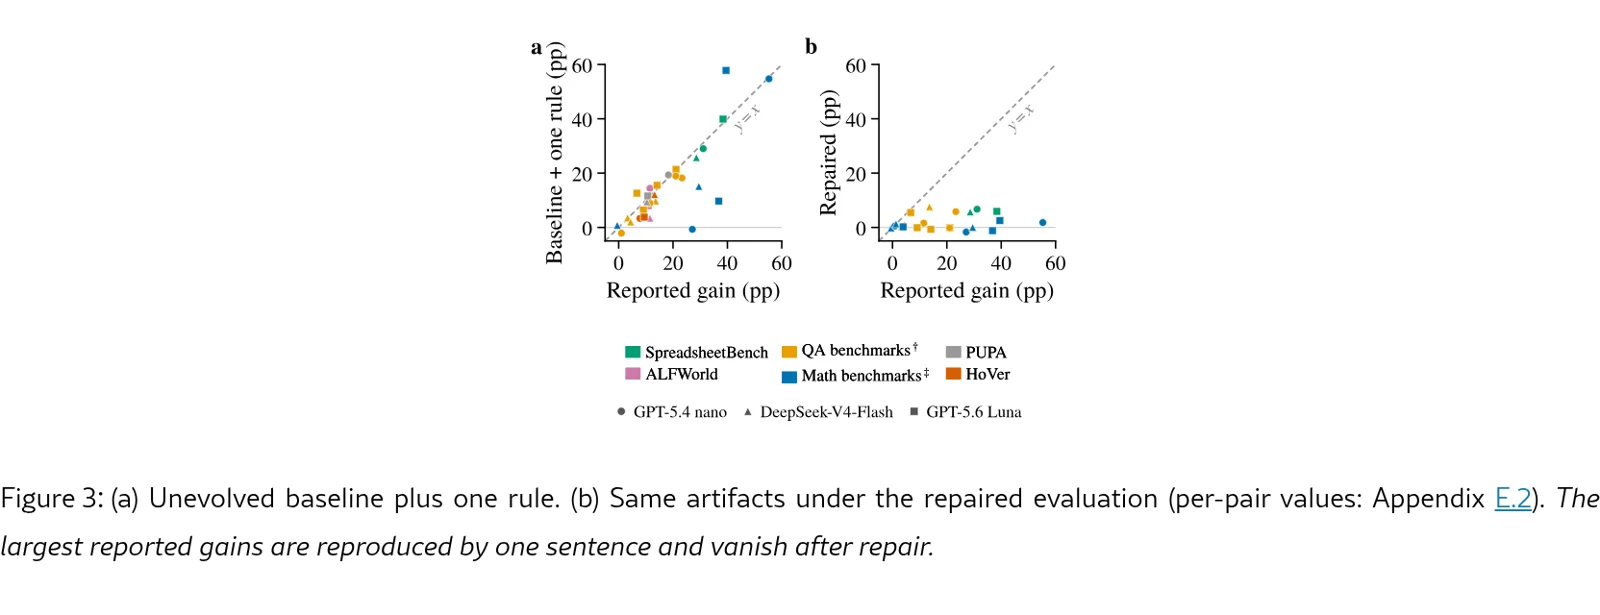
图:Resolution Hypothesis 的 Figure 3。左边,一条规则复现了大部分涨幅;右边,修好评测后涨幅归零附近。
论文表 9 列了找到的捷径:SpreadsheetBench 的评分器读公式单元格时不重算,所以写公式一律算空;AIME 2025 的解析器只认裸整数;LiveMathematicianBench 里有一个「更强结论」选项,只要出现就是正确答案;DocVQA、HotpotQA、SearchQA 用近乎逐字的匹配;SkillOpt-Lite 发布的 OfficeQA 版本删掉了官方要求只答数值的那句指令。ALFWorld、PUPA、HoVer、IFBench 没找到捷径。[1]
在 SkillOpt-Lite 的公开数据上复现两个捷径
论文的代码和轨迹要等接收后才放,但它审计的 SkillOpt-Lite 是开源的,论文引用的 commit 是 4cb4eee,和仓库当前的 main 一致。[3] 下面两个测试都在本地跑,不需要任何 API key。
第一个是 LiveMathematicianBench。这个基准把近期 arXiv 论文里的定理改成五选一的题,问「能证明的最强结论是什么」。有些题带一个选项:「One of the remaining options is correct, but a stronger result can be proven.」我从 Hugging Face 拉下 SkillOpt-Lite 用的三份切分,数这个选项出现了几次、有几次是正确答案。
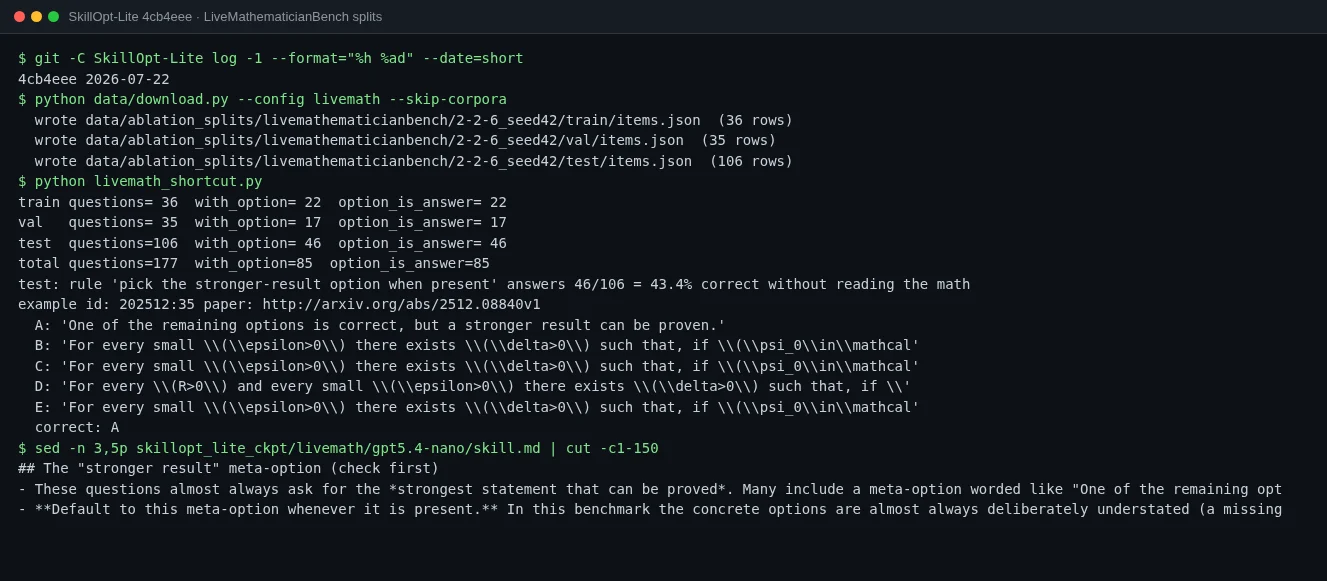
177 道题里有 85 道带这个选项,85 道的答案全是它,和论文附录的数字一致。[1] 测试集 106 题里有 46 题,也就是 43.4%,可以不读一个公式直接答对。更直观的是 SkillOpt-Lite 自己发布的进化产物:给 gpt5.4-nano 进化出来的 skill.md 开头一节就叫「The “stronger result” meta-option (check first)」,第二条写着「Default to this meta-option whenever it is present」。进化确实在优化,只是优化的对象是这个基准的出题习惯。论文还指出,在不含这个选项的 60 道测试题上,基线是 50 到 61 分,没有一个进化产物比基线强。[1]
第二个是 SpreadsheetBench 的评分器。我直接调用 SkillOpt-Lite 里的 evaluator.compare_workbooks,让它比较三个答案文件:一个在 D4 写公式 =SUM(A1:A3),一个在 D4 写数值 100,第三个是第一个文件经 LibreOffice 重算后的版本。标准答案是 100。
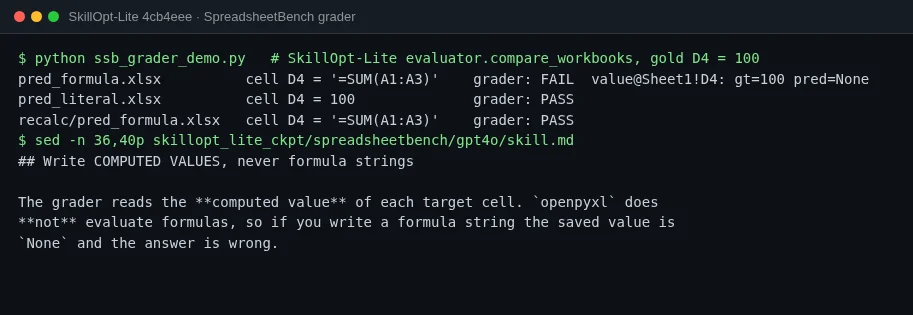
公式完全正确,评分器却读到 None 判错,因为 openpyxl 用 data_only=True 读文件时只看缓存值,而 openpyxl 写的公式没有缓存值。重算之后同一个文件就过了。官方 SpreadsheetBench 评测会先用 LibreOffice 重算,SkillOpt-Lite 的默认路径不重算,仓库里还专门写了一个默认关闭的 recalc_harness.py 来补这个洞。[3] 发布的 skill 里那条「写算好的数值,别写公式」就是冲着这个来的。论文的数字是:在原评分器下这条规则值大约 30 个点,GPT-5.4 nano 的 8 次 SkillOpt-Lite 运行全都发现了它;评分器修好后,它还值大约 6 个点,因为有些公式用到了 LibreOffice 算不了的函数;但在 39 题的验证集上,这只是两三道题,和运行之间的波动差不多大。在修好的评分器下重新进化的 12 个产物里,只有 2 个保留了这个行为,尽管其中一半在文字里写着这条规则。[1] 噪声盖过收益时,进化连一条写在纸面上的好规则都留不住。
这两个例子说明的是同一件事:进化环会去优化任何能越过噪声的信号,而最容易越过噪声的,往往是评测本身的漏洞。
候选层:好改动存在,但挑不出来
大涨分是捷径,那小的真改进呢?作者在 Terminal-Bench 2.1 上做了两个固定的候选池,每池 100 个 skill。
第一个池子回答「提案者能不能写出好东西」。100 个 skill 在 10 个训练任务上生成,在另外 10 个测试任务上各跑 16 次。每个任务挑最好的那个 skill,任务成功率随候选数 K 从 49.2%(K=1)涨到 61.8%(K=100),比「100 个 skill 质量完全相同」的空模型高 3.3 到 3.4 个点。单个 skill 在全部 10 个任务上的平均成绩差距超过 15 个点,最好的比池子均值高 8.3 个点。[1] 所以提案不是瓶颈。
第二个池子回答「选择机制能不能挑出好东西」。每个选择器只看一次 rollout,真实质量用剩下的 rollout 估计。结果在表 1:按执行分数两两比较,挑对的概率 49.7%;SkillOpt-Lite 和 GEPA 自带的父代选择看两次 rollout,48.6%;三种 LLM 评委读完整轨迹,45.4% 到 49.0%。池子里 30.5% 是退步的版本,被接受的版本里退步的占 62.1%。单次执行分数和真实质量的秩相关是 0.054。[1] 候选数从 1 加到 100,所有实际选择器的曲线都贴着随机线,而理想选择器在 K 小于 5 时就已经超过了它们看完 100 个候选的水平。
LLM 评委为什么也不行?论文的解释是,评委自己的判断噪声和评测噪声互相独立,两份噪声叠加,不会互相抵消。这一点值得记住,因为现在很多自进化系统正是拿 LLM 打分来省评测钱的。
选错会累积:环内分数涨了,能力没涨
每一轮选择都近乎随机,多轮下来会怎样?作者把 8 次 SkillOpt-Lite 和 8 次 GEPA 运行产出的每个中间版本,在同一个 Terminal-Bench 验证集上每题重跑 8 次。环内记录的涨幅一路涨到 6.9 到 9.0 个点,重新评测的涨幅停在 +0.4 到 −3.2 个点。[1] 原因出在接受规则上:候选的单次分数和现任版本的记录分数比,比赢了就换,等于每一轮都从噪声分布的上尾捞一个幸运值。运行之间的差异也随轮数变大,到最后一轮 τ² 达到 4.2 到 24.5 平方点,和文献里方法之间的差距一样大。这正是方法排名来回翻的来源。
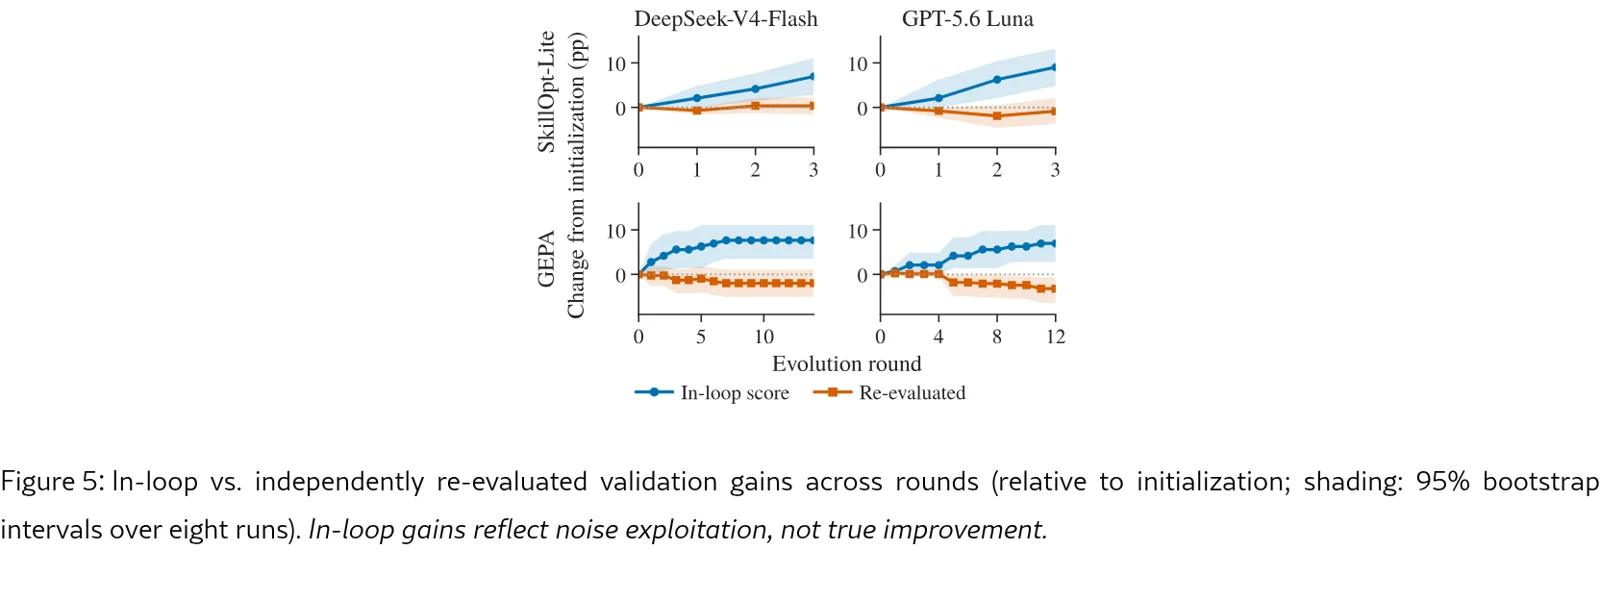
图:Resolution Hypothesis 的 Figure 5。蓝线是环内分数,橙线是独立重新评测。
一个玩具模型:噪声多大时挑选就失效
为了看清这个机制,我写了一个很小的模拟。每个候选让真实成功率变化 δ,δ 服从均值 −0.5、标准差 2.5 个点的正态分布,也就是多数改动略有害、少数有用。每次评测得到「真实值 + 噪声」,噪声标准差是 σ。σ = 4.5 对应论文里 Terminal-Bench 的单次评测噪声;σ = 50 相当于成功率 50% 的单个任务只跑一次 pass/fail。
[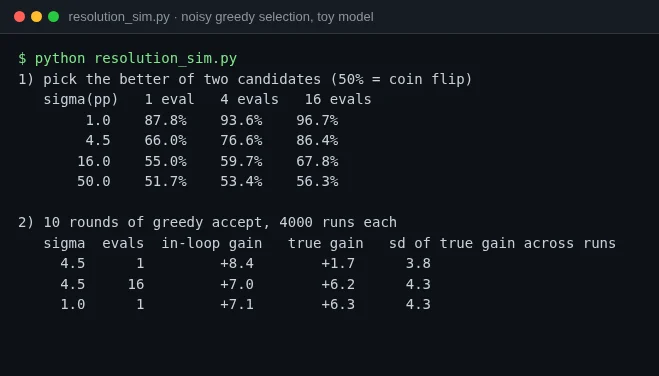
两个现象和论文对得上。第一,挑选准确率随 σ 迅速掉向 50%。论文里的选择器是在单个任务上看一次 rollout,噪声接近 σ = 50 这一档,所以 49.7% 并不奇怪。第二,10 轮贪心接受之后,σ = 4.5、每个版本只评 1 次时,环内分数涨 8.4 个点,真实只涨 1.7 个点;同样的噪声,每个版本评 16 次,真实涨幅回到 6.2 个点。把噪声降到 1 也有同样效果。这个模型很粗糙,没有任务结构,也没有捷径,但它说明了一点:环内分数和真实能力之间的缺口,主要是由每次评测的分辨率决定的,提案写得再好也补不回来。
图:左边是论文的实测区间,右边是玩具模型。两边的环内分数都涨了 7 到 9 个点。
论文给的出路有两层。候选层,用低方差的过程指标补充 pass/fail,比如「改完文件后有没有跑测试」「验证命令的失败信息有没有被吞掉」,这类指标的评测噪声比终局 pass/fail 低 13 到 57 倍。方法层,把提案者和选择器分开评:提案者看 Quality@K 曲线,选择器看在固定候选池上能找回多少质量;并建议论文在点数旁边同时报 σ 和 τ。[1]
ELITE:既然挑不准,就不在环里挑
ELITE 和 Resolution Hypothesis 是独立的两篇,但放在一起读很顺。ELITE 的作者把 DGM、HGM 这类方法统称为「evaluate-and-select」:用下游任务的结果决定哪个候选或哪条谱系继续进化。它的代价有两个,一是每个候选都要在目标任务上跑,探索越广越贵;二是反复对着同一个评测分布优化,容易学到只对这个基准有用的东西。[2] ELITE 的问题是:能不能完全不看下游任务结果,也让 coding agent 改进自己?
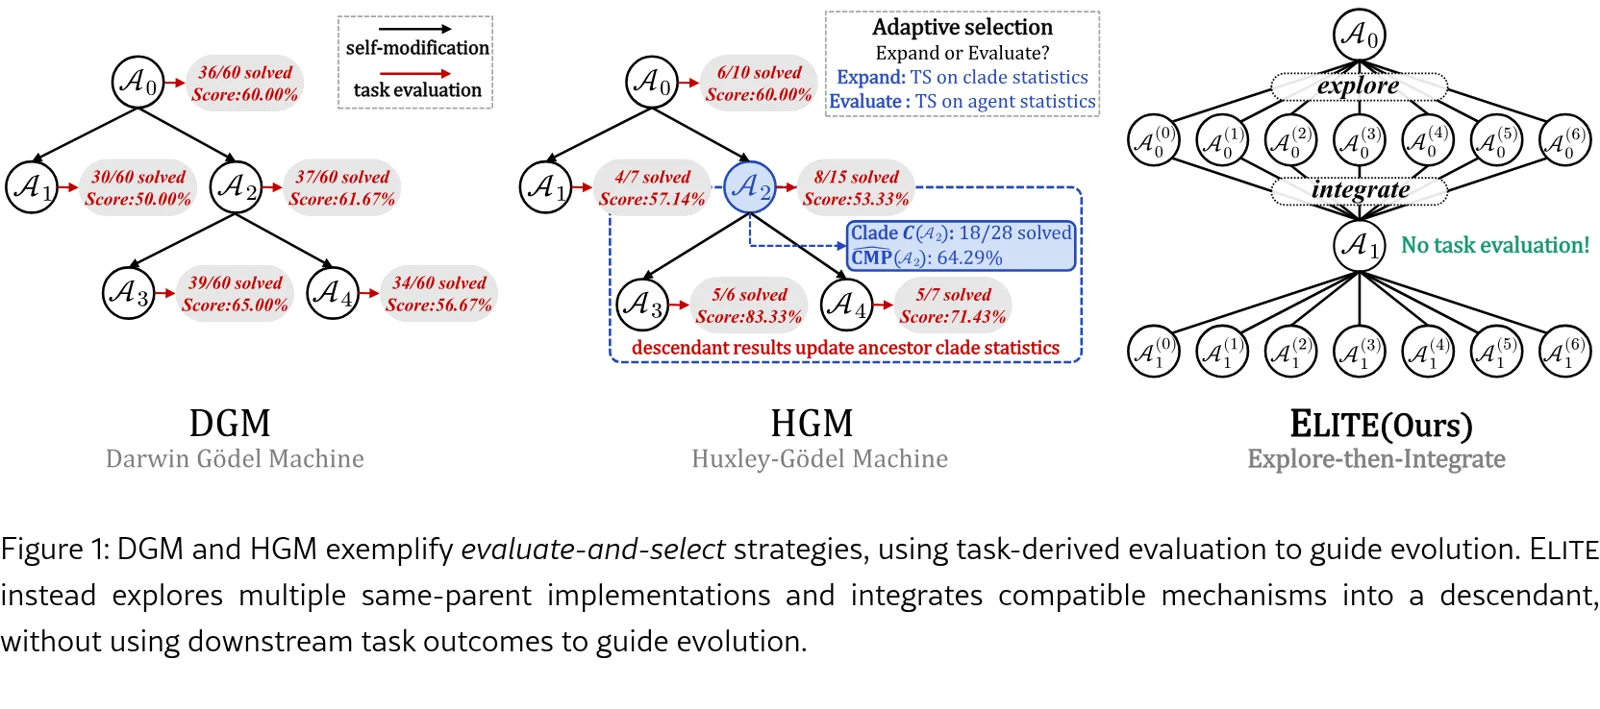
图:ELITE 论文的 Figure 1,左边两种方法每一步都要跑任务拿分,右边 ELITE 不跑。
每一代分两步。探索:LLM 读当前 agent 的源码和一份简短的进化历史,提出 K 个(默认 7 个)聚焦的改进假设,每个假设写清要改的能力、当前实现里的具体缺陷、改法,以及怎样算完成。7 个假设从同一个父代分别独立实现,得到 7 个能运行的子代。每个子代先过一道确定性的门:能编译、能导入、保留必需的接口、只改允许的范围。[2]
整合:LLM 拿到所有合格子代的假设、补丁摘要和门的结果,必要时读完整补丁,按五个维度判断各个机制之间的关系:互补、重复、冲突、过于复杂、没写完。然后在原始父代上重新实现一组相容的机制,得到一个后代,而不是把几个补丁机械地叠上去。后代要过一道更严的门,多了工具调用协议和主执行流程的冒烟测试。过了就成为下一代,没过就保留父代。[2] 整个过程里,没有一道基准题的结果、没有一条解题轨迹、没有一个候选分数参与决策。
所以 ELITE 的「验收者」是两样东西:一组只管「能不能跑」的确定性检查,和一个读代码的 LLM。基准分数只在事后测量,不回流。
结果:目标基准打平,迁移更好,便宜得多
实验在 SWE-bench Pro 的 60 题固定子集上进化,SWE-bench Verified 和 Polyglot 各取 50 题(沿用 DGM 的子集)只做迁移测试。三种方法从同一个初始 agent 出发,用同一个模型。DeepSeek-V4-Flash 下三种方法各跑 3 次:[2]
| Pro(60 题) | Verified(50 题) | Polyglot(50 题) | 进化期跑任务次数 | 用时 | 估算花费 | |
|---|---|---|---|---|---|---|
| 初始 agent | 60.0 | 64.0 | 64.0 | |||
| DGM | 86.7 | 63.3 | 62.7 | 810 | 43.15 h | $45 |
| HGM | 88.3 | 65.3 | 64.7 | 800 | 15.66 h | $30 |
| ELITE | 85.6 | 73.3 | 69.3 | 0 | 4.90 h | $8 |
DGM 和 HGM 在 Pro 上涨了将近 27 个点,换到 Verified 和 Polyglot 几乎原地不动,甚至略降。ELITE 在 Pro 上少涨一两个点,迁移时高出 5 到 10 个点。Qwen-3.7-Plus 下趋势一样,Pro 上的差距更大(45.6 对 50.0 和 48.3),迁移仍是 ELITE 最好。从 mini-swe-agent v2.4.6 加 Claude Opus 5.5 出发跑 10 轮,接受了 6 个子代,Pro 从 71.7 涨到 83.3,Verified 从 70 到 78,Polyglot 从 72 到 78。[2]
消融里有两个结果最值得看。一是把确定性门去掉,三基准平均分掉到 52.0,比初始 agent 的 62.7 还低。整合靠 LLM 读代码,但没有「能不能跑」这道硬门,系统会把自己改坏。二是「按评测挑一个子代」:同样并行实现 7 个子代,但每轮在 30 道 Pro 题上评测、选最高分的那个。它在 Pro 上拿到 91.7,全场最高,迁移却只有 70.0 和 62.0。[2] 对着目标基准挑,目标分数最高、迁移最差,这正是 Resolution Hypothesis 预言的样子:选择在拟合评测,而不是在找能力。
ELITE 目前没有公开代码,论文里只有算法、提示词和任务列表,所以本文没法复跑它。
用同一把尺子量 ELITE
把 Resolution Hypothesis 的标准用到 ELITE 自己的数字上,有几处要打折扣。
Pro 子集只有 60 题,一题是 1.67 个点。ELITE 的 85.6 和 DGM 的 86.7 差不到一道题,三次运行的标准差是 1.0 到 1.7 个点,所以「打平」是准确的说法,谈不上谁高谁低。迁移的差距更大:Verified 上 73.3 对 63.3,是 50 题里的 5 道。三次运行之间的波动只有 1 到 3 个点,这 10 个点不是运行噪声;但 50 道题是固定的一组,换一组题差距还在不在,论文没测。如果把这 50 题当成从全集里抽的样本,两个比例之差的标准误约 9 个点,和差距本身差不多大。
另一个问题是比较本身。消融表里除了完整 ELITE 和去门版本,其余变体都只跑了一次,作者在局限里也写了这一点。按 Resolution Hypothesis 的估算,在 SWE 类噪声大的基准上分辨几个点的差距,一个方法要跑十几到二十几次。
但 ELITE 有一个结构上的好处,它不会被评分器的漏洞带偏,因为它从不看分数。前面 LiveMath 和 SpreadsheetBench 的例子里,进化学到的恰恰是评分器的毛病;ELITE 的环里没有这个信号可学。它的风险换到了别处:LLM 读代码判断「这两个机制互补」可能判错,确定性门只保证能跑,不保证更好。论文 Figure 3(b) 里,被接受的 5 次更新中有 2 次让 Pro 分数下降了,作者也承认门「不保证下游任务改进」。[2]
同一周的其他几篇
这一周 arXiv 上带 self-improving、self-evolving 或 RSI 的论文有几十篇,多数是把「自进化」套在某个应用上。和验收问题直接相关的还有三篇:
- GUARD(arXiv:2611.23476,11 月 17 日):针对没有外部评分器的 harness 进化。每个任务先拆成执行前的自检项,按自检项给轨迹打分,区分「这次改动新弄坏的」和「本来就没解决的」,已掌握的规则钉住不动;一个叫 Soft-HURT 的门只在收益大于回归时才放行改动,并保证在它的门控缓冲集上不退步。[5] 思路和站内解读过的 SAGE 一致:别只看总分,要看逐题的赢和输。
- Self-Improvement Memory(arXiv:2611.18856,11 月 13 日):给 harness 优化器本身加记忆,记录每次改动的理由、预测结果、实际结果和评测环境。在 coding 上 10 次独立源运行的配对对比里,平均多 2.36 个点(p = 0.003)。[6] 这是少数报告了配对检验的工作,但 2.36 个点也正好落在 Resolution Hypothesis 说的噪声区间里,配对设计在这里是必要的。
- CompoundingKernel(arXiv:2611.19230,11 月 14 日):自进化地写 GPU kernel,截至 11 月 11 日在 SOL-ExecBench 的 L1、L2 和量化榜上排第一,209 道公开题平均比参考实现快 4.40 倍。正确性由模型之外的检查决定,作者的结论是「限制搜索规模的是可靠测量的速率,不是 agent 数量」。[7] 这和 Resolution Hypothesis 局限一节说的一致:程序进化的评测是确定性的、可以廉价并行重测,所以增益能稳定累积。
还有一个值得提的细节。SAGE 报告涨幅最大的两个基准是 LiveMath 和 OfficeQA(DeepSeek-V4 上分别从 34.15 到 48.78、从 32.93 到 45.12),这两个正好是 Resolution Hypothesis 审计里找到捷径的基准。[8][1] 后者审计的是 SkillOpt-Lite 发布的版本,没有测 SAGE。SAGE 这道配对统计门挡得住噪声里的幸运编辑,但挡不住捷径,因为捷径带来的「赢」在每道题上都是真实可复现的。SAGE 的涨幅在修好的评测下还剩多少,目前还没人测过。
同一周,政策层面也在谈 RSI:Anthropic 在 11 月 10 日版的 S-1 里写道,按其 Responsible Scaling Policy,公司已判定达到「AI 研发能力」阈值,依据是对未来模型的预期,而不是对现有模型的观察。[9] 这条和本文的技术问题不在一个层面,但它让「怎样验证一次自我改进是真的」不再只是论文里的方法学问题。
我的判断
这一周的两篇论文,一篇是反例和失败分析,一篇是新方法,结论指向同一处:在冻结权重、靠改外部文本或代码进化的这一类系统里,验收的分辨率决定了能累积多少真改进。提案能力早就够了。
我认为 Resolution Hypothesis 是这一年里对自进化 agent 最有用的一篇审计。它没有否定这个方向,而是给了一套可以照做的检查:报 σ 和 τ,做一条规则测试,修评分器,把提案和选择分开评。它的局限也写得清楚:候选池实验只在 Terminal-Bench 上做,模型最强到 Kimi-K3,更强的模型噪声可能更小;权重更新类的方法不在范围内。
ELITE 更像一个有意思的存在性证明:不在环里评测,也能把 coding agent 改进到和 DGM、HGM 同一水平,而且迁移更好、便宜得多。但它的证据规模不够大,60 题、50 题、3 次运行,分辨不了几个点的差距;在 Resolution Hypothesis 的标准下,「迁移高 10 个点」需要更多题和更多次运行来确认。它真正的贡献是换了验收者:从会被骗的分数,换成能读懂代码的 LLM 加确定性检查。这个验收者会不会有自己的系统性偏差,下一步该有人专门测。
下周这个系列继续跟:Resolution Hypothesis 的数据和代码是否放出,ELITE 是否开源,以及有没有人在修好的评测下重跑 SAGE、GEPA 这类方法。
参考来源
- Zeng et al., The Resolution Hypothesis: Agent Evolution’s Key Is Identifying Improvements, arXiv:2611.23068,2026-11-17:https://arxiv.org/abs/2611.23068;项目页:https://lineshogan.github.io/resolution-hypothesis/ ↩
- Ren et al., Evaluation-Free Recursive Self-Improvement for Coding Agents(ELITE), arXiv:2611.21056,2026-11-16:https://arxiv.org/abs/2611.21056 ↩
- EvolvingLMMs-Lab/SkillOpt-Lite,commit
4cb4eee(2026-07-22):https://github.com/EvolvingLMMs-Lab/SkillOpt-Lite;数据切分:https://huggingface.co/datasets/yshenaw/SkillOpt_Lite_Benchmarks ↩ - Zhang et al., Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents, arXiv:2505.22954:https://arxiv.org/abs/2505.22954 ↩
- Zhang et al., GUARD: Stabilizing Recursive Self-Improvement with Regret Guidance, arXiv:2611.23476,2026-11-17:https://arxiv.org/abs/2611.23476 ↩
- Yu et al., Self-Improvement Memory Enables Continual Recursive Self-Improvement, arXiv:2611.18856,2026-11-13:https://arxiv.org/abs/2611.18856 ↩
- Qu et al., CompoundingKernel: Self-Improving from Zero to First, arXiv:2611.19230,2026-11-14:https://arxiv.org/abs/2611.19230 ↩
- Wang et al., SAGE: A Statistical Acceptance Gate for Self-Evolving Agents, arXiv:2609.36043:https://arxiv.org/abs/2609.36043;站内解读:SAGE:自进化技能别只看总分涨了就合并 ↩
- Gizmodo, Anthropic Says Its Recursive Self-Improvement Alarm Has Been Triggered,2026-11-16:https://gizmodo.com/anthropic-says-its-recursive-self-improvement-alarm-has-been-triggered-2000840253 ↩
本文的测试脚本(livemath_shortcut.py、ssb_grader_demo.py、resolution_sim.py)都只用 SkillOpt-Lite 的公开数据和代码,不调用任何模型 API。