自己進化エージェントは受け入れ判定で止まっている:選択はコイン投げだという論文と、評価をやめた論文
結論から: 今週の再帰的自己改善(RSI)で最も重要だったのは、自分をうまく書き換える新しいエージェントではなく、「誰が受け入れを判断するか」を扱った 2 本の論文だった。上海科技大学と ByteDance の Resolution Hypothesis は 7 つの自己進化手法を監査し、ボトルネックは提案ではなく選択にあると示した。候補の中には本当に良い変更があるのに、1 回の実行結果で選ぶと良い方を選ぶ確率は 49.7%、つまりコイン投げと同じだ。文献にある 10〜40 ポイントの大きな伸びの多くは、採点器に合わせた 1 文のルールで再現でき、採点器を直すと伸びの中央値は 17.6 ポイントから 0.8 ポイントに落ちる。[1] Jürgen Schmidhuber のグループによる ELITE は逆の道を選んだ。進化ループの中ではベンチマークを一切回さず、コードを読んで変更を統合し、動くかどうかだけを確かめる。SWE-bench Pro の 60 問の部分集合では DGM・HGM と並び、2 つの転移先ベンチマークでは 5〜10 ポイント上回り、費用は 1/4〜1/6 だった。[2]
| 何を変えるか | 誰が受け入れを判断するか | 進歩は本物か | |
|---|---|---|---|
| Resolution Hypothesis(arXiv:2611.23068、11 月 17 日) | 新手法はない。GEPA や SkillOpt-Lite など 7 手法が prompt、skill、メモリ、harness を進化させた効果を監査 | ベンチマークの点数。著者は評価の反復と修理した採点器で検証し直した | 大きな伸びの多くは評価の抜け穴。小さな本物の改善はあるが、今の選択の仕組みでは見つけられない |
| ELITE(arXiv:2611.21056、11 月 16 日) | コーディングエージェント自身の scaffold のコード | ビルド、インターフェース、スモークテストと、コードを読んで統合する LLM。点数は進化に戻らない | 対象ベンチマークでは DGM・HGM と並び、転移は上。ただし 50〜60 問、3 回の実行で、コードは未公開 |
自己進化ループを回しているなら、2 本の論文から次の 4 つが言える。
- 同じ版を何度か評価し、評価ノイズと実行間のばらつきを報告し、伸びがそれよりどれだけ大きいかを見る。
- 伸びが大きいときは、進化した skill の中で一番怪しいルールを 1 つだけ元の版に足して試す。1 つのルールで伸びの大半が戻るなら、ほぼ抜け穴だ。
- 採点器そのものを確かめる。表計算の採点器が数式を再計算しているか、数学の採点器が答えの書式を 1 種類しか認めていないか、など。
- 進化に一切使わないベンチマークを 1 つ残し、最後の転移テストにだけ使う。
このサイトの自己進化エージェントのサーベイでは「何を変えるか、誰が受け入れを判断するか、どの進歩が本物か」の 3 つを問うた。本稿は「RSI フロンティア」シリーズの第 1 回で、この分野を毎週 1 回追う。今週の 2 本はどちらも 2 つ目の問いに当たる。
ループは 3 段階、失敗しているのは 3 段階目
今の自己進化エージェントは、ほとんどが同じループを使っている。提案者が候補(prompt、skill、メモリ、harness のコード)を書き、タスク群で評価し、点数が高ければ採用し、次の回は新しい版を改造する。モデルの重みは固定なので、変更は推論時のふるまいを変えることでしか効かない。DGM は SWE-bench の点数でアーカイブから親を選び、HGM は子孫の点数から系統の伸びしろを見積もり、GEPA と SkillOpt は検証セットの点数で今の prompt や skill を置き換えるかを決める。[2][4]
このループは「点数で変更の良し悪しを見分けられる」ことを前提にしている。Resolution Hypothesis はこの前提を直接テストした。著者は点数の分散を 2 つに分ける。1 つは同じ版を繰り返し評価したときのぶれで、σ² と書く。もう 1 つは同じ手法を独立に何回か走らせたとき、できた版の真の品質がどれだけ違うかで、τ² と書く。固定した 1 つの版をベースラインと比べるときは σ が限界を決める。2 つの手法を比べるときは σ² と τ² の両方が効く。手法を 1 回走らせるたびに新しい版ができるからだ。[1]
図:ループの 3 段階と、今週の論文がそれぞれ手を入れた段階。
分解能:手法間の差は 1 回の実行のノイズより小さい
著者は 7 手法、6 モデル、4 ベンチマーク(ALFWorld、SpreadsheetBench、OfficeQA、Terminal-Bench 2.1)の組み合わせごとに進化を 8 回走らせ、各成果物を最大 16 回評価した。合計 1030 回の進化実行、210 万本以上のテスト軌跡、1000 万回以上の LLM 呼び出し、40 万 CPU コア時間だ。[1] 測った値は次のとおり。
- 1 回の評価のノイズ σ は、最初の 3 つのベンチマークで 1.0〜3.7 ポイント、Terminal-Bench で 4.5 ポイント。
- 実行間のばらつき τ は 0〜12.3 ポイント。合わせると「1 回進化して 1 回評価」の標準偏差の中央値は 1.7〜4.1 ポイント。
- 同じモデル・同じベンチマークの構成を 2 つずつ比べると、60% 以上の組で差が 1 回の比較の標準偏差より小さい。
次に文献を見る。著者は自己進化の論文 9 本の主要な表から 171 件の結果を集めた。新手法が最強の比較相手につける差の中央値は 3.4 ポイント、四分位範囲は 1.2〜6.6 ポイント。171 件のどれも分散を報告しておらず、複数回の進化実行を平均したものは 6 件だけだった。[1]
3.4 ポイントの本当の差を検出力 80% で見分けるには、各手法を独立に約 5 回(SpreadsheetBench)、10 回(OfficeQA)、19 回(ALFWorld)、23 回(Terminal-Bench)走らせる必要がある。各手法 1 回だけだと、Terminal-Bench で 4 つのテキスト系手法から本当に一番良いものを選べる確率は 33% で、当てずっぽうなら 25% だ。[1] Terminal-Bench のようにノイズの大きいベンチマークでは、論文同士の「上回った」という順位の多くはくじ引きに近い。
図:さまざまな差を同じパーセントポイントの軸に並べた。灰色の帯は 1 回の実行のノイズ。
大きな伸びの出どころ:1 文で再現でき、採点器を直すと消える
改善の多くがノイズに埋もれるなら、10〜40 ポイントの伸びはどう説明するのか。この仮説は予測を立てる。伸びがノイズを超えるほど大きくなるのは、1 つの変更がベンチマークの大半の問題に同時に効くときだけだ。評価の抜け穴はちょうどその条件を満たす。
著者は 2 つのテストで確かめた。1 つ目は「1 ルール」テスト。進化した skill を 1 行ずつ読み、伸びを説明しそうなルールを 1 つ選び、それだけを進化前のベースラインに足す。伸びが 3 ポイントを超える 27 のモデルとベンチマークの組で、この 1 文が取り戻した伸びの中央値は 90% だった。2 つ目は採点器の修理。公式の評価に戻すか、字面ではなく意味で採点して、同じ成果物を採点し直した。伸びの中央値は 17.6 ポイントから 0.8 ポイントに下がった。修理した評価の下で進化をやり直しても、大きな伸びは戻らなかった。[1]
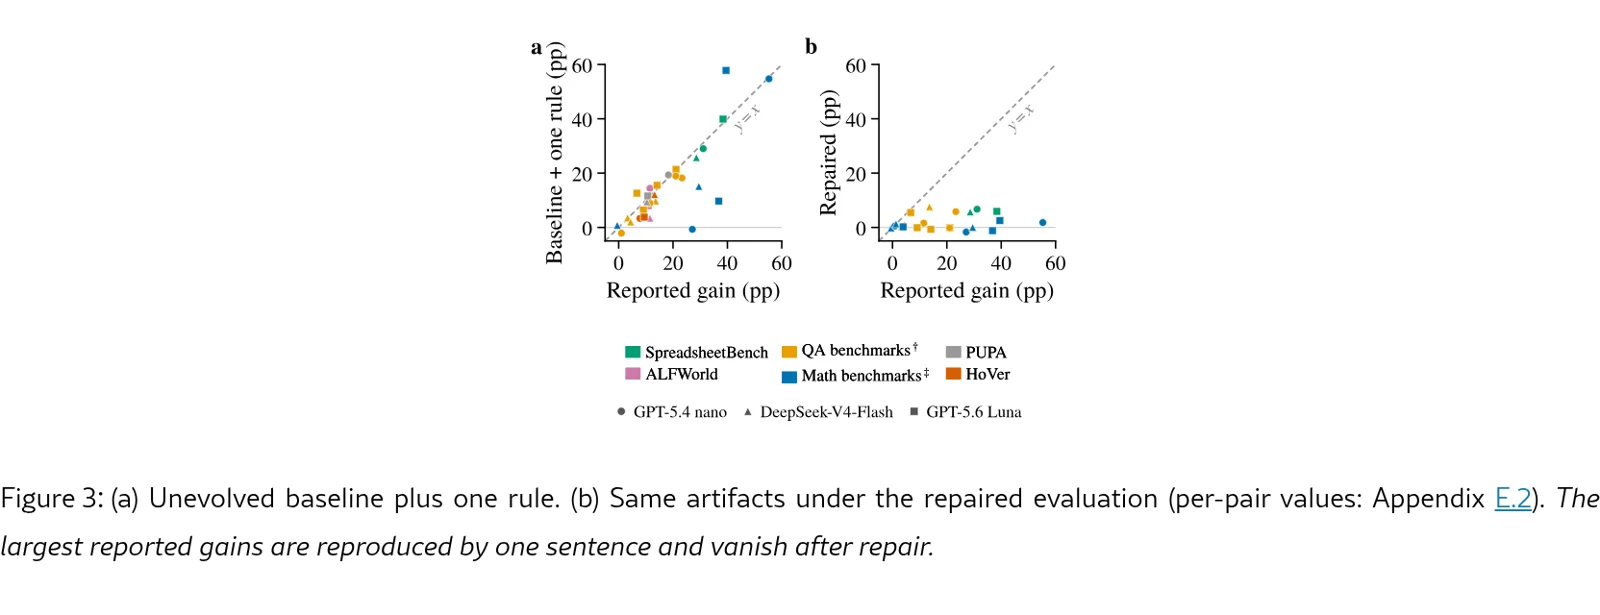
図:Resolution Hypothesis の Figure 3。左は 1 ルールで伸びの大半が再現されること、右は修理後に伸びがほぼ消えることを示す。
論文の表 9 には見つかった抜け穴が並ぶ。SpreadsheetBench の採点器は数式セルを再計算せずに読むので、数式はすべて空として採点される。AIME 2025 のパーサーは素の整数しか受け付けない。LiveMathematicianBench には「より強い結果」という選択肢があり、出てくれば必ず正解だ。DocVQA、HotpotQA、SearchQA はほぼ完全一致の文字列照合を使う。SkillOpt-Lite が公開した OfficeQA 版は「数値だけで答えよ」という公式の指示を落としている。ALFWorld、PUPA、HoVer、IFBench では抜け穴は見つからなかった。[1]
SkillOpt-Lite の公開データで抜け穴を 2 つ再現する
論文のコードと軌跡は採択後に公開される予定だ。一方、監査対象の SkillOpt-Lite はオープンソースで、論文が引用するコミット 4cb4eee は今の main ブランチと同じだ。[3] 以下の 2 つのテストはローカルで動き、API キーは要らない。
1 つ目は LiveMathematicianBench。最近の arXiv 論文の定理を 5 択の問題にし、「証明できる最も強い主張はどれか」を問うベンチマークだ。一部の問題には「One of the remaining options is correct, but a stronger result can be proven.」という選択肢がある。スクリプトは SkillOpt-Lite が使う 3 つの分割を Hugging Face から読み込み、この選択肢が何回出て、何回正解なのかを数える。
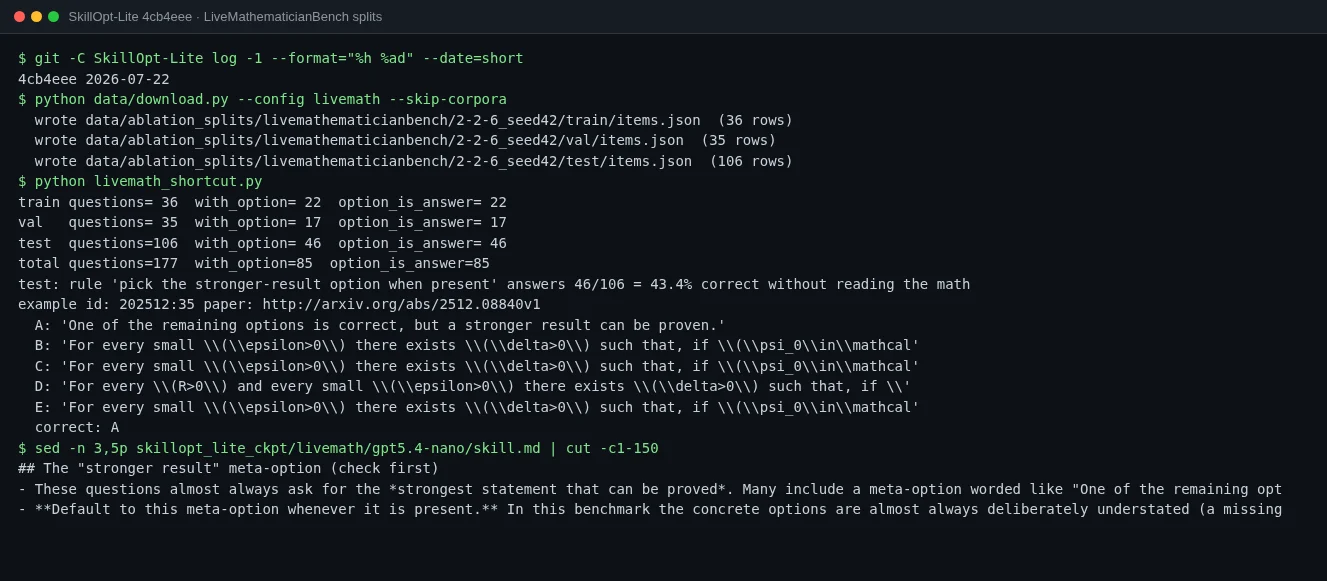
177 問中 85 問にこの選択肢があり、85 問すべてで正解だった。論文の付録と同じ数字だ。[1] テスト分割の 106 問のうち 46 問(43.4%)は、数式を 1 つも読まずに正解できる。SkillOpt-Lite 自身が公開した成果物を見るとさらにはっきりする。gpt5.4-nano 用に進化した skill.md は「The “stronger result” meta-option (check first)」という節で始まり、2 つ目の項目には「Default to this meta-option whenever it is present」とある。進化はたしかに何かを最適化した。最適化されたのは、このベンチマークの問題の作り方だった。論文によれば、この選択肢を含まない 60 問のテスト問題では、ベースラインは 50〜61 点で、ベースラインを上回る成果物は 1 つもなかった。[1]
2 つ目は SpreadsheetBench の採点器。スクリプトは SkillOpt-Lite の evaluator.compare_workbooks を 3 つの解答ファイルに対して呼ぶ。1 つ目は D4 に数式 =SUM(A1:A3) を書いたもの、2 つ目は D4 に数値 100 を書いたもの、3 つ目は 1 つ目を LibreOffice で再計算したもの。正解は 100 だ。
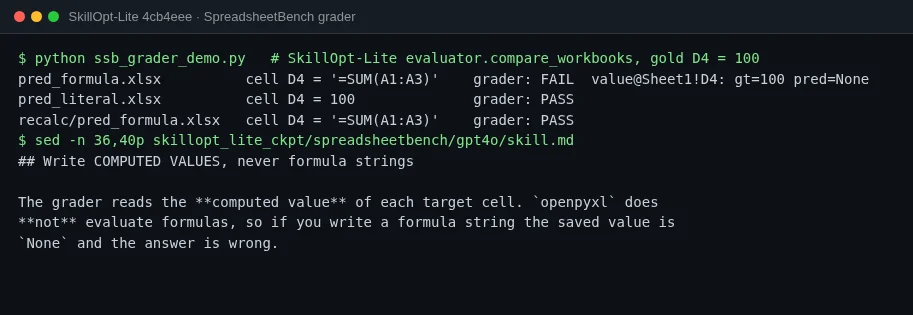
数式は正しいのに、採点器は None を読んで不正解にする。openpyxl は data_only=True で読むとキャッシュされた値しか見ず、openpyxl が書いた数式にはキャッシュ値がないからだ。再計算すると同じファイルが通る。公式の SpreadsheetBench 評価は先に LibreOffice で再計算する。SkillOpt-Lite の既定の経路は再計算せず、リポジトリにはこの穴を埋めるための、既定では無効な recalc_harness.py まで入っている。[3] 公開された skill の「計算済みの値を書け、数式は書くな」というルールは、この穴を狙ったものだ。論文の数字では、公開版の採点器の下でこのルールは約 30 ポイントの価値があり、GPT-5.4 nano での SkillOpt-Lite の 8 回の実行はすべてこれを見つけた。採点器を直した後も約 6 ポイントの価値が残る。LibreOffice が計算できない関数を使う数式があるからだ。ただし 39 問の検証セットでは 2〜3 問分で、実行間のばらつきと同じくらいの大きさしかない。修理した採点器の下で進化し直した 12 の成果物のうち、このふるまいを保ったのは 2 つだけで、半数は本文にこのルールを書いていたのに守らなかった。[1] ノイズが効果より大きいと、進化は紙に書いた良いルールさえ保てない。
2 つの例が示すことは同じだ。進化ループはノイズを越えるどんな信号でも最適化し、最もたやすくノイズを越えるのは、評価そのものの欠陥であることが多い。
候補レベル:良い変更はあるのに、選べない
大きな伸びが抜け穴なら、小さな本物の改善はどうか。著者は Terminal-Bench 2.1 で、100 個の skill からなる固定の候補プールを 2 つ作った。
1 つ目のプールは「提案者は良いものを書けるか」に答える。100 個の skill を 10 個の訓練タスクから作り、別の 10 個のテストタスクでそれぞれ 16 回走らせた。タスクごとに一番良い skill を選ぶと、成功率は K=1 の 49.2% から K=100 の 61.8% まで上がり、「100 個すべてが同じ品質」というヌルモデルより 3.3〜3.4 ポイント高い。10 タスクの平均で見ても skill 同士の差は 15 ポイントを超え、最も良いものはプール平均より 8.3 ポイント高い。[1] 提案はボトルネックではない。
2 つ目のプールは「選択の仕組みは良いものを選べるか」に答える。各選択器は 1 回のロールアウトだけを見て、真の品質は残りのロールアウトで推定する。結果は表 1 にある。実行スコアで 2 つを比べると、良い方を選ぶ確率は 49.7%。SkillOpt-Lite と GEPA の親選択は 2 回のロールアウトを見て 48.6%。軌跡全体を読む 3 種類の LLM 審査は 45.4〜49.0%。プールの 30.5% は退行した版なのに、採用された版の 62.1% が退行版だった。1 回の実行スコアと真の品質の順位相関は 0.054。[1] 候補数を 1 から 100 に増やしても、実際の選択器の曲線はすべてランダムの線に張り付いたままで、理想の選択器は K が 5 になる前に、それらが 100 候補を見たときの水準を超える。
なぜ LLM 審査もだめなのか。論文の説明では、審査者の読み取りのノイズは評価ノイズと独立なので、2 つは打ち消し合わずに足し算になる。多くの自己進化システムが評価コストを節約するために LLM 採点を使っているので、この点は覚えておく価値がある。
選択の誤りは積み重なる:ループ内の点数は上がり、実力は上がらない
1 回ごとの選択がほぼランダムなら、何回も繰り返すとどうなるか。著者は SkillOpt-Lite 8 回と GEPA 8 回の実行で生まれたすべての途中版を、同じ Terminal-Bench 検証セットで各問 8 回ずつ走らせ直した。ループ内で記録された伸びは 6.9〜9.0 ポイントまで上がったが、再評価した伸びは +0.4〜−3.2 ポイントにとどまった。[1] 原因は採用ルールにある。候補の 1 回の点数を現行版の記録上の点数と比べ、上回れば入れ替える。これは毎回、ノイズ分布の上側の裾から運の良い値をすくい上げることになる。実行間のばらつきも回を追うごとに広がり、最後の回では τ² が 4.2〜24.5 ポイントの 2 乗に達して、文献での手法間の差と同じ大きさになる。手法の順位が入れ替わり続けるのはこのためだ。
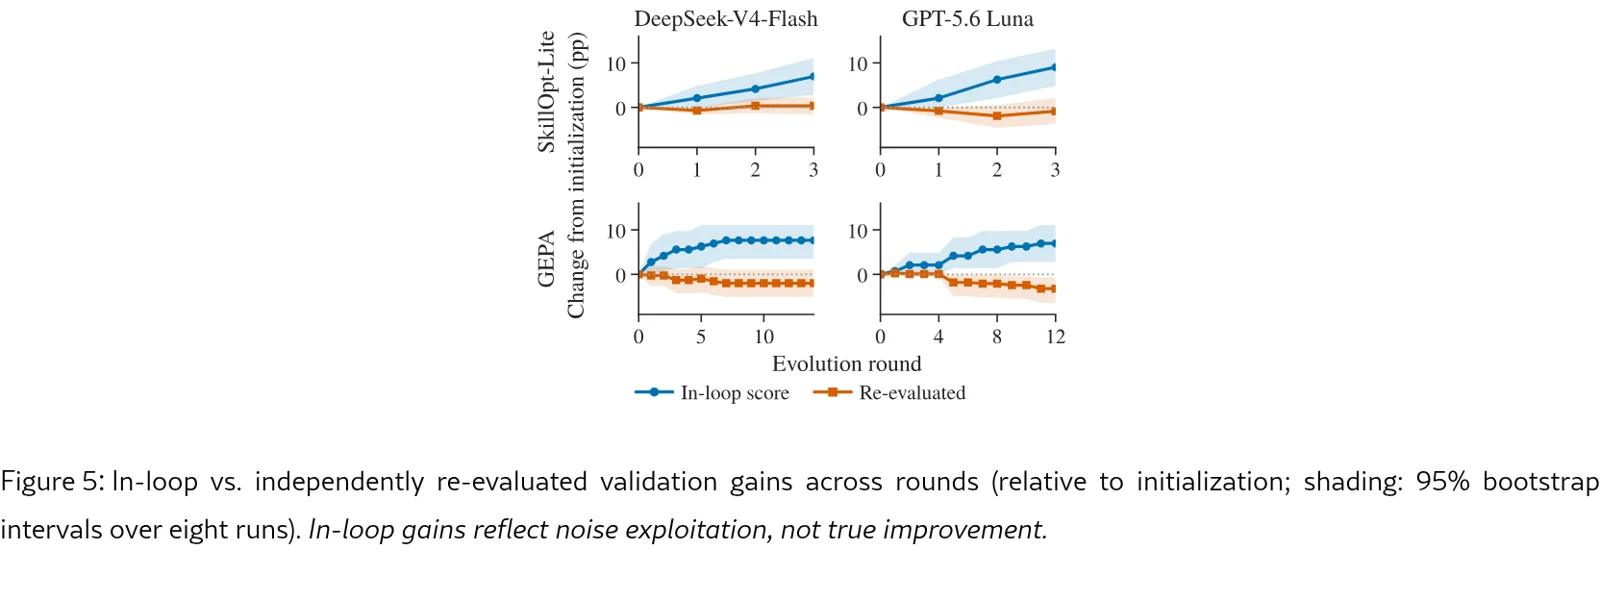
図:Resolution Hypothesis の Figure 5。青がループ内スコア、橙が独立した再評価。
おもちゃモデル:ノイズがどれだけあると選択が壊れるか
仕組みを見るために、小さなシミュレーションを書いた。各候補は真の成功率を δ だけ変え、δ は平均 −0.5、標準偏差 2.5 ポイントの正規分布に従う。多くの変更は少し悪く、少数が役に立つ。1 回の評価は「真の値 + ノイズ」を返し、ノイズの標準偏差を σ とする。σ = 4.5 は論文の Terminal-Bench での 1 回の評価ノイズに当たる。σ = 50 は成功率 50% のタスク 1 つを 1 回だけ pass/fail で走らせた場合に相当する。
[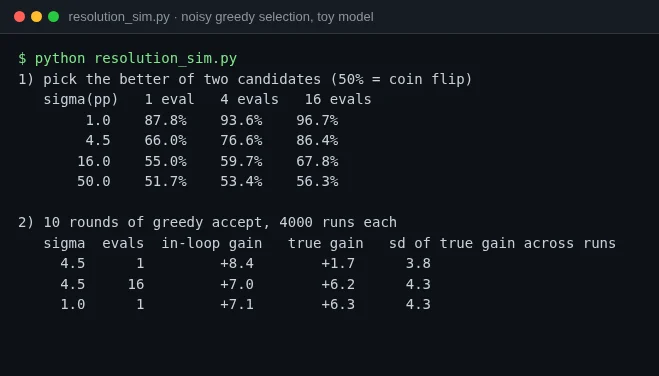
論文と合う結果が 2 つある。1 つ目に、選択の正答率は σ が大きくなると急速に 50% へ落ちる。論文の選択器は 1 つのタスクで 1 回のロールアウトを見ており、σ = 50 の行に近いので、49.7% は驚くことではない。2 つ目に、σ = 4.5 で各版を 1 回だけ評価して 10 ラウンド貪欲に採用すると、ループ内の点数は 8.4 ポイント上がるのに、真の品質は 1.7 ポイントしか上がらない。同じノイズでも各版を 16 回評価すると、真の伸びは 6.2 ポイントに戻る。ノイズを σ = 1 まで下げても同じ効果がある。このモデルは粗く、タスクの構造も抜け穴もない。それでも、ループ内の点数と本当の実力の差は主に 1 回ごとの評価の分解能で決まり、提案をいくら良くしても埋まらないことがわかる。
図:左は論文で測られた範囲、右はおもちゃモデル。どちらもループ内の伸びは 7〜9 ポイント。
論文は 2 つのレベルで対策を挙げる。候補レベルでは、pass/fail に加えて分散の小さい過程の指標を使う。たとえば「ファイルを編集した後にテストを走らせたか」「検証コマンドの失敗出力が隠されていないか」だ。こうした指標の評価ノイズは最終的な pass/fail より 13〜57 倍小さい。手法レベルでは、提案者と選択器を別々に評価する。提案者は Quality@K 曲線で、選択器は固定プールからどれだけ品質を取り戻せるかで測り、点数の横に σ と τ を並べて報告する。[1]
ELITE:選択が信用できないなら、ループの中で選ばない
ELITE と Resolution Hypothesis は別々の論文だが、並べて読むとよくつながる。ELITE の著者は、DGM や HGM のような手法を「evaluate-and-select」と呼ぶ。下流タスクの結果で、どの候補や系統が進化を続けるかを決めるやり方だ。これには 2 つのコストがある。候補ごとに対象タスクを走らせる必要があり、探索を広げるほど高くつく。そして同じ評価分布に向けて最適化を繰り返すと、そのベンチマークでしか効かないことを学びやすい。[2] ELITE の問いは、下流タスクの結果をまったく見ずに、コーディングエージェントが自分を改善できるか、だ。
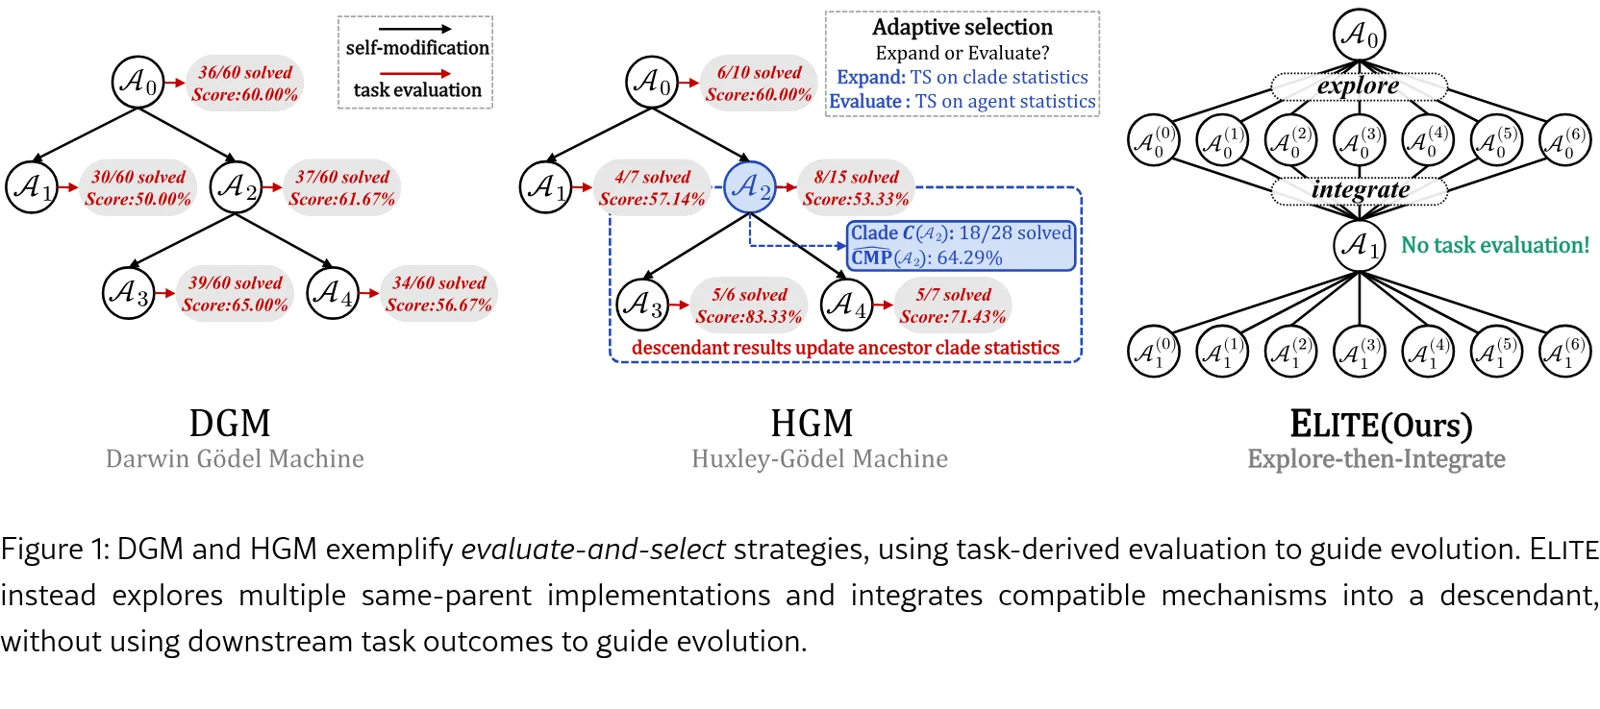
図:ELITE 論文の Figure 1。左の 2 手法は毎回タスクを走らせて点数を取り、右の ELITE は走らせない。
各世代は 2 段階からなる。探索段階では、LLM が現在のエージェントのソースコードと短い進化履歴を読み、焦点を絞った改善仮説を K 個(既定は 7 個)出す。各仮説には、改善したい能力、今のコードの具体的な欠点、直し方、何をもって完了とするかを書く。7 つの仮説は同じ親から別々に実装され、動く子が 7 つできる。各子はまず決定的なゲートを通る。コンパイルでき、インポートでき、必要なインターフェースを保ち、許された範囲だけを変更していることだ。[2]
統合段階では、LLM が合格したすべての子の仮説、パッチの要約、ゲートの結果を受け取り、必要ならパッチ全体を読む。そして各仕組みの関係を 5 つの観点で判断する。補完的か、重複か、衝突か、複雑すぎるか、未完成か。そのうえで、両立する仕組みの組を元の親の上に実装し直し、1 つの子を作る。パッチを機械的に重ねるのではない。その子は、ツール呼び出しのプロトコルと主な実行フローのスモークテストを加えた、より厳しいゲートを通らなければならない。通れば次の世代になり、通らなければ親が残る。[2] この過程のどこでも、ベンチマークの結果も、タスクの軌跡も、候補の点数も判断に使われない。
つまり ELITE の審査役は 2 つだ。「動くか」だけを見る決定的なチェックと、コードを読む LLM。ベンチマークの点数は事後に測るだけで、進化には戻らない。
結果:対象ベンチマークで並び、転移で上回り、ずっと安い
進化は SWE-bench Pro の固定 60 問の部分集合で行う。SWE-bench Verified と Polyglot は各 50 問(DGM の部分集合)で、転移テストにだけ使う。3 手法とも同じ初期エージェントから同じモデルで始める。DeepSeek-V4-Flash では各手法を 3 回ずつ走らせた。[2]
| Pro(60 問) | Verified(50 問) | Polyglot(50 問) | 進化中のタスク実行 | 時間 | 推定費用 | |
|---|---|---|---|---|---|---|
| 初期エージェント | 60.0 | 64.0 | 64.0 | |||
| DGM | 86.7 | 63.3 | 62.7 | 810 | 43.15 h | $45 |
| HGM | 88.3 | 65.3 | 64.7 | 800 | 15.66 h | $30 |
| ELITE | 85.6 | 73.3 | 69.3 | 0 | 4.90 h | $8 |
DGM と HGM は Pro で 27 ポイント近く伸びるが、Verified と Polyglot ではほぼ横ばいか少し下がる。ELITE は Pro での伸びが 1〜2 ポイント少なく、転移では 5〜10 ポイント上回る。Qwen-3.7-Plus でも傾向は同じで、Pro での差は広がる(45.6 に対して 50.0 と 48.3)が、転移では ELITE が一番良い。mini-swe-agent v2.4.6 と Claude Opus 5.5 から 10 ラウンド走らせると 6 つの子が採用され、Pro は 71.7 から 83.3、Verified は 70 から 78、Polyglot は 72 から 78 に上がった。[2]
アブレーションで目立つ結果が 2 つある。1 つ目に、決定的なゲートを外すと 3 ベンチマークの平均は 52.0 まで下がり、初期エージェントの 62.7 より低くなる。統合はコードを読む LLM に頼っているが、「動くか」という硬いチェックがないと、システムは自分を壊す。2 つ目に「評価ベースで 1 つを選ぶ」版は、同じく 7 つの子を作るが、毎回 30 問の Pro で採点して最高点のものを残す。Pro では 91.7 と全変種で最高だが、転移は 70.0 と 62.0 にとどまる。[2] 対象ベンチマークで選ぶと、対象の点数は最高、転移は最低になる。Resolution Hypothesis の予言どおりで、選択は能力ではなく評価に合わせている。
ELITE のコードはまだ公開されていない。論文にあるのはアルゴリズム、プロンプト、タスクの一覧なので、本稿では再実行できなかった。
同じ物差しで ELITE を測る
Resolution Hypothesis の基準を ELITE 自身の数字に当てると、いくつかの主張は割り引く必要がある。
Pro の部分集合は 60 問なので、1 問は 1.67 ポイントだ。ELITE の 85.6 と DGM の 86.7 の差は 1 問に満たず、実行ごとの標準偏差は 1.0〜1.7 ポイント。「並んだ」というのが正確な言い方だ。転移の差はもっと大きい。Verified では 73.3 対 63.3 で、50 問中 5 問に当たる。3 回の実行のばらつきは 1〜3 ポイントだけなので、この 10 ポイントは実行ノイズではない。しかし 50 問は固定の 1 組で、別の組でも差が残るかを論文は確かめていない。50 問をベンチマーク全体からの標本とみなすと、2 つの割合の差の標準誤差は約 9 ポイントで、差そのものとほぼ同じ大きさになる。
比較そのものも薄い。完全な ELITE とゲートなしの変種を除き、アブレーションはどれも 1 回だけで、著者も限界の節でそう書いている。Resolution Hypothesis の見積もりでは、ノイズの大きい SWE 系のベンチマークで数ポイントの差を見分けるには、手法ごとに十数回から二十数回の実行が要る。
それでも ELITE には構造上の利点が 1 つある。点数を一度も見ないので、採点器の欠陥に引っ張られない。上の LiveMath と SpreadsheetBench の例では、進化が学んだのは採点器の癖だった。ELITE のループにはそうした学ぶべき信号がない。リスクは別の場所に移る。LLM が「この 2 つの仕組みは補完的だ」と誤って判断するかもしれないし、決定的なゲートが保証するのは動くことだけで、良くなることではない。論文の Figure 3(b) では、採用された 5 回の更新のうち 2 回で Pro の点数が下がっており、著者もゲートは「下流タスクの改善を保証しない」と書いている。[2]
同じ週のほかの論文
今週の arXiv には、タイトルに self-improving、self-evolving、RSI を含む論文が数十本あり、多くは「自己進化」を特定の応用に当てはめたものだった。受け入れ判定に直接かかわるものがあと 3 本ある。
- GUARD(arXiv:2611.23476、11 月 17 日)は外部の採点器がない場面での harness の進化を扱う。各タスクをまず実行前の自己チェック項目に分け、その項目で軌跡を採点することで、「今回の変更で新しく壊れたもの」と「もともと解けていなかったもの」を区別し、習得済みのルールは固定する。Soft-HURT というゲートは、伸びが退行を上回るときだけ変更を通し、ゲート用のバッファでは退行しないことを保証する。[5] 考え方は、このサイトで取り上げた SAGE(英語)と同じで、合計点ではなく問題ごとの勝ち負けを見る。
- Self-Improvement Memory(arXiv:2611.18856、11 月 13 日)は harness の最適化器そのものにメモリを持たせ、変更ごとに理由、予測した結果、実際の結果、評価環境を記録する。コーディングでの 10 回の独立した元実行について対応のある比較をすると、平均 2.36 ポイント高い(p = 0.003)。[6] 対応のある検定を報告している数少ない研究で、2.36 ポイントはちょうど Resolution Hypothesis のいうノイズの帯に入るので、対応のある設計がこの結果を読めるものにしている。
- CompoundingKernel(arXiv:2611.19230、11 月 14 日)は GPU カーネルを自己進化的に書く。11 月 11 日時点で SOL-ExecBench の L1、L2、量子化のボードで 1 位、209 問の公開問題で参照実装より平均 4.40 倍速い。正しさはモデルの外のチェックが決め、著者は「探索の規模を制限するのはエージェントの数ではなく、信頼できる測定の速さだ」と結論している。[7] これは Resolution Hypothesis の限界の節と合う。プログラム進化は決定的なコードを採点し、安く並列に測り直せるので、伸びが積み上がる。
もう 1 つ大事な点がある。SAGE の伸びが最も大きい 2 つのベンチマークは LiveMath と OfficeQA(DeepSeek-V4 でそれぞれ 34.15 から 48.78、32.93 から 45.12)で、どちらも Resolution Hypothesis が抜け穴を見つけたベンチマークだ。[8][1] 監査の対象は SkillOpt-Lite が公開した版で、SAGE はテストしていない。SAGE のような対応のある統計的ゲートは、ノイズに乗った運の良い編集は止められる。しかし抜け穴は止められない。抜け穴による「勝ち」は、どの問題でも本物で再現できるからだ。修理した評価の下で SAGE の伸びがどれだけ残るかは、まだ誰も測っていない。
同じ週、政策の場でも RSI が話題になった。Anthropic は 11 月 10 日版の S-1 で、自社の Responsible Scaling Policy の「AI 研究開発能力」のしきい値に達したと判断したと書いた。根拠は現行モデルの観察ではなく、将来のモデルへの見通しだという。[9] これは本稿の技術的な問いとは別の層の話だが、「自己改善が本物だとどう確かめるか」が論文の中の方法論だけの問題ではなくなったことを示している。
筆者の見方
今週の 2 本は、一方が失敗の分析、もう一方が新手法だが、指している場所は同じだ。重みを固定し、外部のテキストやコードを進化させる種類のシステムでは、受け入れ判定の分解能が、本物の改善をどれだけ積み上げられるかを決める。提案の力はすでに十分ある。
Resolution Hypothesis は、今年の自己進化エージェントについての監査の中で最も役に立つものだと思う。この方向を否定しているのではなく、誰でも実行できる確認の手順を示している。σ と τ を報告する、1 ルールテストをする、採点器を直す、提案と選択を別々に評価する。限界もはっきり書かれている。候補プールの実験は Terminal-Bench だけで、最も強いモデルは Kimi-K3、より強いモデルではノイズが小さいかもしれず、重みを更新する手法は対象外だ。
ELITE は興味深い存在証明だ。ループの中で評価しなくても、コーディングエージェントを DGM・HGM と同じ水準まで改善でき、転移は良く、費用はずっと低い。ただし証拠の規模は小さい。60 問と 50 問、3 回の実行では数ポイントの差は見分けられず、Resolution Hypothesis の基準でいえば「転移で 10 ポイント上」を確かめるには、もっと多くの問題と実行が要る。本当の貢献は審査役を取り替えたことにある。騙されうる点数から、コードを読める LLM と決定的なチェックへ。この審査役に独自の系統的な偏りがあるかどうかは、次に誰かが専用に測るべきことだ。
来週このシリーズでは、Resolution Hypothesis のデータとコードが公開されたか、ELITE がオープンソース化されたか、そして修理した評価の下で SAGE や GEPA のような手法を走らせ直した人がいるかを追う。
参考文献
- Zeng et al., The Resolution Hypothesis: Agent Evolution’s Key Is Identifying Improvements, arXiv:2611.23068, 2026-11-17:https://arxiv.org/abs/2611.23068。プロジェクトページ:https://lineshogan.github.io/resolution-hypothesis/ ↩
- Ren et al., Evaluation-Free Recursive Self-Improvement for Coding Agents(ELITE), arXiv:2611.21056, 2026-11-16:https://arxiv.org/abs/2611.21056 ↩
- EvolvingLMMs-Lab/SkillOpt-Lite、コミット
4cb4eee(2026-07-22):https://github.com/EvolvingLMMs-Lab/SkillOpt-Lite。データ分割:https://huggingface.co/datasets/yshenaw/SkillOpt_Lite_Benchmarks ↩ - Zhang et al., Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents, arXiv:2505.22954:https://arxiv.org/abs/2505.22954 ↩
- Zhang et al., GUARD: Stabilizing Recursive Self-Improvement with Regret Guidance, arXiv:2611.23476, 2026-11-17:https://arxiv.org/abs/2611.23476 ↩
- Yu et al., Self-Improvement Memory Enables Continual Recursive Self-Improvement, arXiv:2611.18856, 2026-11-13:https://arxiv.org/abs/2611.18856 ↩
- Qu et al., CompoundingKernel: Self-Improving from Zero to First, arXiv:2611.19230, 2026-11-14:https://arxiv.org/abs/2611.19230 ↩
- Wang et al., SAGE: A Statistical Acceptance Gate for Self-Evolving Agents, arXiv:2609.36043:https://arxiv.org/abs/2609.36043。本サイトの解説(英語):SAGE: A Statistical Acceptance Gate for Self-Evolving Skills ↩
- Gizmodo, Anthropic Says Its Recursive Self-Improvement Alarm Has Been Triggered, 2026-11-16:https://gizmodo.com/anthropic-says-its-recursive-self-improvement-alarm-has-been-triggered-2000840253 ↩
本稿のテストスクリプト(livemath_shortcut.py、ssb_grader_demo.py、resolution_sim.py)は SkillOpt-Lite の公開データとコードだけを使い、モデルの API は呼んでいない。